Google Gemini en 2026: modelos, NotebookLM e integración con Workspace
Modelos de IA en este artículo
Gemini es el ecosistema de IA generativa de Google, y en febrero de 2026 ya se había convertido en la herramienta de referencia para las empresas que trabajan sobre los servicios de Google. Su ventaja se resume en dos cosas: trabaja dentro de Google Workspace (Docs, Sheets, Gmail, Drive) y accede a datos actualizados a través de Google Search.
Los modelos insignia admiten hasta 2 millones de tokens de contexto: suficiente para analizar de una sola vez años de correspondencia con un cliente o toda la documentación técnica de un producto.
Gemini funciona como una interfaz hacia tus propios datos. Ve los cambios en tus hojas de cálculo y documentos en el momento en que ocurren y participa en el trabajo allí donde ya sucede: en Docs, Sheets y Gmail.

Modelos de Gemini (septiembre de 2026)
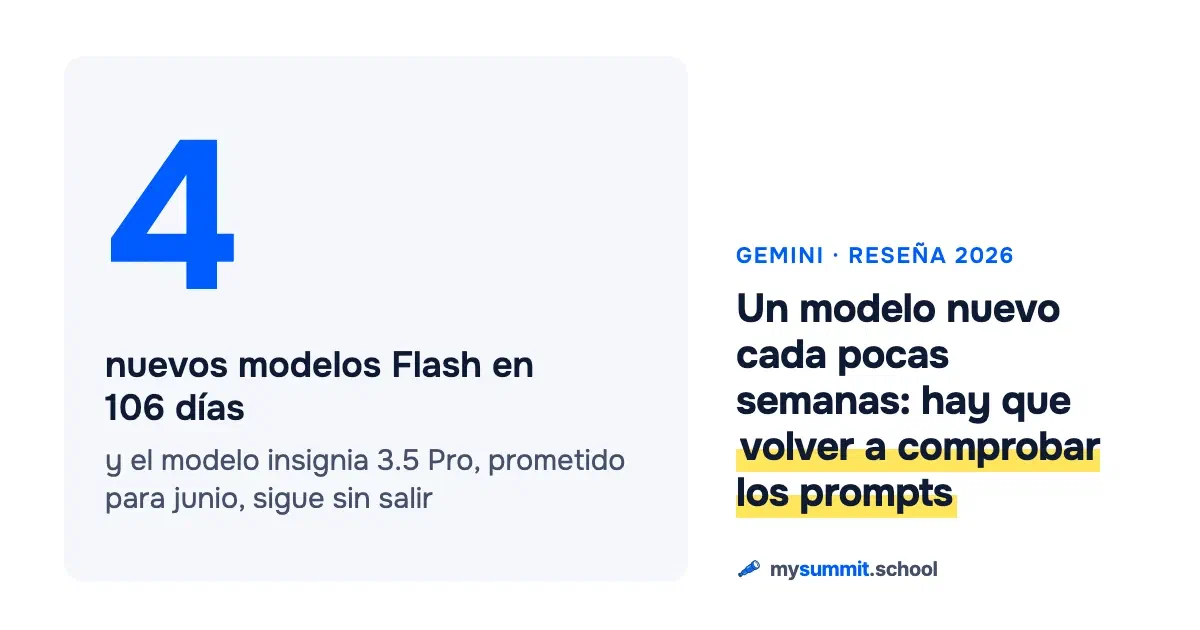
Desde el lanzamiento de 3.5 Flash a mediados de mayo hasta el 2 de septiembre pasaron 106 días. En ese tiempo Google publicó otros cuatro modelos Flash: 3.5 Flash-Lite, 3.6 Flash, 3.7 Flash y 3.8 Flash. El modelo insignia, Gemini 3.5 Pro, no está en esa lista. Sundar Pichai lo prometió para junio; en septiembre sigue figurando como «próximamente». Según The Wall Street Journal, los candidatos internos a modelo insignia no superaban a Flash por un margen que justificara lanzarlos.
Para quien compra, de aquí se desprende una conclusión concreta. Si necesitas un modelo de vanguardia precisamente de Google, hoy no hay nada que comprar. El modelo más potente de Google disponible por API salió en febrero; el más reciente cuesta varias veces menos y cubre la mayoría de las tareas del día a día.
| Fecha | Lanzamiento |
|---|---|
| 21 de julio | Gemini 3.6 Flash y 3.5 Flash-Lite en GA: mejor eficiencia de tokens, planificación más sólida en código y en flujos agénticos. Los parámetros temperature, top_p y top_k pasan a estar obsoletos. |
| 30 de julio | Gemini Robotics ER 2 en versión preliminar. |
| 13 de agosto | Gemini 3.7 Flash en GA, tres semanas después de 3.6 y con un precio de lanzamiento a la mitad. |
| 26 de agosto | Gemini 3.5 Transcribe y Transcribe Live en GA: reconocimiento de voz en más de 85 idiomas. |
| 27 de agosto | Gemini Omni Flash en GA (gemini-omni-1.1-flash): generación y edición de video. |
| 1 de septiembre | Comprensión agéntica de video para 3.7 Flash, 3.6 Flash y 3.5 Flash-Lite. |
| 2 de septiembre | Gemini 3.8 Flash en GA y 3.8 Flash Cyber. |
| 3 de septiembre | Lyria 3.5 en versión preliminar pública: generación de canciones completas. |
Gemini 3.8 Flash (2 de septiembre de 2026)
El modelo todavía no está en nuestro benchmark, así que los datos de abajo vienen de Google y de clasificaciones independientes.
Google lo presenta como su mejor modelo para razonamiento y código, con la misma velocidad y el mismo coste que 3.7 Flash. Las tarifas son 0,75 $ por millón de tokens de entrada y 3,75 $ de salida, pero se trata de un precio de lanzamiento: rige hasta el 31 de diciembre de 2026, y Google no ha publicado la tarifa normal a partir del 1 de enero. Un presupuesto para 2027 armado con el precio actual es una apuesta a que no va a cambiar.
En el Artificial Analysis Intelligence Index el modelo ocupa el séptimo puesto entre más de 250, con 47 puntos y un precio combinado de 0,74 $ por millón de tokens. En DeepSWE v1.1, una prueba de tareas de ingeniería autónomas, supera a la mayoría de los modelos de vanguardia más grandes, según la misma fuente. El índice se publica por versiones y se reescala cada cierto tiempo, así que solo tiene sentido comparar cifras de un mismo corte.
Una advertencia que conviene trasladar al equipo antes de implantarlo: en tareas reales, una consulta a 3.8 Flash cuesta alrededor de un 40 % más de lo que dice la tarifa, porque el modelo genera más tokens de salida y da más pasos agénticos. 0,75 $ es el precio del token. El precio de la tarea es más alto.
La velocidad es de 334 tokens por segundo de salida, frente a 40–90 del resto del top 10 de ese mismo índice. Ese dato nunca aparece en un informe de compras. En el trabajo diario, sin embargo, decide si alguien lee la respuesta hasta el final o se va a otra pestaña.
En la clasificación de texto de Arena.ai (antes LMArena), 3.8 Flash es octavo con 1.494 ± 9 puntos. Los nueve primeros se solapan dentro de sus intervalos de confianza: estadísticamente es un empate. Por qué ocurre esto lo explica el artículo Los benchmarks de IA pierden sentido, y la mecánica del cálculo, otro texto. Lo interesante del octavo puesto es la compañía: un modelo a 0,74 $ combinados comparte fila con los modelos insignia de Anthropic y Meta, que cuestan varias veces más.
Dónde conseguirlo: la app de Gemini para suscriptores Pro y Ultra, AI Mode en la búsqueda de Google y Google Sheets. Para desarrolladores, AI Studio, Android Studio y Google Antigravity. Para empresas, Gemini Enterprise.
Gemini 3.8 Flash Cyber
Una versión para tareas de seguridad. En CyberGym resuelve más del 70 % de las tareas de búsqueda de vulnerabilidades reales en 20 lenguajes de programación; son datos de Google, sin verificación independiente. El modelo no está a la venta: solo se distribuye a través del programa Fairwind, para gobiernos y operadores de infraestructuras críticas. No sirve para planificar un proyecto comercial.
3.7 Flash, 3.6 Flash y 3.5 Flash-Lite
3.7 Flash salió el 13 de agosto, tres semanas después de 3.6, con un precio de lanzamiento a la mitad del de su predecesor. Google afirma mejoras en depuración, resolución de incidentes y precisión del código al primer intento. 3.6 Flash y 3.5 Flash-Lite salieron el 21 de julio, directamente en GA.
Ninguno de los tres está todavía en nuestro benchmark; las cifras anteriores son del fabricante.
Cuatro modelos en 106 días: el coste operativo
El ritmo de lanzamientos es una partida de gasto que no aparece en la lista de precios. Los prompts ajustados para 3.6 Flash no garantizan el mismo comportamiento en 3.8: cambian los modelos y cambia la API. Por el camino quedaron obsoletos temperature, top_p y top_k, justo los parámetros con los que los equipos suelen fijar el estilo y la previsibilidad de las respuestas.
Estandarizar hoy un equipo en los modelos de Google significa estandarizarlo en una línea que se renueva cada pocas semanas. Lo que funciona es dividir el proyecto en dos capas: por un lado, los flujos y prompts que pruebas y guardas en tu lado; por otro, el modelo que hay debajo, que se puede sustituir en un día. Antes de cada sustitución, vuelve a ejecutar tu batería de tareas y compárala con la ejecución anterior.
Gemini 3.5 Flash (mayo de 2026)
 Gemini 3.5 FlashAnaliza los detalles
puntuación 7,7/10 puesto 23 de 47 $0,027 por tarea requiere VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
Gemini 3.5 Flash fue el gran anuncio de Google I/O 2026 (19 de mayo). Salió directamente en GA (General Availability), sin periodo de versión preliminar. Google lo posiciona como un modelo Flash con inteligencia de nivel Pro.
Características principales:
- Velocidad: unos 289 tokens por segundo, aproximadamente 4 veces más rápido que modelos de vanguardia comparables
- Contexto: 1 millón de tokens de entrada, hasta 65.536 tokens de salida
- Multimodalidad: texto, imágenes, audio, video y PDF de entrada (pero no genera imágenes ni audio)
- 4 niveles de razonamiento: minimal, low, medium (ahora por defecto) y high. Sustituyen al antiguo
thinking_budgetnumérico - Conservación del contexto de razonamiento entre mensajes de una conversación (activada por defecto)
- Orquestación de herramientas integrada: Google Search, Maps, contexto de URL, ejecución de código y funciones personalizadas se ejecutan en paralelo en una sola llamada a la API
Según Google y clasificaciones independientes, Flash lidera en tareas agénticas y multimodales, pero queda por detrás de GPT-5.5 en razonamiento (ARC-AGI-2) y en tareas de código complejas (SWE-bench). No copiamos aquí las puntuaciones de benchmarks externos porque envejecen rápido; la comparación actualizada con la competencia está en la ficha del modelo de arriba y en el bloque comparativo de más abajo.
Por API, 3.5 Flash cuesta más que el anterior Gemini 3 Flash y menos que Gemini 3.1 Pro; las tarifas actuales están en la ficha del modelo de arriba. Para los usuarios finales, la suscripción no cambió. Desde el otoño, 3.5 Flash ya no es el modelo más rentable de la línea: 3.8 Flash cuesta la mitad tanto en entrada como en salida.
Gemini 3.5 Pro: prometido, pero sin lanzar
Google presentó su modelo principal en el mismo I/O del 19 de mayo y prometió lanzarlo «en junio». En septiembre sigue sin versión pública: Pro está disponible para empleados de Google y un grupo reducido de probadores corporativos, y el estado oficial es «próximamente».
Lo que se promete para cuando salga:
- Contexto de 2 millones de tokens y un modo Deep Think para los razonamientos más complejos.
- Pro asumirá las tareas que antes exigían el caro plan Ultra: análisis multimodal profundo, contexto muy largo, razonamiento pesado.
- Precio esperado por API: unos 15 $ / 60 $ por millón de tokens, alrededor de 10 veces más que 3.5 Flash. Llegará primero a las suscripciones Pro y Ultra.
No se puede planificar una implantación en torno a esa fecha, porque el fabricante no la da. Si necesitas un modelo de vanguardia para un plazo concreto, tendrás que comprárselo a otro. Si el plazo puede esperar, lo sensato es montar el flujo sobre 3.8 Flash y tratar el paso a Pro como una tarea aparte, con su propio presupuesto para volver a probar.
Gemini 3.1 Pro
Gemini 3.1 ProEntiende tareas simples
puntuación 7,3/10 puesto 30 de 47 $0,027 por tarea requiere VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
Gemini 3.1 Pro (febrero de 2026) es el modelo insignia de Google para planificación compleja y análisis multimodal. Frente a la versión 3.0, incorpora una arquitectura Long-Context Reasoning: en todo su contexto de 2 millones de tokens conecta documentos dispersos casi sin pérdida de precisión, según las mediciones de Google. En septiembre de 2026 es el modelo más potente que Google vende por API, y ya tiene siete meses.
Mejoras clave para un manager:
- En el modo Deep Think 2.0, el modelo verifica sus conclusiones con fuentes externas en tres etapas, lo que lo hace más fiable en auditorías financieras y jurídicas.
- 3.1 Pro puede ejecutar por su cuenta tareas de varios pasos en Workspace, por ejemplo: «Reúne todas las facturas del trimestre en el correo, cotéjalas con la hoja de gastos de Sheets y crea un borrador de informe en Docs señalando las discrepancias».
- El modelo analiza horas de grabaciones de conferencias y detecta no solo lo que se dijo, sino también el tono emocional de los participantes (análisis de sentimiento).
Gemini 3 Flash
Gemini 3 FlashEntiende tareas simples
puntuación 6,8/10 puesto 40 de 47 $0,001 por tarea requiere VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
Un modelo ultrarrápido con contexto de 1 millón de tokens. Usa un 30 % menos de «tokens de razonamiento» que las versiones anteriores. Encaja en operaciones rutinarias: resumir reuniones largas, analizar la actualidad informativa, procesar grandes volúmenes de mensajes entrantes. Sacrifica profundidad de análisis a cambio de velocidad.
Flash-Lite: los modelos más baratos de la línea
Gemini 3.1 Flash LiteRequiere supervisión
puntuación 6,2/10 puesto 44 de 47 $0,000 por tarea requiere VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
3.1 Flash-Lite lleva tiempo en nuestro benchmark, y el 21 de julio se le sumó 3.5 Flash-Lite en GA, que todavía no hemos probado. Flash-Lite se elige cuando importa más el coste de mil consultas procesadas que la calidad de una respuesta concreta: clasificar entrantes, etiquetado inicial, resúmenes en borrador. Desde el 1 de septiembre, los tres modelos Flash admiten comprensión agéntica de video, así que el análisis de grabaciones ya está disponible incluso en el modelo más barato de la línea.
Gemini 2.5 Pro
El anterior modelo insignia, que sigue vigente gracias a su equilibrio entre precio y calidad. Fue este modelo, con la función Deep Think, el que ganó una medalla de oro en la Olimpiada Internacional de Matemáticas de 2025. Se usa a menudo como modelo base en las suscripciones corporativas.
Gemma 4: modelos abiertos (abril de 2026)
La nueva generación de modelos abiertos de Google, basada en la investigación de Gemini 3. Cuatro tamaños: E2B y E4B para dispositivos móviles, 26B MoE (Mixture of Experts, 128 expertos pequeños; solo se activan 3.800 millones de parámetros por token) y 31B Dense para servidores y estaciones de trabajo.
Gemma 4 31BEntiende tareas simples
puntuación 6,9/10 puesto 38 de 47 $0,001 por tarea requiere VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
Gemma 4 26B MoEEntiende tareas simples
puntuación 6,6/10 puesto 42 de 47 $0,001 por tarea requiere VPN
Probado en el benchmark de mysummit.school: mayo 2026Sobre el modelo →Comparar →
Diferencias clave con Gemma 3:
- Contexto de hasta 256K tokens (antes 128K) en los modelos de servidor, 128K en los móviles
- Procesamiento nativo de video e imágenes: OCR, análisis de gráficos, resolución variable
- Un salto de calidad: en AIME (razonamiento matemático) y LiveCodeBench (programación), la cuarta generación supera varias veces a la tercera, según Google
- Licencia Apache 2.0: Google abandonó su licencia propia de Gemma. Las condiciones son ahora las mismas que las de Qwen y Mistral: sin restricciones de uso comercial ni de redistribución
- En Arena AI, las dos versiones mayores están en la parte alta de la lista de modelos abiertos, y 26B MoE supera a modelos con 20 veces más parámetros
Gemma 4 es la opción cuando los datos no pueden salir a la nube: documentos confidenciales o la obligación de mantener los datos dentro de la empresa. E4B funciona en un smartphone; 31B, en un portátil normal con 16 GB de RAM si se cuantiza.
Video, audio y transcripción: agosto y septiembre
Hasta el 1 de septiembre, el modelo procesaba un video entero: cada fotograma y cada segundo de audio entraban en el contexto, y todo se pagaba. La comprensión agéntica de video en 3.7 Flash, 3.6 Flash y 3.5 Flash-Lite funciona de otra manera: el modelo consulta la grabación de forma selectiva y, según lo que necesite, toma la transcripción, un fotograma concreto o un fragmento de audio. En contenido largo, Google promete hasta un 88 % menos de tokens.
Para el presupuesto es una partida directa. Una hora de grabación de una reunión con un cliente o de un curso de formación costaba lo mismo que todo su metraje. Ahora pagas por los fragmentos que el modelo consultó de verdad. Conviene comprobar la promesa con tus propias grabaciones: el 88 % es el techo para contenido largo, no un promedio que puedas esperar en tus tareas.
Gemini 3.5 Transcribe y Transcribe Live (26 de agosto, GA) son un producto aparte de reconocimiento de voz: más de 85 idiomas, separación por hablantes, marcas de tiempo a nivel de palabra y un vocabulario propio de hasta 1.000 términos. Para transcribir reuniones, entrevistas e investigación de campo, quita la mitad del trabajo manual, y el vocabulario propio elimina además la principal fuente de errores: nombres de productos, apellidos y siglas internas empiezan a reconocerse bien.
Gemini Omni Flash (27 de agosto, GA, gemini-omni-1.1-flash) cubre la generación y edición de video: continuar un clip, hacer una transición entre dos imágenes, resoluciones de 360p a 4K. Lyria 3.5 (3 de septiembre, versión preliminar pública) genera canciones completas a partir de texto e imagen, en estéreo a 44,1 kHz.
Modelos visuales
Veo 3.1 es un modelo de vanguardia para generar video y presentaciones dinámicas. La versión 3.1 añade la «dirección interactiva»: puedes ajustar detalles del video en tiempo real.
Gemini 3 mejoró mucho la generación de imágenes, hasta el punto de crear infografías realistas a petición.


Un video o una infografía generados parecen listos para publicar. Revisarlos no es igual de rápido: el modelo dibuja con total seguridad cifras que no estaban en tus datos y añade detalles que no pediste. Cuanto más convincente es el resultado, más cara sale una equivocación que se cuela, y más pesa saber plantear bien la tarea.
NotebookLM: respuestas a partir de tus documentos
NotebookLM es probablemente la herramienta más potente de Google para el trabajo a fondo con el conocimiento. A diferencia de un chat normal, trabaja solo con los documentos que tú le cargas (modo de «anclaje»): las respuestas se apoyan en tus materiales y no salen del cuaderno.

Para un manager, esto se traduce en:
- Audio Overview (pódcasts con IA): convierte un aburrido informe anual de 50 páginas o la estrategia de la empresa en un diálogo de 10 minutos entre dos expertos para escuchar de camino a la oficina.
- Análisis de feedback: sube los resultados de una encuesta de compromiso (eNPS) y NotebookLM encontrará patrones ocultos: «¿Qué es lo que de verdad preocupa a la gente de marketing?».
- Base de conocimiento del equipo: crea una guía de incorporación fácil de ampliar; los recién llegados preguntan por los procesos internos y reciben respuestas con referencias a puntos concretos de vuestros procedimientos.
Custom Gems: Gemini para un rol concreto
Los Gems son versiones personalizadas de Gemini que se configuran para un rol concreto. Le explicas una vez al Gem su tarea, su estilo de comunicación y el contexto, y queda listo para trabajar.

Ejemplos de Gems para un responsable de equipo:
- Onboarding Buddy: explica a los nuevos empleados la cultura de la empresa y sus primeras tareas.
- Feedback Coach: prepara al manager para una conversación difícil y reformula las críticas como recomendaciones constructivas.
- Interview Assistant: genera preguntas de entrevista a partir de la descripción del puesto y el CV del candidato, y luego ayuda a comparar las respuestas de distintos aspirantes.
La app de Gemini: septiembre de 2026
La oleada de novedades de la app presentada en Google I/O el 19 de mayo llegó a los usuarios en septiembre. Para un manager, lo más interesante son las funciones agénticas.
- Daily Brief: un resumen matinal personal. Gemini reúne lo importante del correo, el calendario y las tareas y muestra las prioridades del día. Se está desplegando para suscriptores de Google AI en Estados Unidos.
- Gemini Spark: un agente personal que trabaja en segundo plano 24/7, incluso con el teléfono bloqueado, y lleva tus flujos hasta el final. Se lanza para suscriptores Ultra.
- Gemini Omni: generación de video a partir de indicaciones de texto, audio e imagen en Google Flow y YouTube Shorts; desde el 27 de agosto, Omni Flash está en GA, con edición y continuación de clips.
- La nueva interfaz Neural Expressive: las respuestas ya no son un bloque de texto; lo principal aparece arriba en negrita y los detalles se despliegan al desplazarse.
- 3.5 Flash por defecto: desde el 8 de junio, 3.5 Flash es el modelo por defecto en la app corporativa Gemini Enterprise y no se puede desactivar. Con la llegada de 3.8 Flash, la lista de modelos del entorno corporativo se está actualizando, así que antes de investigar por qué «las respuestas empeoraron», comprueba qué modelo está respondiendo.
La combinación de Daily Brief y Gemini Spark convierte a Gemini de un chat en un asistente en segundo plano: el resumen matinal llega solo y los flujos rutinarios se completan sin tu intervención. La calidad del resultado, eso sí, depende por completo de lo bien que hayas descrito el flujo.
Ventajas para un manager
- Integración con Workspace: Gemini está integrado en Google Docs y Gmail. Encuentra el correo que buscas, resume un hilo largo en Chat, extrae cifras de una hoja de cálculo y las inserta directamente en el borrador de un documento.
- Un contexto enorme (2 millones de tokens): puedes cargar el video de un taller largo o las grabaciones de reuniones de todo un trimestre y pedir: «Haz un resumen de todos los acuerdos en los que se habló de presupuestos».
- Datos actuales: gracias a su conexión directa con Google Search, Gemini conoce los últimos cambios en la legislación laboral o las tendencias del mercado de trabajo «a día de hoy»; los datos vienen de la búsqueda, no de la fecha de corte de su entrenamiento.
- Google Vids: crea automáticamente videos de formación interna y clips para el equipo a partir de guiones de texto y materiales de Drive.

Casos prácticos
- Gemini 3.8 Flash: el modelo principal de este otoño. Análisis de documentos, flujos agénticos (búsqueda y procesamiento de datos en paralelo en una sola consulta), procesamiento multimodal rápido. Presupuesta alrededor de un 40 % más del precio de tarifa: para la misma tarea, el modelo gasta más tokens de salida.
- Gemini 3.5 Flash: sigue siendo una opción versátil para las mismas tareas, pero desde septiembre conviene elegirlo con conocimiento de causa: 3.8 Flash es más barato y, según Artificial Analysis, más potente.
- Gemini 3.1 Pro: análisis de la competencia (recopilación de datos web y análisis de informes en PDF), preparación de evaluaciones de desempeño (logros de un empleado en Docs y Gmail durante seis meses), auditoría de seguridad de los procesos del equipo.
- Gemini 3 Flash: resúmenes instantáneos de reuniones de Meet que te perdiste, ideas para team building, clasificación y priorización del correo entrante. Con 3.5 y 3.8 Flash en el mercado, tiene sentido sobre todo cuando el coste mínimo es decisivo.
- Comprensión agéntica de video: análisis de grabaciones de reuniones, llamadas con clientes y cursos de formación. El modelo toma los fotogramas y fragmentos de transcripción que necesita en lugar de procesar todo el metraje.
- Gemini 3.5 Transcribe: transcripción de entrevistas y reuniones con separación por hablantes y vocabulario propio.
- Project Mariner (plan Ultra): gestión autónoma del calendario, reserva de salas y organización de viajes del equipo con criterios complejos.
- NotebookLM: un resumen interactivo de la estrategia trimestral para todo el equipo.
Estos casos dan la impresión de que basta con elegir un modelo y pegar un prompt. La diferencia aparece después: un resumen que puedes enseñarle al director financiero y un resumen «más o menos sobre el tema» se piden de forma distinta. Lo que separa «el modelo respondió» de «el resultado sirve para trabajar» es cómo se plantea la tarea, y es una habilidad que se entrena con tus propias tareas.
Pruébalo tú: plan de incorporación y desarrollo de un empleado
Tú
Eres HR business partner en una empresa de IT de 300 personas. Elabora un plan de incorporación de 90 días para un nuevo team lead que llega de otra empresa.

## Contexto
- Equipo: 6 desarrolladores, 1 QA, 1 analista
- 2 personas del equipo también optaban a este puesto
- En 60 días se lanza un producto nuevo
- El team lead tiene una sólida base técnica, pero ninguna experiencia gestionando personas

## Tarea
1. Divide los 90 días en fases con objetivos concretos para cada semana
2. Para cada fase: qué habilidades debe desarrollar el team lead y cómo medirlas
3. Cómo gestionar a los dos candidatos «descartados»: pasos concretos en las 2 primeras semanas
4. Qué señales tempranas indicarán que la incorporación no va según lo previsto
5. Ten en cuenta la fecha del producto: qué hacer si la formación choca con el lanzamiento
En qué fijarse: la planificación es la categoría fuerte de Gemini en nuestro benchmark, y la formación y el desarrollo de empleados, la débil. El modelo armará con soltura la estructura semana a semana, pero trabajará el programa de desarrollo peor que sus competidores. DeepSeek V4 Pro es interesante como alternativa económica con un nivel de planificación comparable. GPT-5.6 suele profundizar más en la gestión de personas.
Resultados en nuestro benchmark
Probamos los modelos Gemini en tareas reales de gestión: planificación, comunicación, trabajo en equipo, formación y desarrollo, y conocimiento del contexto regional. Los resultados son desiguales.
El modelo de trabajo actual de Google, Gemini 3.5 Flash, ya forma parte del benchmark; su puntuación, su posición y su precio por tarea están en la ficha del modelo de arriba. Los lanzamientos de otoño no están en nuestros datos: 3.6, 3.7 y 3.8 Flash aparecerán cuando los ejecutemos con la misma batería de tareas, y todo lo que se dice de ellos más arriba se basa en Google, Artificial Analysis y Arena.ai.
- Information search7,3
- Data analysis7,4
- Decisions under uncertainty7,8
- Feedback analysis8,2
- Corporate requirements and risks7,3
- Automation7,2
- People management8,2
- Russia and Kazakhstan specifics7,8
El radar muestra el perfil del modelo en ocho categorías: la línea Gemini destaca en planificación y comunicación, mientras que la formación y el desarrollo de empleados flojean de forma sistemática.
Gemini 2.5 Pro es un sólido modelo de mitad de tabla. Planifica bien y conoce sorprendentemente bien el contexto regional. Pero en formación y desarrollo de empleados obtiene uno de los resultados más débiles entre los grandes modelos. La comunicación está en la media.
2.5 Flash casi no se queda atrás de la versión Pro, lo cual ya es llamativo: el modelo optimizado para la velocidad sacrifica muy poca calidad. Conoce el contexto regional igual de bien. En cambio, en gestión de equipos fracasa: uno de los peores resultados de la prueba.
La paradoja de Gemini 3 Flash: más nuevo no significa mejor. En tareas de gestión, este modelo es más débil que las dos versiones 2.5. Se defiende en comunicación y planificación, pero la formación y la gestión de equipos son sus puntos débiles.
El patrón se mantiene: Gemini se compra por el ecosistema. En calidad de respuesta a tareas de gestión, la competencia ofrece más, como se ve en nuestras fichas y en las clasificaciones independientes citadas arriba. En acceso a Docs, Sheets y Gmail, Google no tiene rival. Si eliges Gemini para tener la IA «más inteligente», pagas de más por algo que no es su fuerte. Si lo eliges para trabajar con los documentos de tu equipo, sigue siendo la mejor opción.
Resultados interactivos completos ->
Planes de Gemini (septiembre de 2026)
- Gratis: acceso a los modelos Flash de Google (con límites diarios), generación básica de imágenes, integración con Google Docs y Drive.
- Google AI Pro (19,99 $/mes): acceso completo a los modelos actuales, incluidos 3.8 Flash y 3.1 Pro, ventana de contexto ampliada (1M+), Gemini integrado en Workspace, 2 TB de almacenamiento.
- Google One AI Premium (100 $/mes): un plan nuevo que apareció con 3.5. Límites más altos, acceso prioritario a los nuevos modelos Flash y al futuro 3.5 Pro.
- Gemini Enterprise (30 $/usuario/mes): seguridad corporativa, acceso prioritario a los modelos, creación de agentes propios y la plataforma Google Antigravity 2.0 para automatizar la infraestructura de TI.
- Google AI Ultra (199,99 $/mes): rebajado desde 249,99 $. Límites máximos, acceso a Veo 3.1, Deep Think sin restricciones, el agente Project Mariner para automatizar acciones en el navegador y acceso exclusivo a Gemini Spark (el agente en segundo plano).
Por API, el panorama es distinto y menos cómodo para planificar. Hasta el 31 de diciembre de 2026, 3.8 Flash cuesta 0,75 $ / 3,75 $ por millón de tokens, y es un precio de lanzamiento: Google no ha publicado la tarifa normal. 3.7 Flash salió a la mitad de precio que 3.6. Con estas condiciones no se puede armar un presupuesto anual, y eso vale para toda la línea.
El mapa precio-calidad de nuestro benchmark muestra dónde se sitúan los modelos de Google que hemos llegado a probar. Los lanzamientos de otoño no están: 3.8 Flash, con sus 0,74 $ combinados y 334 tokens por segundo, habría que dibujarlo a mano con los datos de Artificial Analysis.
Limitaciones
- Dependencia del ecosistema: Gemini da todo su valor solo dentro de Google Workspace. Si tu empresa trabaja con Microsoft 365, buena parte de las ventajas se pierde.
- No hay modelo insignia: el modelo más potente de Google en la API salió en febrero, y el fabricante no dice cuándo llegará el siguiente. Para tareas de vanguardia, Google no es una opción ahora mismo.
- Precios temporales: las tarifas de lanzamiento de 3.8 Flash rigen hasta el 31 de diciembre de 2026, no hay tarifas normales y el coste real de una consulta es alrededor de un 40 % superior al de tarifa.
- Ritmo de lanzamientos: cuatro modelos Flash en 106 días y parámetros de muestreo obsoletos; habrá que volver a comprobar los prompts en cada migración.
- Coste del plan Ultra: 199,99 $/mes, uno de los planes más caros del mercado, solo justificado con un uso intensivo de Veo 3.1, Project Mariner y Gemini Spark.
- Idiomas distintos del inglés: la calidad de las respuestas en otros idiomas (nosotros probamos el ruso) sigue por debajo del inglés, aunque la brecha se reduce con cada actualización.
- Disponibilidad: el estado de acceso actual de cada modelo está en las fichas de arriba, y algunas funciones de la app, como Daily Brief, llegan primero a los suscriptores de Estados Unidos. Si Google no encaja con tus requisitos, compara con DeepSeek y GLM-5.
Este otoño la historia tiene dos incógnitas: ¿saldrá 3.5 Pro antes de fin de año? ¿Y cómo serán las tarifas normales de 3.8 Flash a partir del 1 de enero? Las dos influyen en el presupuesto más que cualquier puesto en una clasificación.
Otras partes de esta serie
 Parte 1
ChatGPT en 2026: qué ha cambiado y por dónde empezar si eres manager
 Parte 2
Claude de Anthropic en 2026: Opus 5, Fable 5.1, Mythos 5.1, Cowork y Chrome – guía para managers
 Parte 3
Perplexity AI en 2026: el buscador inteligente que todo manager debería probar
 Parte 5
Grok de SpaceXAI en 2026: análisis de la IA de Elon Musk
 Parte 6
YandexGPT en 2026: análisis de la IA rusa de Yandex para empresas
 Parte 7
DeepSeek en 2026: análisis de V4-Pro y V4-Flash tras la subida de precios
 Parte 8
GigaChat en 2026: análisis honesto – ¿vale la pena usarlo para el trabajo?
 Parte 9
Qwen de Alibaba en 2026: los pesos abiertos vuelven a los modelos insignia
 Parte 10
Cómo se evalúa la calidad de los LLM en 2026: guía de benchmarks para managers
 Parte 11
IA para crear contenido multimedia en 2026: imágenes, vídeo, música y presentaciones
 Parte 12
Comparativa de herramientas GenAI 2026: ¿qué IA debe elegir un manager?
 Parte 13
Chat Z.AI (GLM-5) en 2026: el modelo chino que finge ser Claude
 Parte 14
Kimi de Moonshot en 2026: K3, K2.6, K2.7-Code y agentes
 Parte 15
GigaChat en el trabajo: cómo sacar el máximo a la IA soberana rusa
 Parte 16
Los benchmarks de IA pierden sentido: ¿cómo elegir un modelo entonces?
 Parte 17
Meta Muse Spark: el primer modelo cerrado de Meta desde 2023
 Parte 18
Modelos MAI de Microsoft en 2026: qué se puede usar de verdad y cuánto cuesta
 Parte 19
Agentes de código en 2026: dos formatos, el terminal y el escritorio
Enlaces útiles

18 anos liderando equipos de ingenieria. Fundador de mysummit.school. 700+ graduados en Yandex Practicum y Stratoplan.