Chat Z.AI (GLM-5) en 2026: el modelo chino que finge ser Claude

AI-модели в этой статье
El 6 de febrero de 2026 apareció en OpenRouter un modelo anónimo llamado «Pony Alpha»: gratuito y sin ningún dato sobre quién lo había creado. La comunidad de IA se puso de inmediato a averiguarlo. En programación se acercaba mucho a Claude Opus 4.5. Si le preguntabas «¿quién eres?», respondía: «Soy GLM». Pero cuando le pidieron una página web que lo describiera, escribió: «I am Claude, created by Anthropic».
Pasaba siempre, sin excepción. Y ese detalle condiciona todo lo que hay que saber sobre GLM-5 antes de llegar a los benchmarks y las tarifas.
Pruébalo tú mismo: GLM-5.3 vs GigaChat 3.5 vs Claude Sonnet 5
Antes de la historia, los benchmarks y los precios, lanza un prompt aquí mismo y compara tres modelos en la misma tarea: GLM-5.3 (Z.ai), GigaChat 3.5 Ultra (Sber, el mayor banco de Rusia) y Claude Sonnet 5 (Anthropic). Tres apuestas muy distintas: el aspirante chino barato, un modelo ruso pensado para su mercado local y el buque insignia premium occidental.
Ejemplo 1. Una carta delicada a un proveedor
Esta tarea pone a prueba a la vez el idioma, el sentido del tono y la etiqueta profesional. GigaChat está entrenado sobre todo para el ruso y tiende a un registro más rígido, Claude suele equilibrar empatía y claridad, y GLM-5.3 es el caso interesante: ¿hasta dónde llega un modelo chino con una carta comercial en español? Más abajo hay un segundo prompt, analítico, donde los puntos fuertes se reparten de otra manera.
Qué es GLM-5 y quién está detrás

Zhipu AI nació en la Universidad de Tsinghua. Fundada en 2019, pasó a llamarse Z.ai en 2025 y salió a la Bolsa de Hong Kong en enero de 2026. La OPV fue un éxito: en los tres días posteriores al anuncio oficial de GLM-5, la acción subió un 60 %.
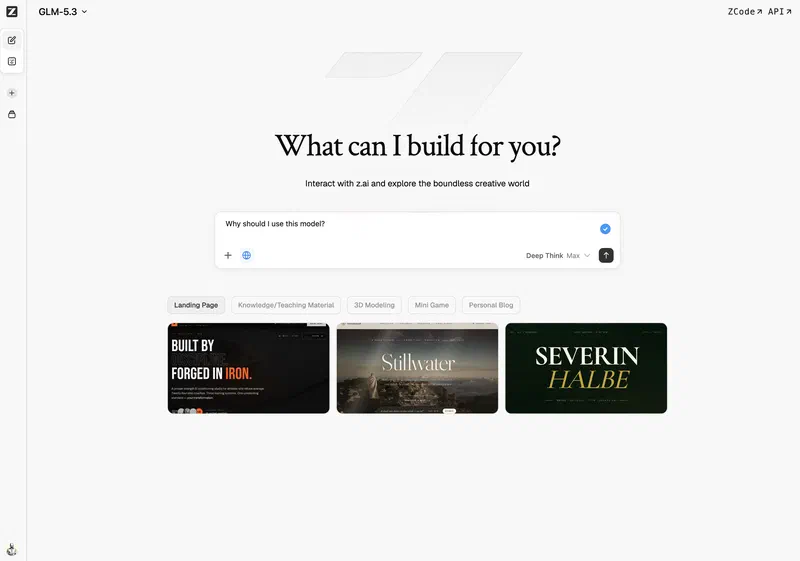
GLM-5 salió el 11 de febrero de 2026 y reclamó de entrada el título de modelo abierto más potente del mundo. Para un manager, importan tres cosas:
- Abierto y gratuito: el código está disponible con licencia MIT; cualquier empresa puede descargar el modelo y ejecutarlo en sus propios servidores
- Contexto largo: una sola consulta «lee» hasta unas 400 páginas de texto, útil para documentos largos, informes y contratos
- Entrenado con chips chinos: íntegramente sobre hardware de Huawei, sin un solo componente de NVIDIA
Con las restricciones de exportación de EE. UU. de fondo, este último punto se lee como una declaración política: China puede crear modelos de IA competitivos sin acceso a chips occidentales. Para una empresa, significa que el proveedor no depende de las sanciones occidentales, a diferencia de OpenAI o Anthropic.
GLM-5.2: una nueva generación (13 de junio de 2026)
Mientras GLM-5 todavía se estaba analizando, Z.ai lanzó la siguiente versión. GLM-5.2 salió el 13 de junio de 2026 y está pensado para programar.
- Contexto de 1 millón de tokens (frente a 200.000 en la versión anterior): el modelo mantiene en memoria un repositorio entero sin perder el hilo.
- Arquitectura MoE de 744.000 millones de parámetros, de los que solo 40.000 millones están activos por token: de ahí la combinación de potencia y precio moderado.
- Pesos abiertos con licencia MIT y dos niveles de razonamiento, High y Max (Max está pensado para tareas complejas de varios pasos).
- Se distribuye mediante las suscripciones GLM Coding Plan (desde unos 18 $/mes), una API propia y un chat web.
Fiel a toda la historia de GLM, Z.ai no publicó ni un solo benchmark en el lanzamiento. En un sector donde los modelos suelen llegar con su tabla de victorias lista, es poco habitual. Las pruebas independientes llegaron unos días después, y el modelo resultó fuerte en código: 62,1 % en SWE-bench Pro frente al 58,6 % de GPT-5.5. Quedó segundo entre los modelos de código en el ranking a ciegas Code Arena y se acercó a Claude Opus 4.8 en Terminal-Bench, con un precio claramente inferior al de GPT-5.5.
Esa fuerza se paga en tokens. En el propio gráfico de Z.ai sobre programación agéntica, GLM-5.2 en el nivel máximo de razonamiento casi alcanza a Opus 4.8, pero gasta aproximadamente el doble de tokens de salida y aun así se queda un poco por detrás en el pico. Más barato por token, pero consume más tokens.

La planificación es el punto fuerte de GLM-5.2. En nuestras pruebas resolvía por sí mismo las cuestiones abiertas y explicaba sus decisiones, en lugar de dejárselas al desarrollador. Un ejemplo: el modelo no solo cacheó una consulta sobre un flag inexistente, sino que detectó la trampa menos evidente: esa caché habrá que vaciarla si el flag se crea más adelante. Un plan vale tanto como el número de preguntas que resuelve antes de empezar a trabajar, y con ese criterio GLM-5.2 es fuerte.
Para managers: GLM-5.2 es ante todo una herramienta para desarrollo y planificación técnica. En tareas de código y diseño de soluciones técnicas compite con los modelos insignia a un precio notablemente menor. Cómo se comporta en tareas de negocio es otra historia, y la contamos más abajo.
GLM-5.3: mejora sin un nuevo modelo base (14 de agosto de 2026)
GLM-5.3 todavía no está en nuestro benchmark: los datos de abajo son del fabricante y de plataformas independientes.
Lo más importante de esta versión es lo que no tiene. Z.ai no entrenó un nuevo modelo base: GLM-5.3 se apoya exactamente en la misma base que GLM-5.2, y toda la mejora viene del post-entrenamiento: datos, etiquetado, métodos de aprendizaje por refuerzo.
Según Z.ai, el salto más revelador está en Terminal-Bench 3.0, donde se le da al modelo una terminal y debe llevar la tarea hasta el final: de 4,6 a 28,3 puntos. Seis veces más con el mismo modelo base. En DeepSWE v1.1 el resultado subió de 46,2 a 66,9. En CyberGym, que evalúa la defensa frente a ciberataques, del 77,2 % al 84,5 %.
La conclusión práctica para un directivo: buena parte de la utilidad de un modelo moderno se crea después del preentrenamiento. Ese ajuste se puede rehacer en meses, mientras que un nuevo modelo base requiere años. Cuando un proveedor promete un «nuevo modelo», conviene preguntar qué es exactamente lo nuevo: la arquitectura y la escala, o un ajuste sobre la base anterior.
Los precios no cambiaron: 1,40 $ por millón de tokens de entrada y 4,40 $ por millón de salida. Contexto de 1 millón de tokens, respuesta máxima de 128.000 y un modo de razonamiento siempre activo que no se puede desactivar. Esto último significa que parte del presupuesto se va en tokens de razonamiento que nadie pidió: justo la característica por la que GLM-5.2 gastaba el doble de tokens de salida que Opus 4.8 en tareas comparables.
El modelo es solo de texto. No entiende imágenes, y en torno a eso surgió una historia aparte.
Los pesos abiertos de GLM-5.3 no se publicaron con el lanzamiento: Z.ai los retuvo para una revisión de seguridad posterior. El lema de la versión: «Built to Code. Ready for Cyber Defense».
Mil cuatrocientas peticiones de visión
El 29 de junio de 2026, el fundador de Zhipu, Tang Jie, preguntó a la comunidad qué le faltaba al próximo GLM. Llegaron más de 1.400 respuestas, y la petición más frecuente fue la visión. Los desarrolladores querían que el modelo leyera por sí mismo capturas de pantalla, PDF, maquetas de interfaz y mensajes de error. El apaño habitual era este: Qwen-VL analiza la imagen y pasa el texto a GLM-5.2. Un eslabón más, más latencia y dos peticiones que pagar en lugar de una.
Li Xuan, directivo de Z.ai, reconoció públicamente que la palabra «vision» había inundado los comentarios. No hubo ningún compromiso.
Mes y medio después salió GLM-5.3, sin visión. La visión llegó doce días más tarde y en otro modelo.
El caso es revelador precisamente porque es típico del sector. Un proveedor puede recoger todo el feedback que quiera; no está obligado a responder a él. Conviene planificar con lo que ya ha salido y está disponible por API.
GLM-5.3-Flash (26 de agosto de 2026)
Este modelo es la gran noticia del verano en Z.ai, y tampoco está aún en nuestro benchmark. Seis días antes del anuncio, el mismo modelo funcionaba gratis en OpenRouter con el nombre stealth/ox-alpha, sin autor indicado; volvemos a ese episodio más abajo, en la sección sobre Pony Alpha.
GLM-5.3-Flash es el primer modelo nativamente multimodal de la familia GLM-5. Acepta como entrada texto, imágenes, vídeo y archivos. Ya no hace falta un segundo modelo para analizar una imagen.
Su arquitectura es un MoE de 320.000 millones de parámetros, de los que 18.000 millones están activos por token: cada token se enruta a 8 expertos de 288. La atención es híbrida: capas lineales KDA se alternan con capas MLA dispersas sin codificaciones posicionales. El mecanismo IndexPool reduce la caché KV 4,4 veces respecto a GLM-5.3, y mHC reduce aproximadamente a la mitad el número de parámetros activados respecto a GLM-4.5. Contexto de 1 millón de tokens.
Estos detalles importan por una sola razón: son los que permiten un precio diez veces inferior al del modelo insignia con una calidad comparable. El ahorro sale de la ingeniería de servir cada petición, mientras que la profundidad y la calidad del razonamiento apenas se resienten.
Precios: 0,15 $ por millón de tokens de entrada, 0,03 $ por la caché y 0,50 $ por millón de salida. Hasta el 9 de septiembre de 2026 hay un 50 % de descuento: 0,075 $ de entrada y 0,25 $ de salida. En las suscripciones GLM Coding Plan, Flash se incluye con el triple de cuota que GLM-5.3.
En las pruebas de la propia Z.ai: Terminal-Bench 2.1, 84,3 puntos frente a 85,0 de Claude Opus 4.8. DeepSWE v1.1, 63,4 frente a 46,2 de GLM-5.2. AutomationBench, 48,8 frente a 26,2. Son cifras del fabricante y conviene verificarlas con tus propias tareas, pero la diferencia es demasiado grande como para achacarla al marketing.
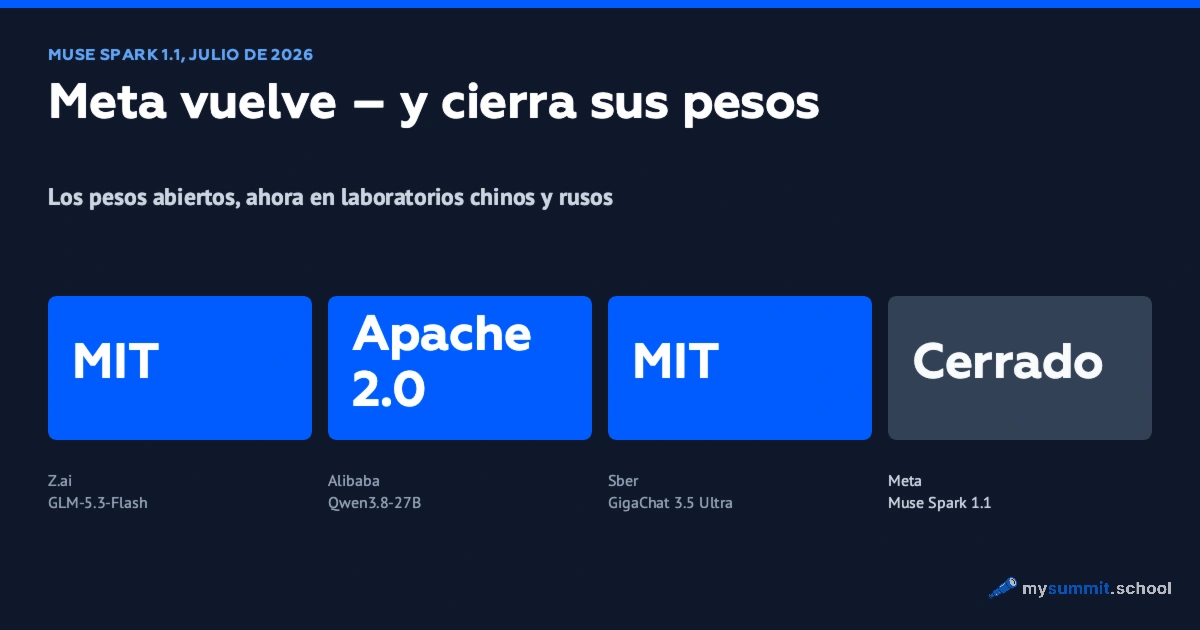
Los pesos de GLM-5.3-Flash están en Hugging Face con licencia MIT, sin umbral de facturación ni restricciones de uso. Es la licencia más libre de todos los modelos de esta revisión. A modo de comparación: Qwen3.8-Max es abierto, pero por encima de 50 millones de dólares de facturación exige un contrato aparte con Alibaba; en Kimi K3 el umbral es de 20 millones. En 2026, «pesos abiertos» abarca desde la licencia MIT hasta un contrato con tus abogados, y un manager tiene que saber en qué extremo está.
Ejecutarlo en casa requiere unos 306 GiB de pesos en FP8 y GPU de la clase NVIDIA Hopper o más recientes. Es un proyecto al alcance de una organización mediana o grande con su propio clúster, no una tarea de fin de semana. Antes del lanzamiento, el modelo también se probó en chips chinos de fabricación propia.
Qué muestran las plataformas independientes
Artificial Analysis prueba todos los modelos en las mismas condiciones, y por eso sus datos son más útiles que las tablas de lanzamiento. GLM-5.3 en el nivel máximo de razonamiento obtiene 49 puntos en el Intelligence Index. Precio combinado: 1,26 $ por millón de tokens; velocidad: 87 tokens de salida por segundo. GLM-5.3-Flash: 46 puntos por 0,18 $.
Tres puntos de inteligencia medida por siete veces más de precio.
Eso sí, hay que comprobar la escala. Artificial Analysis publica su índice por versiones y lo reescala entre ellas, así que los 60 puntos del anuncio de agosto de Z.ai (índice versión 4.1.1) y los 49 del ranking actual son reglas distintas. Solo se puede comparar dentro de una misma foto, y esto, por cierto, es un principio general para leer cualquier ranking: los rankings de IA revalúan los modelos con regularidad.
Ahora mismo no hay modelos GLM en el top 10 de LMArena. Ese ranking tiene su propia peculiaridad: los intervalos de confianza de las nueve primeras posiciones del ranking de texto se solapan, lo que estadísticamente es un empate. El primer puesto allí es una diferencia dentro del margen de error.
El esquema «el modelo barato supera al caro» ya no es exclusivo de Z.ai. En la misma Artificial Analysis, Gemini 3.8 Flash cuesta 0,74 $ por millón de tokens combinados, genera 334 tokens por segundo y supera a modelos más caros de la propia gama de Google. El reflejo de «el modelo insignia siempre es mejor» funciona cada vez menos en 2026: tanto en Google como en Z.ai, el modelo de arriba cuesta ahora varias veces más de lo que aporta.
El caso Pony Alpha: una investigación que se repitió
«Pony» alude al año del Caballo en el calendario chino. El 11 de febrero, Zhipu confirmó oficialmente que Pony Alpha era GLM-5. Las acciones de la empresa subieron un 60 % en tres días.

La empresa nunca explicó oficialmente qué había pasado. Zhipu no comentó la confusión de identidad.
No es un caso aislado. En diciembre de 2025, investigadores del MIT constataron que los modelos de la serie GLM se identificaban como Claude en torno al 50 % de las veces con métodos de consulta no estándar. DeepSeek V3 tenía una peculiaridad similar: con ciertos prompts se presentaba como ChatGPT o GPT-4. OpenAI respondió acusando abiertamente a DeepSeek de destilar sus modelos y actualizó sus condiciones de uso. Anthropic, Mistral y xAI añadieron cláusulas antidestilación similares a las suyas.
La destilación, es decir, entrenar un modelo más pequeño con las salidas de uno más grande, es por lo que parece un secreto a voces del sector. Es imposible confirmar que se usara en GLM-5: no tenemos una auditoría técnica. Tampoco se puede descartar: los patrones de comportamiento son demasiado específicos.
Seis meses después, Z.ai repitió la jugada. El 20 de agosto de 2026 apareció en OpenRouter stealth/ox-alpha: gratuito, con un contexto de un millón de tokens y capaz de recibir texto, imágenes y vídeo. No se indicaba quién estaba detrás.
La comunidad intentó identificar al autor a partir de la infraestructura. Trazas de pila, códigos de error y huellas del tokenizador dieron 30 coincidencias de 30 con GLM-5.3, o al menos así lo reflejaban los informes de la comunidad. Eso no generó unanimidad. TechCrunch describió una comunidad que discutía con sus propias conclusiones: el analista de IA Andrew Curran señaló que las primeras pistas apuntaban a Z.ai, pero que «por la mañana la gente ya no parece segura de nada». Un medio se pasó a la teoría de que era una versión no publicada de Microsoft MAI. Reddit se dividió entre «no puede ser un modelo chino» y «alta probabilidad de que sea chino».
La mañana del 26 de agosto, Bloomberg informó de que Zhipu había confirmado que el modelo pertenecía a la familia GLM. A las 19:42 de ese mismo día, Z.ai lo anunció ella misma: «Introducing GLM-5.3-Flash – Previously previewed as Ox Alpha, running entirely on Chinese AI chips». La publicación superó las 740.000 visualizaciones en la primera hora y, al mismo tiempo, los pesos con licencia MIT llegaban a Hugging Face; explainX recoge la cronología del lanzamiento.
Durante su semana gratuita, Ox Alpha encabezó el ranking de aplicaciones de OpenRouter, y el tráfico era agéntico: Claude Code pasó por él unos 9.300 millones de tokens, Hermes Agent unos 9.000 millones. La plataforma midió unos 50 tokens por segundo con una latencia mediana de 2,02 s. Una cifra merece mención aparte: los errores en llamadas a herramientas, en torno al 4,45 %; en una cadena agéntica se multiplican en cada paso. El benchmark independiente del desarrollador explainX le dio un 80 % en DeepSWE. Hoy stealth/ox-alpha ya no responde y la ficha se ha eliminado: el modelo se distribuye como z-ai/glm-5.3-flash, con su propia sección más arriba.
Para un manager, lo más importante es una línea de aquella ficha. OpenRouter indicaba que el proveedor almacenaba los prompts y las respuestas y que no se usaban para entrenar; The Next Web resume la ficha. Durante una semana, los desarrolladores conectaron agentes de código en producción, Claude Code entre ellos, a un proveedor cuyo nombre nadie podía establecer, y pasaron por él miles de millones de tokens de trabajo real. Que tus datos los guarde un proveedor con el que has firmado un contrato y que los guarde alguien a quien ni siquiera puedes nombrar son riesgos distintos, diga lo que diga la línea sobre privacidad.
Pony Alpha se delató con sus palabras: ante la pregunta directa respondía «Soy GLM» y, cuando le pidieron una página sobre sí mismo, escribió «I am Claude, created by Anthropic». Ox Alpha no dijo nada de sí mismo, y hubo que reconstruir su autoría a partir de huellas del tokenizador, códigos de error y trazas de pila; incluso después, la comunidad discutió durante días y llegó a proponer a Microsoft como autor. El mismo truco de lanzamiento, con seis meses de diferencia, produjo dos tipos de enigma: el primer modelo se fue de la lengua; al segundo hubo que rastrearlo por su infraestructura.
Esto da que pensar: si el modelo «fingía» ser Claude con métodos de consulta indirectos, ¿qué absorbió exactamente durante el entrenamiento? ¿Y cuánto le importa eso a un manager que necesita una herramienta que funcione? Desde agosto la pregunta tiene una segunda mitad: junto con el modelo, el equipo elige también quién se quedará con sus prompts. En el caso de Ox Alpha, durante una semana, nadie sabía quién era.
Qué muestran las pruebas
En las pruebas estándar del sector, GLM-5 compite con los mejores modelos cerrados, algo nada trivial para un modelo abierto y gratuito. Las cifras de abajo son datos del fabricante; esto es lo que importa en ellas para un manager:

- Programación: resuelve el 77,8 % de tareas reales de GitHub. A modo de comparación: Claude Opus 4.5, 80,9 %; GPT-5.2, 75,4 %. La distancia con los líderes es mínima.
- Simulación empresarial (Vending Bench 2, una prueba en la que el modelo «dirige un negocio» durante un año): GLM-5 terminó con un saldo de 4.432 $ frente a los 4.967 $ de Claude Opus 4.5. Toma decisiones estratégicas más o menos al nivel de los mejores competidores occidentales.
- Búsqueda web: primer puesto entre todos los modelos evaluados, incluidos GPT-5.2 y Claude.
- Alucinaciones: el mejor resultado del sector. GLM-5 dice «no lo sé» con más frecuencia que inventarse una respuesta. Para trabajar con datos y cifras, esto es crucial.

Como siempre, los benchmarks y el trabajo real son cosas distintas. Pero la dirección está clara: GLM-5 juega en la misma liga que ChatGPT y Claude.
Los benchmarks son convincentes, pero entre «el modelo responde bien a las pruebas» y «el modelo resuelve mi problema de forma fiable» hay toda una capa de habilidad: cómo formular la petición, cómo verificar la respuesta, cómo no caer en una alucinación dicha con seguridad. Esa capa decide si sacas un valor real de GLM-5 o solo respuestas bonitas.
GLM-5 reduce las alucinaciones, pero sin un enfoque sistemático se te seguirán escapando. 9 tareas prácticas de manager en el módulo abierto te muestran dónde: gratis y sin registro.
Sin pago requerido • Notificación al lanzamiento
Resultados en nuestro benchmark
En nuestro benchmark evaluamos los modelos en tareas reales de gestión en 8 categorías: desde planificación y análisis hasta comunicación y trabajo con el equipo.
GLM-5 se sitúa en la parte alta del grupo intermedio: un competidor sólido que supera a la mayoría de los modelos occidentales de gama media, pero queda por detrás de líderes como Kimi K2.5 y MiniMax M2.7.
El perfil en ocho categorías se lee sin ambigüedad. GLM-5 es más fuerte en planificación, análisis y gestión de equipos, donde se acerca a los líderes. Flojea donde hace falta contexto local: formación y desarrollo, y conocimiento regional (las prácticas empresariales de los mercados postsoviéticos las dominan mejor los modelos regionales hechos para ellos, YandexGPT y GigaChat). Búsqueda de información y comunicación: justo en la media.
La conclusión práctica: GLM-5 es una herramienta sólida para planificación y tareas analíticas. Si estás desglosando un proyecto, evaluando riesgos o analizando datos, rendirá bien. Si necesitas conocer a fondo un contexto empresarial regional concreto o diseñar un programa de formación, los resultados serán más flojos. Y el acceso apenas tiene fricción: el chat web es gratuito y está abierto a cualquiera con una cuenta de Google.
¿Y GLM-5.2? En nuestro benchmark, la nueva versión va a la par con la primera en tareas de negocio, pero cuesta bastante menos, y sigue siendo uno de los modelos más asequibles de su rango de calidad (la posición, la puntuación y el precio actualizados están en la ficha bajo el encabezado de GLM-5.2, más arriba). Para un modelo abierto de unos 750.000 millones de parámetros es un resultado notable: en ese rango de tamaño había pocos modelos abiertos.
Pero surge una paradoja. En pruebas puras de código, GLM-5.2 está entre los líderes, mientras que en tareas de negocio ligadas al código, el análisis y el marketing (donde hace falta buen inglés) baja. Lo más flojo son las tareas «de pensar»: el modelo pasa por alto sistemáticamente detalles del texto o saca conclusiones que el texto no permite. El formato, en cambio, lo respeta con pulcritud, así que se integra con otros sistemas sin sorpresas, pero conviene vigilar sus conclusiones. El punto fuerte de GLM-5.2 es el razonamiento de ingeniería: código, planes técnicos, descomposición. Le cuesta más el razonamiento «sobre papel», donde hay que captar un matiz sutil en un texto corriente.
Todavía no hemos pasado GLM-5.3 y GLM-5.3-Flash por nuestras tareas de gestión, así que todo lo dicho sobre los benchmarks de código no se traslada automáticamente a los escenarios de negocio. En cuanto los probemos, estas secciones tendrán fichas con resultados actualizados.
Los resultados detallados de todas las categorías están en la página del benchmark.

¿Dudas entre GLM-5.3-Flash, DeepSeek y Claude? En el módulo abierto hay 9 tareas prácticas de manager, gratis y sin registro. Comprueba con qué seguridad le planteas tareas a la IA.
Sin pago requerido • Notificación al lanzamiento
Cómo usar Chat Z.AI (GLM-5) ahora mismo
La interfaz web oficial es chat.z.ai. Se entra con una cuenta de Google. La interfaz está en inglés y chino, no en español, pero el modelo entiende el español y responde en él.
Dos modos de trabajo:
- Chat Mode: el formato de diálogo de siempre. Sirve para la mayoría de las tareas: redacción, análisis de documentos, respuestas a preguntas.
- Agent Mode: aquí GLM-5 da lo mejor de sí. El modelo puede usar herramientas: generar archivos .docx, .pdf y .xlsx, buscar en la web, ejecutar tareas de varios pasos. Si quieres un informe con tablas, este es el modo.
Un consejo práctico sobre el idioma: la calidad de las respuestas en inglés es claramente superior a la del español. Si la tarea lo permite, escribe los prompts en inglés, sobre todo para peticiones analíticas complejas. Es la misma situación que con Qwen: los modelos chinos funcionan mejor en los idiomas con los que más se han entrenado.
La semana posterior al lanzamiento de GLM-5 fue turbulenta: el tráfico se multiplicó por diez, el servicio funcionó de forma inestable varios días y Zhipu pidió disculpas públicamente. A mediados de marzo la situación se había normalizado, pero hay que tener en cuenta que es un servicio joven con una carga que crece rápido.
Ejemplo 2. Un pre-mortem antes de lanzar un producto
La segunda tarea es analítica. Tradicionalmente es el terreno de Claude, y para GLM-5 es una prueba honesta: ¿puede un modelo chino barato ofrecer un análisis estructurado a la altura de un modelo insignia? Para GigaChat, es la ocasión de mostrar cómo se maneja en un mercado que no es el suyo.
Fíjate no solo en el contenido sino en la estructura de cada respuesta: la capacidad de cumplir todos los requisitos del prompt a la vez (6–8 causas, categorías, señales, acciones) es justo lo que separa una herramienta de trabajo de una demo vistosa.
Limitaciones y riesgos
La censura china funciona de forma predecible: temas políticamente sensibles, crítica histórica del Estado, ciertos acontecimientos; todo eso se bloquea. En el trabajo de un manager rara vez es un problema, pero conviene saberlo.
La calidad fuera del inglés y el chino es una de sus principales debilidades. En nuestras pruebas con tareas en ruso, GLM-5 perdía bastante precisión y matiz, mientras que DeepSeek aguantaba mucho mejor. Si tu equipo trabaja en español, pruébalo primero con tu propio material.

En el modo de análisis profundo, las respuestas son aproximadamente un 30–40 % más lentas que las de Claude y GPT. No es crítico para tareas puntuales, pero se nota con un uso intensivo. GLM-5.3 cambia el panorama: Artificial Analysis mide 87 tokens de salida por segundo, más rápido que Claude Opus 5 y GPT-6 Astra en las mismas condiciones.
La cuestión de la destilación sigue abierta. No afecta a la fiabilidad técnica del modelo: funciona. Pero las organizaciones que usan Claude y se preocupan por la ética en el uso de la IA deberían tenerla en cuenta.
Ejecutarlo en servidores propios es técnicamente posible (el código es abierto), pero requiere un hardware de servidor considerable. A diferencia de los modelos compactos de Qwen, GLM-5 no es algo que el departamento de TI pueda poner en marcha por su cuenta. Para GLM-5.3-Flash el requisito se conoce con exactitud: unos 306 GiB de pesos en FP8 y NVIDIA Hopper o posterior.
No hay app móvil: solo web.
Precios
| Opción | Coste | Para quién |
|---|---|---|
| chat.z.ai | Gratis (con límites) | Probar sin compromiso |
| GLM Coding Plan | desde ~18 $/mes | Desarrolladores; GLM-5.3-Flash incluido con el triple de cuota |
| API de GLM-5.3-Flash | 0,15 $ entrada / 0,50 $ salida, caché 0,03 $ por millón de tokens | Tareas multimodales y trabajo a gran volumen |
| API de GLM-5.3 | 1,40 $ entrada / 4,40 $ salida por millón de tokens | Textos largos y nivel máximo de razonamiento |
| API de GLM-5 vía OpenRouter | coste por tarea en la ficha del modelo y en el gráfico precio/calidad de abajo | Integración en los procesos de trabajo |
Hasta el 9 de septiembre de 2026, GLM-5.3-Flash tiene un 50 % de descuento: 0,075 $ de entrada y 0,25 $ de salida. Si tenías previsto un piloto con una tarea multimodal, al descuento le queda menos de una semana.
La relación calidad-precio se ve mejor en un solo gráfico: todos los modelos de nuestro benchmark, con GLM-5 y GLM-5.2 resaltados.
Analizar ese mismo informe de 100 páginas con Claude Opus 4.5 o GPT-5.2 cuesta varias veces más que con GLM-5, con capacidades comparables en muchas tareas.
Eso sí, entre los modelos abiertos chinos, GLM-5 es el más caro: DeepSeek y Qwen cuestan bastante menos. ¿Qué se paga de más? Buenos resultados en planificación y análisis; si esas son tus prioridades, la diferencia está justificada.
Tras el lanzamiento de GLM-5, Zhipu subió alrededor de un 30 % el precio del plan Pro, lo que provocó quejas de los usuarios.
¿Vale la pena probarlo?
Si eliges dentro de la gama de Z.ai en septiembre de 2026, lo lógico es empezar por GLM-5.3-Flash. Es multimodal, cuesta unas diez veces menos que GLM-5.3, se distribuye con licencia MIT y en las pruebas de código se mantiene cerca de los modelos insignia. GLM-5.3 tiene sentido para textos largos y el nivel máximo de razonamiento, cuando unos pocos puntos de diferencia influyen de verdad en el resultado y el presupuesto lo permite. GLM-5 y GLM-5.2 siguen siendo útiles, pero hay pocas razones para empezar por ellos ahora.
GLM-5 es un modelo con puntos fuertes y débiles bien reales. La historia que lo rodea todavía no tiene una respuesta definitiva.
Sus buenos resultados en planificación y análisis son reales y reproducibles. Si desglosas un proyecto, evalúas decisiones estratégicas o analizas datos, GLM-5 merece una oportunidad.
Si necesitas un modelo para un contexto empresarial regional concreto, para formar a tu equipo o para tareas con mucha especificidad local, GLM-5 queda por detrás de la competencia. Para eso, DeepSeek o Claude lo harán mejor.
El caso Pony Alpha y la identificación como Claude son un motivo para mantener la distancia analítica. No impiden usar la herramienta. El sector lleva tiempo moviéndose en una zona gris donde la frontera entre «inspiración» y «destilación» se difumina a propósito. GLM-5 forma parte de ese panorama general, y conviene tenerlo presente.
El acceso no plantea dudas: chat.z.ai funciona con una cuenta de Google y tiene un nivel gratuito. Vale la pena dedicar una hora a probarlo y formarse una opinión propia.
Parece que la pareja de lanzamientos de agosto repartió los papeles dentro de la propia Z.ai: el modelo insignia marca el techo en las tablas, mientras que la empresa gana dinero con el modelo barato y las suscripciones Coding Plan. La pregunta que conviene tener presente es cuánto aguanta ese esquema si el post-entrenamiento por sí solo multiplica por seis los resultados sobre una base antigua.
Ya tienes la herramienta. Ahora, la habilidad
Un programa completo: desde los fundamentos del prompt engineering hasta especializaciones en gestión de proyectos y gestión de personas. Elige cualquier modelo – GLM-5.3-Flash, Claude, DeepSeek – y pon a prueba tu enfoque en escenarios reales de gestión.


Stanislav Belyaev
Engineering Leader en Microsoft18 anos liderando equipos de ingenieria. Fundador de mysummit.school. 700+ graduados en Yandex Practicum y Stratoplan.