Meta Muse Spark: el primer modelo cerrado de Meta desde 2023
Hasta hoy, esta serie no tenía ni una sola entrega sobre Meta. Mientras la gran noticia era Llama 4, el silencio estaba justificado: el modelo salió polémico y no había nada que contarle a un directivo sobre él como herramienta de trabajo.
El 9 de julio de 2026, Meta lanzó Muse Spark 1.1 y ese mismo día abrió el acceso público a la Meta Model API. El anuncio se publicó en el blog de la compañía. La familia Muse, que sustituye a Llama, había arrancado tres meses antes: la versión 1.0 salió el 8 de abril y el modelo actual está construido sobre ella. En la instantánea de septiembre de LMArena, muse-spark-1.2 en modo xHigh ocupa el quinto puesto del ranking de texto, muse-spark-1.1 el décimo, y en el ranking de imágenes muse-spark es sexto. Quien compare herramientas por tablas de clasificación se va a topar con ese nombre. En la serie todavía no había respuesta para él.
Las puntuaciones son aquí la tercera noticia en importancia. La primera es la licencia: en nueve meses Meta cambió a la dirección de su área de IA, rehízo el stack y volvió con pesos cerrados. La segunda, qué tipo de modelo ha salido: la 1.1 lidera en tareas de llamada a herramientas y se queda claramente atrás escribiendo código.
Qué pasó con Llama
Llama 4 salió con críticas dispares y el lanzamiento acabó en escándalo: Meta reconoció que había preparado una configuración aparte del modelo para uno de los benchmarks. Esa admisión le costó la confianza justo del público que lee las tablas de puntuaciones con más atención que nadie.
En el verano de 2025, Zuckerberg reorganizó todo lo relacionado con la IA. El cargo de Chief AI Officer, responsable de toda el área de IA, fue para Alexandr Wang, de 29 años, cofundador de Scale AI, y a su alrededor se montó Meta Superintelligence Labs. Wang lo describe así: «Hace nueve meses reconstruimos nuestro stack de IA desde cero. Nueva infraestructura, nueva arquitectura, nuevos pipelines de datos… Es el primer paso».
El mercado vio ese primer paso el 8 de abril de 2026, con la salida de Muse Spark 1.0: la primera familia de modelos en lugar de Llama y la primera decisión de la nueva dirección visible desde fuera. El segundo paso fue la 1.1 de julio, con la API abierta el mismo día.
Pesos cerrados
El modelo solo se distribuye por API; los pesos no se han publicado. Desde julio de 2023, cuando salió Llama 2, Meta no había lanzado un modelo cerrado de primer nivel. Durante tres años la compañía explicó al mercado que los pesos abiertos eran la estrategia correcta y construyó sobre eso sus argumentos frente a Anthropic y OpenAI.
Para la 1.1 esto significa exactamente lo mismo que para la 1.0. No se puede desplegar en local, no se puede ajustar con datos propios y todo lo que se le envía acaba en los servidores de Meta.
Dentro de Meta, los productos ya se han pasado al nuevo modelo: Muse Spark sustituyó a Llama 4 en las gafas inteligentes. El detalle dice mucho. Unas gafas son un dispositivo donde la latencia de respuesta y el consumo de tokens los nota el usuario directamente, y ahí no se instala un modelo del que no se está seguro.
La división entre abiertos y cerrados ya no funciona
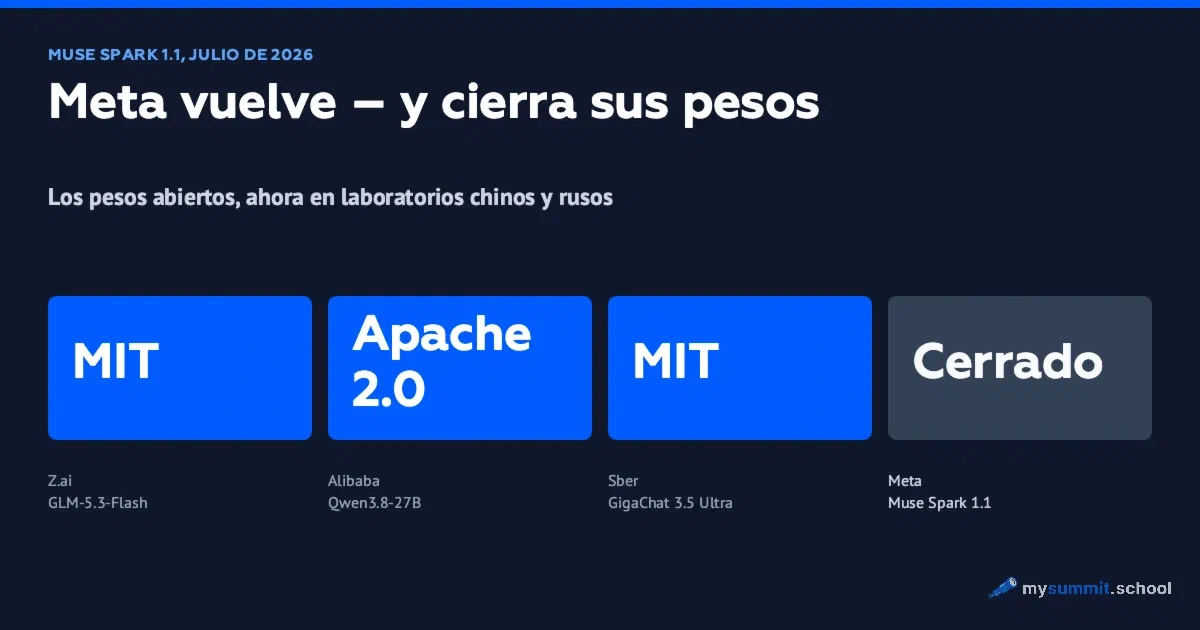
Durante todo el año, esta serie usó una división sencilla: los laboratorios estadounidenses venden modelos cerrados y los chinos regalan los pesos. En 2026 dejó de funcionar, y por los dos lados a la vez.
Meta cerró sus pesos. Z.ai, en la misma temporada, lanzó GLM-5.3-Flash bajo licencia MIT, sin umbral de ingresos ni restricciones de uso. Alibaba publicó Qwen3.8-27B bajo Apache 2.0: el modelo entiende imágenes y corre en una sola tarjeta gráfica de consumo.
Sber, el mayor banco de Rusia y desarrollador de los modelos GigaChat, lanzó GigaChat 3.5 Ultra: 432.000 millones de parámetros, también bajo MIT.
Los pesos abiertos ahora los publican laboratorios chinos y rusos. Meta es la empresa que pide confianza en su API.
El modelo por dentro
Meta posiciona la 1.1 frente a GPT-5.5, Claude Opus 4.8 y Gemini 3.1 Pro. Tiene una ventana de contexto de 1 millón de tokens y la gestiona de forma activa: comprime y descarta por sí mismo partes del historial para que una conversación larga no choque con el límite.
Como entrada acepta imágenes, vídeo, PDF y audio. Es un abanico más amplio que el de GPT-6 Astra y Grok 4.6, que solo trabajan con imágenes.
El rasgo de diseño clave de la 1.1 es el papel de agente orquestador. El modelo recibe la petición, reúne el contexto necesario, elabora un plan y reparte la ejecución entre subagentes en paralelo; después compone la respuesta con sus resultados. En la app Meta AI y en meta.ai esto aparece como el modo Thinking: en las tareas que el modelo considera difíciles, piensa más tiempo.
La utilidad práctica se ve mejor con una tarea que un directivo encarga de verdad: «aquí tienes tres ofertas comerciales y nuestra plantilla de contrato; encuentra las diferencias en plazos, penalizaciones y condiciones de aceptación». Un único agente procesa todo el paquete de golpe y al llegar al tercer documento empieza a confundir condiciones. Un orquestador divide la petición en partes, entrega cada una a su subagente y monta la respuesta con las piezas.
Este diseño viene de la primera versión. Muse Spark 1.0 se construyó como multimodal desde el principio: una sola arquitectura procesa texto e imágenes, sin un codificador de imágenes añadido a un modelo de texto. Tenía tres modos de razonamiento. Instant respondía al momento a peticiones sencillas, Thinking se activaba en tareas difíciles y Contemplating descomponía una petición en partes y lanzaba subagentes en paralelo; de ahí sale el orquestador de la 1.1. En la fase de aprendizaje por refuerzo, Meta aplicó la «compresión de pensamientos»: el modelo resuelve tareas complejas con menos tokens de razonamiento. Según Meta, la 1.0 alcanzaba el nivel de razonamiento buscado con un orden de magnitud menos de cómputo que Llama 4 Maverick. Las dos cifras, la de cómputo y la de compresión, las da el fabricante; no tenemos verificación independiente.
Cuántos tokens consume una tarea
En su batería de tareas (Intelligence Index v4.0), Artificial Analysis contabilizó 58 millones de tokens para Muse Spark 1.0. El modelo de Anthropic gastó 157 millones en la misma batería, y GPT-5.4 de OpenAI, 120 millones. Más o menos un tercio del consumo para un trabajo comparable. Esos tokens acaban en la factura, y son justo lo que más a menudo desaparece de las tablas comparativas.
Hay dos salvedades. Las tareas de Artificial Analysis son estándar; con sus documentos largos y en un diálogo con aclaraciones, el consumo sería otro. Y la cifra corresponde a la 1.0: Meta no ha publicado el consumo de la 1.1, y un orquestador con subagentes en paralelo hace más trabajo que una sola pasada sobre la petición, así que gasta más tokens.
Qué dicen los rankings independientes
Muse Spark aún no está en nuestro benchmark: a continuación, datos de Meta y de plataformas independientes; en la página /research/benchmark/ este modelo no aparece.
En LMArena, donde personas comparan respuestas a ciegas, muse-spark-1.2 (xHigh) mantiene 1499 ± 10 y el quinto puesto del ranking de texto; muse-spark-1.1 es décimo con 1492 ± 5. El primer puesto es de Claude Fable 5. En el ranking de imágenes, muse-spark ocupa el sexto lugar con 1294 ± 9 y muse-spark-1.2 xHigh el octavo con 1292 ± 15. El tercer puesto ahí es de qwen3.8-max.
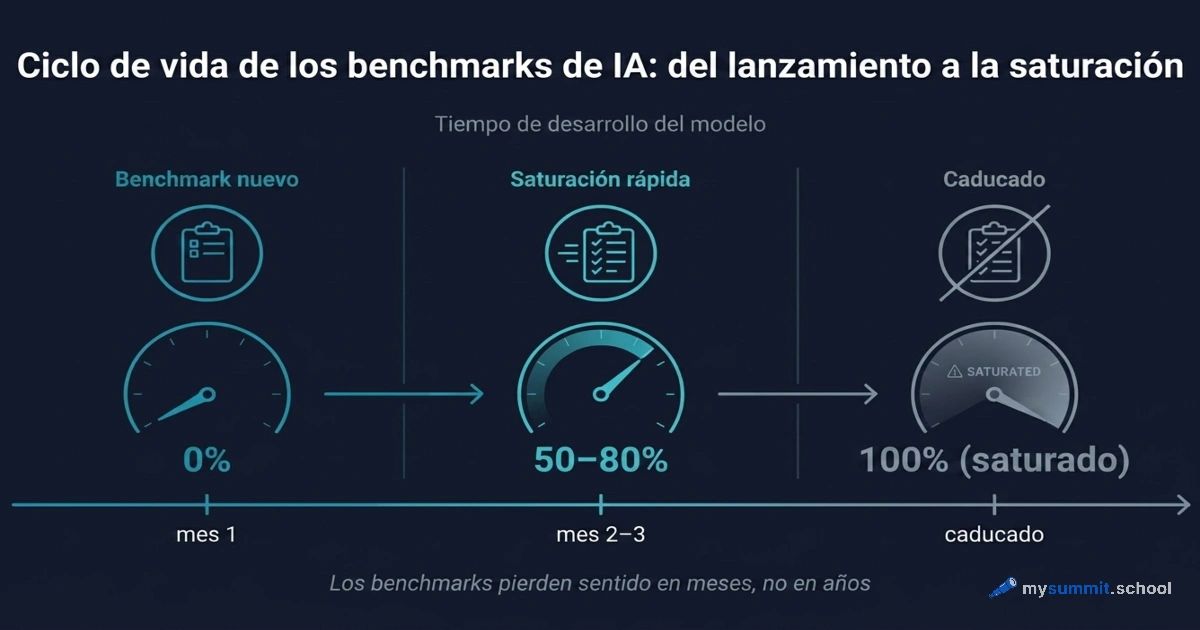
En ambos rankings, la distancia entre filas vecinas es menor que la amplitud del intervalo de confianza de cada una. Los puestos del primero al noveno son un empate estadístico, y cualquier texto que proclame el mejor modelo a partir de estas tablas ve en ellas más de lo que hay. Lo analizamos en el artículo «Los benchmarks de IA pierden sentido», y Muse Spark es un buen motivo para recordarlo: el modelo entra en el top diez de ambos rankings sin salir del pelotón indistinguible.
En el Intelligence Index v4.0, Artificial Analysis da a Muse Spark 1.0 52 puntos en la clasificación general. Formalmente supera los 51 de Grok 4.6, pero esas dos cifras no se pueden comparar: la plataforma publica el índice por versiones y cambia la escala entre una y otra. El «60» del anuncio de abril y el «49» de la tabla en vivo de septiembre están en escalas distintas. Dentro de una misma instantánea, el panorama varía según el tipo de tarea: en CharXiv Reasoning, donde el modelo razona sobre gráficos científicos, la 1.0 obtiene 86,4, y en HealthBench Hard, 42,8, claramente por encima de la competencia.
Los puntos débiles de la 1.0 los publicó la propia Meta. ARC-AGI-2, prueba de razonamiento abstracto: 42,5, con la competencia por encima de 76. Programación: 77,4, mientras que, según Meta, Claude y Gemini superan los 80 en esa misma batería.
Dónde lidera y dónde se queda atrás
Tres benchmarks del anuncio de julio describen la 1.1 con más precisión que su puesto en el ranking general. MCP Atlas, prueba de llamada masiva a herramientas: 88,1, primer puesto. JobBench, tareas profesionales con herramientas: 54,7, también primero. DeepSWE 1.1, programación de horizonte largo: 53,3 frente a 67,0 de GPT-5.5.
Las tres cifras las publicó Meta y no tienen verificación independiente. Aun así, encajan en un mismo cuadro, que coincide con el perfil de la 1.0: fuerte con documentos y gráficos, flojo en programación.
Muse Spark es un modelo para orquestar herramientas. Reunir contexto de varios sistemas, elaborar un plan, repartir la ejecución entre subagentes y consolidar los resultados: ahí va por delante de todos los que se han medido. Escribir y reescribir código en un recorrido largo: ahí la desventaja frente a GPT-5.5 supera los trece puntos, y una brecha así no se cierra ajustando el prompt.
Dónde encaja un modelo así
De estos datos sale una recomendación concreta. Si la tarea suena a «reúne datos de tres sistemas, compáralos con nuestra plantilla y enséñame las diferencias», vale la pena considerarlo. «Escribe una migración» ya es trabajo para Claude o Gemini.
Cómo encaja esto con el resto de modelos se explica en la parte de síntesis de la revisión de herramientas GenAI 2026.
La recomendación es corta: orquestación de herramientas, sí; código, no. En la práctica, todo depende de cómo se formule la petición. El orquestador dividirá la petición en partes, pero qué partes necesita lo decide usted. La diferencia entre «la respuesta parece verdad» y «la respuesta se puede poner en el informe» es la habilidad de plantearle bien una tarea a la IA.
Nueve tareas habituales de un directivo, desde desmontar el informe de otro hasta escribir a un proveedor, resueltas con IA en un módulo gratuito. Sin necesidad de registrarse.
Sin pago requerido • Notificación al lanzamiento
Acceso y precio
El acceso para consumidores es gratuito: la app Meta AI y la web meta.ai. El acceso para desarrolladores pasa por la Meta Model API, que abrió en vista previa pública el 9 de julio de 2026, el mismo día del lanzamiento de la 1.1, y solo para desarrolladores de Estados Unidos. La API es compatible con OpenAI, así que el código escrito para ChatGPT se migra cambiando la dirección y la clave. Las tarifas están anunciadas: 1,25 USD por millón de tokens de entrada y 4,25 USD por millón de tokens de salida, con 20 USD de crédito gratuito al empezar. Meta cita como primeros socios a Replit, Cline, Box y OpenClaw Foundation.
Para una empresa fuera de Estados Unidos, la tarifa no es lo decisivo. Hoy el acceso a la API exige una cuenta de desarrollador estadounidense, y el producto de consumo solo está disponible donde se ofrece Meta AI; no hay una vía aparte para Muse Spark.
En la práctica, los datos de trabajo que se envían al modelo van a los servidores de Meta en Estados Unidos, dentro de una vista previa pensada para desarrolladores de ese país. La mayoría de las políticas corporativas de datos tendrán algo que decir al respecto, por bueno que sea el modelo. Conviene preguntar directamente al equipo legal y de protección de datos antes de introducir nada sensible.
La promesa de los pesos abiertos
Wang asegura que los pesos abiertos de una de las versiones de Muse Spark 1.2 llegarán «pronto». Los desarrolladores reaccionan con escepticismo, y el escepticismo tiene fundamentos formales.
La fórmula «una de las versiones» deja a Meta libertad para publicar una variante recortada. Los modelos Llama anteriores tenían licencia propia, con un umbral de 700 millones de usuarios activos mensuales; es decir, los «pesos abiertos» de Meta ya significaron una vez «abiertos con letra pequeña». Y la promesa viene de la misma dirección que antes explicaba por qué se retrasaba la publicación abierta de Llama 4.
Si al final publican los pesos, las cuentas cambian: la infraestructura propia resuelve tanto el coste como la cuestión de entregar datos a un proveedor. Mientras no ocurra, Muse Spark solo entra en la arquitectura como API ajena, abierta de momento solo a desarrolladores de Estados Unidos.
Puntuaciones sí, pesos no
Meta ha tardado nueve meses en volver al top cinco de un ranking donde los nueve primeros puestos son estadísticamente indistinguibles. En esos mismos meses, Z.ai, Alibaba y Sber publicaron sus pesos bajo MIT y Apache 2.0, sin umbral de ingresos.
La empresa que pasó tres años demostrando al mercado que los pesos abiertos eran la única estrategia honesta ha vuelto con pesos cerrados. La pregunta que deja abierta Muse Spark: ¿los pesos abiertos eran para Meta una estrategia o una forma de compensar su retraso en calidad? Lo sabremos cuando llegue ese «pronto».
Ya tiene la herramienta. Ahora, la habilidad
Del experimento al sistema
La base del programa: ingeniería de prompts, pensamiento crítico y los límites de la confianza en la IA – 4 capítulos, 23 lecciones.
Stanislav Belyaev
Engineering Leader en Microsoft18 anos liderando equipos de ingenieria. Fundador de mysummit.school. 700+ graduados en Yandex Practicum y Stratoplan.