Modelos MAI de Microsoft en 2026: qué se puede usar de verdad y cuánto cuesta
El 2 de junio, en Build 2026, Microsoft presentó siete modelos propios bajo la marca MAI (Microsoft AI): razonamiento, código, imágenes, voz y transcripción. Una empresa que durante años fue el mayor inversor de OpenAI lo describió como un paso hacia la «autosuficiencia a largo plazo».
A un directivo le importan dos cosas de este anuncio. La primera, el precio: transcribir una hora de reunión grabada cuesta 0,10 $, y no hace falta un contrato con Azure. La segunda, Frontier Tuning: entrenar un modelo con sus propios flujos de trabajo, dentro de su propio perímetro de cumplimiento normativo. Es la idea más potente que Microsoft ha lanzado en todo el año, y solo se vende junto con el stack empresarial completo de Microsoft.
Así que empecemos por quién puede comprar qué y después pasemos a los modelos y las cifras.
Primero: quién tiene acceso de verdad
MAI llega en dos niveles muy distintos. La mitad corporativa –Microsoft Foundry y Frontier Tuning– se vende a través de una relación empresarial con Azure: cuenta, proceso de compras, contrato. La otra mitad está al alcance de cualquiera con una tarjeta: modelos de imagen, voz y transcripción en OpenRouter con precios publicados, más el modelo de código dentro de GitHub Copilot.
Este artículo omite a propósito las guías paso a paso para configurar Foundry. La documentación de Microsoft ya las cubre para los equipos que trabajan en Azure. Aquí nos centramos en lo que un directivo puede probar esta misma semana sin pasar por el departamento legal ni por compras.
Siete modelos construidos «desde cero»
Microsoft insiste en el origen: «No destilamos de otros laboratorios ni nos apoyamos en datos opacos». Según la propia empresa, construyó ella misma la arquitectura, el pipeline de entrenamiento y el post-entrenamiento, y codiseñó los modelos con su chip Maia 200, lo que le dio una mejora de eficiencia de 1,4 veces. MAI-Thinking-1 se entrenó desde cero con datos limpios y con licencia comercial, sin destilación de OpenAI ni de ninguna otra familia de modelos.
Para un comprador corporativo con exigencias de cumplimiento sobre el origen de los datos, esa es la verdadera diferencia de producto. El benchmark es secundario: las cifras de calidad las puede comprobar cualquiera; el origen de los pesos, solo el proveedor.
El año pasado escribimos que Microsoft había ganado en silencio el mercado de la IA corporativa. Esa misma estrategia ha desembocado ahora en una gama de modelos propia:
| Modelo | Qué es | Cifras clave |
|---|---|---|
| MAI-Thinking-1 | Modelo insignia de razonamiento | MoE disperso: 35 000 millones de parámetros activos de aproximadamente un billón; contexto de 256K, respuesta de hasta 64K tokens, solo texto |
| MAI-Code-1-Flash | Modelo para código agéntico | 5000 millones de parámetros activos, ventana de contexto de 256K tokens |
| MAI-Image-2.6 | Generación y edición de imágenes | Variante Flash para trabajo masivo y barato |
| MAI-Transcribe-2 | Reconocimiento de voz | 60 idiomas, terminología de dominio |
| MAI-Voice-2 | Síntesis de voz | 15 idiomas, adaptación de voz a partir de una muestra breve, protección contra abusos |
Diez centavos por hora de grabación
Lo que se puede usar hoy mismo está en OpenRouter, un agregador de modelos con precios publicados y sin contrato corporativo. Esto es lo que ofrece:
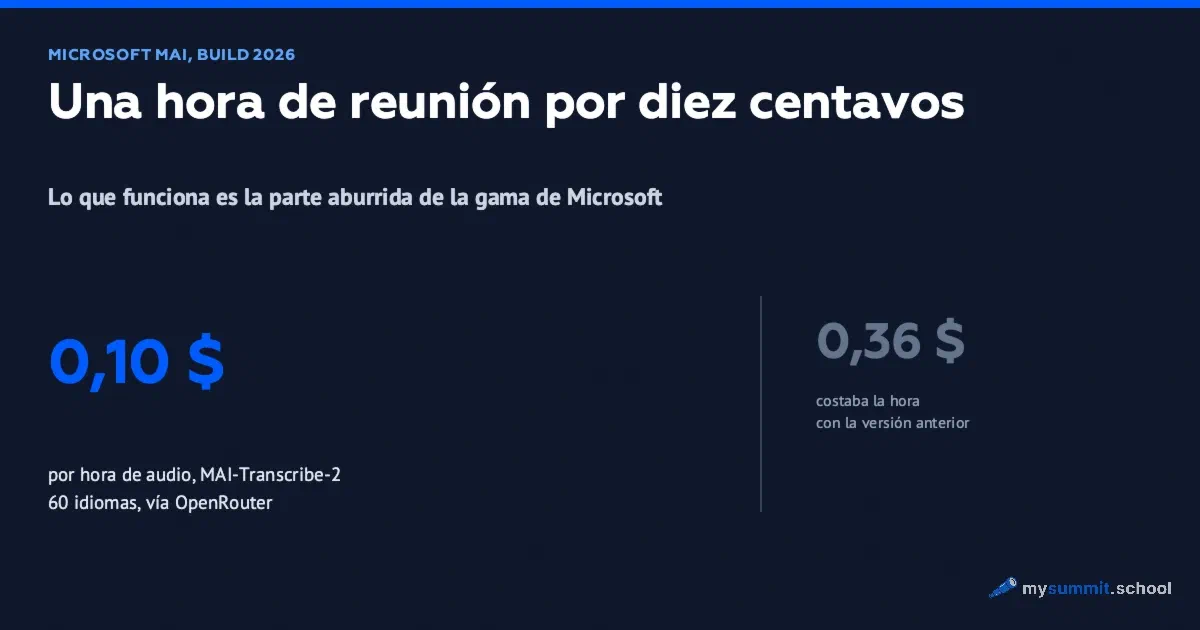
microsoft/mai-transcribe-2– 0,10 $ por hora de audio, 60 idiomas. La versión anterior,mai-transcribe-1.5, cuesta 0,36 $ la hora: la nueva es 3,6 veces más barata.microsoft/mai-voice-2– 22 $ por millón de caracteres; la variante flash, 15 $.microsoft/mai-image-2.6– 5 $ por millón; flash, 1,75 $; las versiones 2.5 y 2.5-pro, 5 $ por millón cada una.microsoft/mai-ds-r1– contexto de 164K tokens, sin precio indicado.
Una hora de reunión grabada por diez centavos es la cifra más útil de todo el anuncio de MAI. La propia Microsoft llama a MAI-Transcribe-2 «el modelo de reconocimiento de voz más rápido, preciso y barato del mundo» y afirma ser cinco veces más rápida que la competencia. Como con cualquier afirmación de un proveedor, conviene comprobar la precisión con sus propias grabaciones, pero el precio es real y está publicado, y llegar a él no requiere el visto bueno de legal ni de compras.
La forma de la gama dice mucho. El modelo insignia de razonamiento es una preview para la que apenas se consigue cuota, mientras que lo que está listo para trabajar hoy es un modelo de transcripción del que nadie escribe titulares. La parte de MAI que funciona es la aburrida.
Los precios y las vías de acceso son un conocimiento que caduca en meses. Decidir a qué modelo se le asigna qué tarea y cuánto presupuesto reservar para ello es una habilidad, y dura más que cualquier lista de precios.
Diez centavos por hora de grabación es el precio. La pregunta es qué le encarga al modelo por ese dinero. Pruebe la IA en 9 tareas reales de un manager: gratis y sin registro.
Sin pago requerido • Notificación al lanzamiento
Una reunión de 40 minutos en ruso, con tres modelos
Microsoft reivindica para MAI-Transcribe-2 el primer puesto en FLEURS: un WER medio del 5,2 % en 60 idiomas. No publica ninguna cifra por idioma. La página del modelo indica un 3,4 % para los 25 idiomas principales, lo que significa que la dispersión dentro del conjunto es grande y no se sabe dónde cae cada idioma concreto.
Además, la media subió respecto al 3,7 % de MAI-Transcribe-1.5 en 43 idiomas. La razón está en la composición: se añadieron 17 idiomas con pocos datos, así que ahora la media se calcula sobre material más difícil. Y FLEURS en sí es habla leída: hablantes nativos que leen unas 2000 frases preparadas. Una reunión con interrupciones, ruido de fondo y pruebas de micrófono suena muy distinto.
Por eso hicimos la prueba con algo más parecido a la vida real y en un idioma que no es el inglés. Elegimos el ruso: es la lengua de nuestro público original, y Microsoft no publica ninguna cifra para él, mientras que ElevenLabs informa de un WER del 3,1 % en ruso sobre FLEURS. En la clasificación de WER de Artificial Analysis, MAI-Transcribe-2 es segunda, por detrás de Alibaba Fun-Realtime-ASR. Microsoft reivindica el liderazgo en velocidad y precio, no en precisión.
La grabación: un encuentro abierto de una comunidad de team leads de Kazajistán, «Тимлид не кодит» («El team lead no programa»), del 3 de junio de 2026. 39,6 minutos de ruso conversacional, varios participantes, prueba de micrófonos al principio; los temas, un laboratorio de servidores, la mudanza de la comunidad de Telegram a Discord y la cultura de contratación. La grabación es pública, así que cualquiera puede verificar las cifras de abajo. Ejecutamos MAI-Transcribe-2 a través de OpenRouter (microsoft/mai-transcribe-2), la vía que no requiere contrato con Azure, así que los resultados se obtuvieron por el mismo camino que puede usar el lector. El modelo también está en Azure Speech en preview, pero esa vía exige una cuenta de Azure. Como comparación usamos Gemini 3.5 Flash y Yandex SpeechKit, la API de voz de referencia en el mercado ruso.
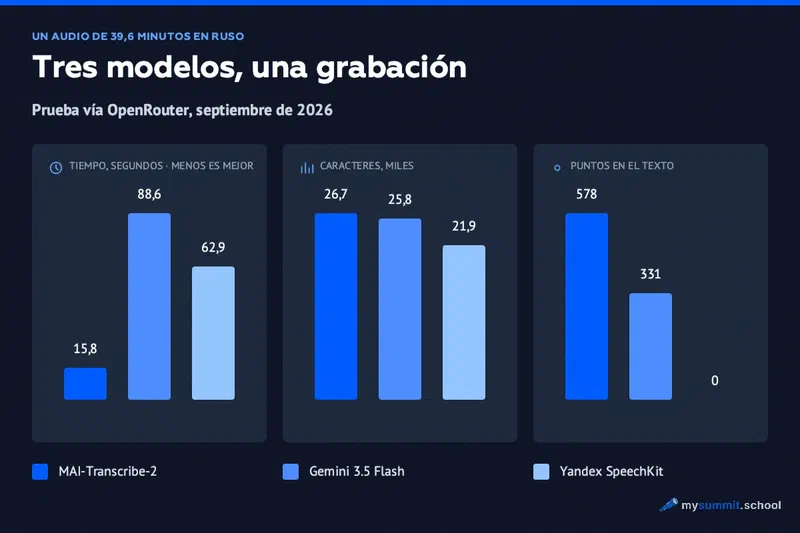
MAI fue 5,6 veces más rápida que Gemini y 4 veces más que Yandex: 39,6 minutos de audio en 15,8 segundos, cuatro fragmentos en paralelo, unas 150 veces más rápido que el tiempo real. La afirmación de Microsoft sobre la velocidad se confirmó con audio real.
Yandex no devolvió puntuación alguna: cero puntos, cero comas, una sola línea de 21 910 caracteres. Para un acta de reunión, eso obliga a una segunda pasada.
MAI conserva las muletillas: el «eh» ruso («э-э») aparece 54 veces en su transcripción y ninguna en las demás. El modelo tiene modos verbatim y clean: para una transcripción literal hace falta el primero; para un acta, el segundo.
Las diferencias que se ven en el texto
El principio de la grabación, la prueba de micrófonos (en ruso, tal como lo devolvió cada modelo):
| Modelo | Transcripción |
|---|---|
| MAI-Transcribe-2 | «Добрый вечер. Так. А сейчас какой-то шум от меня хотя бы идёт. О, сейчас пошло. А, так, так, так, спикерс.» |
| Gemini 3.5 Flash | «Добрый вечер. Так. А сейчас какой-то шум от меня хотя бы идёт? О, сейчас пошло. А-а, так-так-так, спикером…» |
| Yandex SpeechKit | «Добрый вечер Так А сейчас какой то шум от меня хотя бы идет вова сейчас пошла а А так так так спикер с» |
El ponente dice, más o menos: «Buenas tardes. Bueno. ¿Ahora sale algún sonido de mí? Ah, ahora sí.». Yandex convirtió la interjección «Ah» («О,») en el nombre «Vova» («вова») e incluso hizo concordar el verbo con él. También perdió el nombre «Aram», que los otros dos modelos sí captaron.
El caso más grave es una inversión del sentido en mitad de la grabación:
| Modelo | Transcripción |
|---|---|
| MAI-Transcribe-2 | «…музыку-то слышал. Мне интересно. Похоже, т- техника как бы, которая… всё портит.» |
| Gemini 3.5 Flash | «…музыку-то слышал? Мне интересно. Похоже тут техника как бы, которая всё портит.» |
| Yandex SpeechKit | «…музыку то слышал Не интересно. Покажите техника как бы которая Все портит» |
Dos errores en una frase, y los dos dan la vuelta al sentido: «Me interesa» («Мне интересно») pasó a ser «No me interesa» («Не интересно»), y «Parece que» («Похоже») se convirtió en «Enséñenme» («Покажите»). En un acta de reunión, eso ya es otra afirmación, y alguien la va a firmar.
Escúchelo usted mismo
La prueba de micrófonos es el caso fácil. Vamos a la mitad de la reunión, donde hay conversación de trabajo: del 10:55 al 11:55, los participantes hablan de mudar la comunidad de Telegram a Discord y de repartir permisos en los canales. El audio está en ruso. Reprodúzcalo y cambie de pestaña: en cada una está la transcripción literal de ese mismo minuto según cada modelo, seguida de una nota en español sobre qué acertó y qué no.
▸Reconoce el nombre del producto todas las veces, pero lo escribe de dos formas: primero en cirílico («Дискорд») y después en alfabeto latino, «Discord». Dentro del mismo minuto.
▸Los dos nombres de producto en alfabeto latino y escritos igual en las cuatro menciones.
▸La palabra Discord no aparece ni una vez. En su lugar: «лесики скорбь» (algo así como «bosquecillos pena»), «без слов» («sin palabras») y, dos veces, «диспорт». Cuatro intentos, cuatro fallos.
Fragmento de la grabación pública del encuentro «Тимлид не кодит» del 3 de junio de 2026, organizado por una comunidad de team leads de Kazajistán. Las rayas y los guiones dentro de las transcripciones son tal como los devolvieron los modelos.
Un nombre de producto mal escrito se detecta de un vistazo, y en ese sentido este error es menos peligroso que una inversión del sentido. Lo peor es otra cosa: «в принципе без слов мало кто пришёл» («en principio, sin palabras vino poca gente») se lee como una frase completa, y nadie la va a marcar en el acta.
Aquí también se ve la diferencia entre los modos verbatim y clean. MAI conservó el titubeo «т- техника» («la t- técnica»), mientras que Gemini lo suavizó en «тут техника» («aquí la técnica»), añadiendo una palabra que no está en la grabación. De ahí no se deduce que «Gemini sea más preciso»: los modos son distintos y, para una transcripción literal, la versión suavizada es peor.
La tercera diferencia es un fragmento que desapareció por completo. MAI lo tiene: «Мо- может кто-то поговорить, э-э, просто так, чтобы… Раз-раз. Ну, раз-раз я слышу. О, ну всё хорошо тогда, хоть что-то слышат.» («¿Pue- puede alguien hablar, eh, aunque sea para…? Probando, probando. Bueno, el probando sí lo oigo. Ah, entonces todo bien, al menos algo se oye»). En Gemini y en Yandex el fragmento del «probando, probando» no aparece: los dos modelos se lo saltaron.
Lo que la prueba no muestra
- No medimos el WER: no hay una transcripción de referencia de la grabación, así que la comparación es cualitativa.
- No pudimos comprobar la terminología sectorial, porque en la grabación no la había. Justo ahí actúa el keyword biasing de MAI, y justo eso quedó sin probar.
- Una grabación, un dominio, una acústica. Es una comprobación previa a la compra; no se le puede llamar benchmark.
Servicios especializados en audio en ruso
Si lo que necesita es precisamente un acta en ruso, existen alternativas probadas con audio en ruso. Una comparativa de las mejores API de reconocimiento de voz publicada en Habr (en ruso, febrero de 2026) da estos WER:
- Nexara – 0,391
- Palatine – 0,414
- Shopot – 0,444
- Sber API – 0,448
- Yandex SpeechKit – 0,550, último puesto
Las startups rusas más pequeñas son más precisas que los dos grandes actores locales, Yandex y Sber. Si su equipo celebra reuniones en ruso, es una alternativa real.
La conclusión es la misma en cualquier caso: pruebe el modelo con su propia grabación antes de incorporarlo a un proceso. Microsoft tiene la transcripción más rápida y el precio más bajo, ni una sola cifra publicada para el ruso, y en nuestra grabación MAI-Transcribe-2 dio el mejor resultado en puntuación y estructura. Es suficiente para hacer una prueba. Para comprar a ciegas, no.
MAI-Thinking-1: una preview con precio publicado
El modelo insignia está en el catálogo de modelos de Microsoft Foundry en estado de preview, pero Microsoft publicó las tarifas de inmediato: 2 $ por millón de tokens de entrada y 8 $ por millón de tokens de salida [Microsoft Foundry blog].
Como comparación, en la misma tabla de precios Sonnet 4.6 cuesta 3 $ y 15 $, es decir, en salida MAI-Thinking-1 cuesta casi la mitad. En un modelo de razonamiento, la mezcla de entrada y salida se inclina hacia la salida, así que la diferencia en la factura estará más cerca del doble que de 1,5 veces.
El precio de catálogo y el acceso al modelo son cosas distintas. Las cuotas de la preview se reparten con cuentagotas: las solicitudes a MAI-Thinking-1 chocan con frecuencia con la falta de cuota, y que «el modelo esté en el catálogo» no significa que vaya a procesar su tarea hoy. Es pronto para montar un flujo de trabajo sobre él.
Según la ficha del modelo: ventana de contexto de 256K tokens, techo de respuesta de 64K tokens, entrada y salida solo de texto, alojamiento en Azure. No acepta imágenes ni audio, así que para tareas con capturas de pantalla o grabaciones de reuniones no sirve en absoluto.
Las garantías de residencia de datos dependen de la región de Azure, y la cobertura regional todavía se estaba desplegando en el lanzamiento.
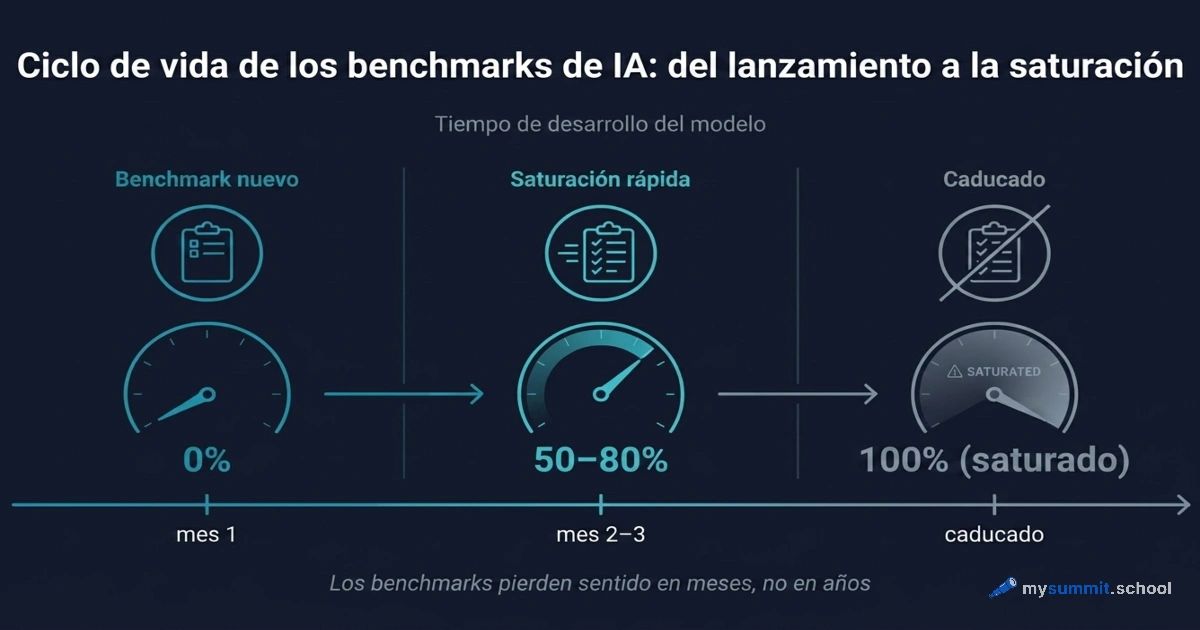
Las afirmaciones sobre calidad también son palabras de la propia Microsoft. Según sus datos, MAI-Thinking-1 iguala a Opus 4.6 en SWE-Bench Pro y, en una evaluación humana a ciegas, resultó preferible a Sonnet 4.6. A MAI-Code-1-Flash se le atribuye hasta un 60 % menos de consumo de tokens que Haiku 4.5 en benchmarks de código, con mayor precisión. Todavía no hay confirmación independiente de estas comparaciones, y en nuestro benchmark tampoco hay ningún modelo MAI. Sobre cómo leer este tipo de afirmaciones tenemos un análisis aparte: Los benchmarks de IA pierden sentido: cómo elegir modelo entonces.
MAI-Code-1-Flash: un precio que no se puede pagar
Para el modelo de código se citan tarifas de 0,75 $ por millón de tokens de entrada y 4,50 $ por millón de salida, con la entrada en caché a 0,075 $. Son exactamente las cifras de GPT-5.4 Mini.
Conviene darlas con una salvedad: el modelo no tiene endpoint público ni aparece en Azure AI Foundry, y su ficha dice que el precio está «por determinar». Es decir, estas tarifas describen la contabilidad interna de tokens dentro de Copilot. No existe ninguna API en la que se puedan pagar.
Donde el modelo está realmente disponible es en GitHub Copilot y VS Code: las solicitudes se enrutan a MAI-Code-1-Flash automáticamente, en todos los planes, de Free a Max; hay una versión para CLI en camino. Es la segunda vía hacia la gama MAI, después de OpenRouter, que no requiere contrato con Azure.
Frontier Tuning: entrenamiento dentro de su perímetro
Lo realmente nuevo del anuncio. El fine-tuning habitual trabaja con documentos: usted entrega un corpus de textos y recibe un modelo que conoce su terminología. Frontier Tuning funciona de otra manera: el aprendizaje por refuerzo se ejecuta dentro del propio perímetro de cumplimiento del cliente, y el modelo aprende de trazas reales del flujo de trabajo: cadenas de herramientas, decisiones y sus resultados. Microsoft llama a estos entornos de aprendizaje por refuerzo «gimnasios para la IA»; los datos no salen del entorno del cliente. Por primera vez en esta plataforma, los desarrolladores pueden ajustar los propios pesos.
Ya escribimos en detalle sobre lo que los entornos de entrenamiento le aportan hoy a un directivo: Entornos de entrenamiento de IA: lecciones de gestión de 1000 millones de dólares.
Los resultados de Frontier Tuning son, por ahora, palabra del proveedor y de sus socios:
- En la implantación de RR. HH. de la propia Microsoft, la tasa de tareas completadas pasó del 13 % al 87 % tras el ajuste.
- Un modelo MAI ajustado para Excel iguala a GPT-5.4 con una eficiencia hasta 10 veces mayor.
- McKinsey informa de la tasa de victorias más alta de todos los modelos que probó, con una diferencia de coste de unas 10 veces.
La idea que un directivo debería llevarse de aquí: un modelo pequeño, ajustado a su flujo de trabajo, supera a un modelo insignia generalista por una fracción del precio. La aritmética en sí no es nueva; ya la vimos en un mercado de 53 modelos: el 99 % de la calidad por el 1,4 % del precio.
La otra mitad de la verdad es que Frontier Tuning también es un argumento para comprar todo el stack de Microsoft: Foundry, Copilot Studio, los chips Maia, el trabajo de los Forward Deployed Engineers. Aquí la idea potente solo se vende en paquete con el ecosistema: si su empresa no es ya un cliente comprometido de Azure, la entrada cuesta todo el conjunto. Aun así, merece la pena seguir la tendencia: otros proveedores se mueven en la misma dirección, y si los datos no pueden salir de la empresa bajo ningún concepto, la respuesta pasa por el hardware propio: LLM locales para managers.
El caso de Mayo Clinic encaja en la misma lógica corporativa: un modelo de frontera para medicina construido sobre la experiencia de la clínica y sus datos clínicos anonimizados, desplegado primero dentro de Mayo y prometido más adelante en Foundry. Lo importante aquí es una cláusula del acuerdo: Mayo conserva la propiedad del modelo. Para cualquier líder de su sector, es la plantilla de cómo crear un modelo junto con una plataforma sin cederle su activo.
Dónde conseguir acceso
Todas las vías, de la más accesible a la más difícil:
| Vía | Qué ofrece | Realidad |
|---|---|---|
| OpenRouter | Modelos de imagen, voz y transcripción, precios publicados | Sin contrato con Azure: la única vía que funciona sin relación corporativa |
| GitHub Copilot / VS Code | MAI-Code-1-Flash, enrutamiento automático | Planes de Free a Max; versión CLI en camino |
| Fireworks, Baseten | MAI-Thinking-1 | Alojamiento de terceros |
| Microsoft Foundry | Toda la gama, evaluación, seguridad, observabilidad, Frontier Tuning | Requiere una cuenta empresarial de Azure |
| Copilot Studio / Forward Deployed Engineers | Proyectos de Frontier Tuning | Contrato directo, solo enterprise |
Todavía no hay ningún modelo MAI en nuestro benchmark; qué contiene y cómo comparar entre sí los modelos probados, en el hub de la serie: Comparativa de herramientas GenAI 2026.
Cómo aplicarlo en el trabajo
- Grabe su próxima reunión y pase el audio por MAI-Transcribe-2 en OpenRouter: una hora cuesta 0,10 $. Compárelo con lo que paga hoy por la transcripción y con la frecuencia con la que la transcripción pierde la terminología de su sector.
- Si su equipo ya paga GitHub Copilot, mire a qué modelo van sus tareas habituales y si la calidad cambia cuando el enrutamiento elige MAI-Code-1-Flash.
- No incluya Foundry en el presupuesto si su empresa no trabaja ya a fondo con Azure. En su lugar, siga las ofertas de ajuste sobre flujos de trabajo de los proveedores con los que ya trabaja.
Tras años como mayor inversor de OpenAI, Microsoft ha llegado a una idea incómoda para todo el mercado de frontera: un modelo pequeño bien ajustado da el mismo resultado por una décima parte del precio. Y esa idea solo la vende junto con su nube, su hardware y sus ingenieros. Lo que cualquier directivo puede usar hoy es una hora de grabación por diez centavos.
La pregunta ya no va de Microsoft. Si el ajuste a un proceso consigue de verdad el mismo resultado por una fracción del precio, ¿cuánto aguantarán las listas de precios de los modelos insignia, y cuál de los proveedores con los que ya trabaja responderá primero?
Los precios de los tokens cambian. La habilidad de elegir modelo se queda
Programa completo del curso: desde los fundamentos del prompt engineering y el pensamiento crítico hasta especializaciones en gestión de proyectos y analítica. Habilidades prácticas, no teoría.
Stanislav Belyaev
Engineering Leader en Microsoft18 anos liderando equipos de ingenieria. Fundador de mysummit.school. 700+ graduados en Yandex Practicum y Stratoplan.