Agents de code en 2026 : deux formats, le terminal et le bureau
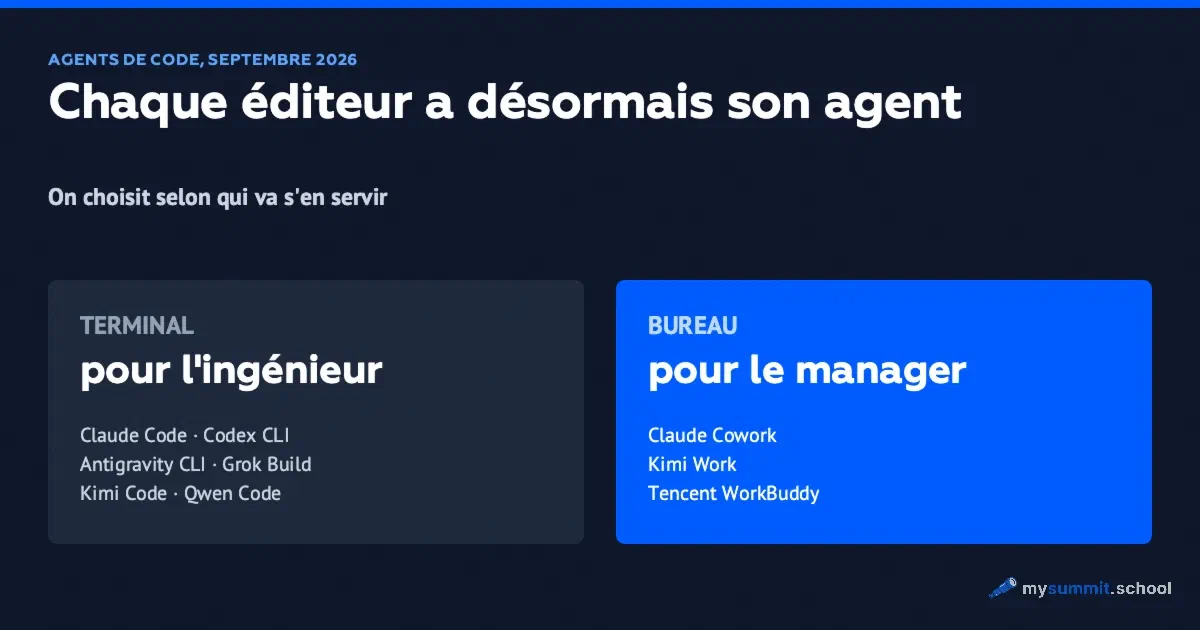
En septembre 2026, tous les éditeurs de modèles ont sorti leur agent de code : Anthropic, OpenAI, Google, Microsoft, xAI, DeepSeek, Moonshot, Alibaba, Z.ai, Tencent. Dès le milieu de l’année, Claude Code, Cursor, Codex et Antigravity avaient convergé vers le même schéma de programmation agentique : le programme lit les fichiers, les modifie, lance des commandes, vérifie le résultat et rend compte. Les différences tiennent à l’emballage, aux prix et à l’écosystème – c’est pourquoi une liste alphabétique d’une dizaine de noms n’apprend rien au lecteur.
La ligne de partage utile, c’est le format. Dans le terminal vivent les agents pour ingénieurs : Claude Code, Codex CLI, Antigravity CLI, Grok Build, Kimi Code CLI, Qwen Code. Le manager n’y travaille pas, mais c’est lui qui paie – et il doit comprendre ce qu’il paie au juste. Sur le bureau, on trouve les agents pour le travail de bureau : Claude Cowork, Copilot Cowork, Kimi Work, Tencent WorkBuddy. Ceux-là sont faits pour le manager et son équipe : RH, opérations, administration, projets, ventes. Ranger des fichiers, monter un rapport, traiter des notes de frais, remettre de l’ordre dans des tableurs.
Accès, dépendance et dépenses invisibles
Avant de comparer les fonctionnalités, vérifiez qui contrôle votre accès. Avec un agent propriétaire, c’est l’éditeur : ses règles de compte, ses restrictions géographiques, ses contrôles d’identité. Anthropic, par exemple, a durci son dispositif antifraude et demande désormais à certains utilisateurs une pièce d’identité et un selfie en direct via le prestataire de vérification Persona. Les gros projets et les comptes d’entreprise sont les premiers exposés à un blocage.
La seule catégorie d’outils qui ne dépend de la politique d’aucun éditeur, ce sont les CLI open source avec votre propre clé : OpenCode, Oh My Pi, Aider, Kimi Code CLI, Qwen Code, Kilo Code, DeepSeek Harness. Le programme est ouvert, la clé peut venir de n’importe quel fournisseur, et changer de fournisseur revient à modifier la configuration. Ce que cela donne en pratique est détaillé dans Claude Code coûte 100 $/mois – OpenCode fait la même chose gratuitement.
Autre trait révélateur : les ingénieurs paient les agents avec des comptes personnels et des clés tierces, et la plupart des outils n’offrent aucun tableau de bord où l’entreprise verrait ces dépenses. Kilo donne la mesure du flux : environ 10 000 milliards de tokens par mois transitent par sa plateforme, envoyés par plus de 3 millions de développeurs (chiffres de l’éditeur en juillet 2026, au moment du rachat par Anaconda). Ce sont des dépenses qui n’apparaissent dans aucun budget, et des données d’entreprise qui sortent sous un contrat signé à titre personnel par un salarié.
Le cycle d’achat annuel, lui, est en décalage avec le cycle trimestriel des changements de prix. Un budget Copilot validé au premier trimestre 2026 aux tarifs de l’époque était caduc dès juin, après le changement de modèle de facturation. Un contrat annuel à prix fixe reste l’exception dans cette catégorie.
Pour la même raison, une revue comme celle-ci se périme plus vite que la suivante ne paraît : depuis février 2026, nous avons compté 36 changements de conditions chez les agents, dont huit portant sur le prix ou l’accès. C’est pourquoi nous tenons les prix et la disponibilité à part, avec la date de dernière vérification pour chaque ligne, dans le hub des agents (en anglais).
Le terminal, l’outil de l’ingénieur
Tous les agents du premier tableau partent du principe que l’utilisateur sait ce que sont un dépôt, une branche et un terminal. C’est l’outil de travail de l’ingénieur.
Claude Code · Anthropic
- Modèle par défaut : Opus 5 par défaut, Fable 5 et Sonnet 5 au choix
- Licence : propriétaire
- Prix : l’offre sur laquelle on travaille vraiment est Max, 100–200 $ par mois ; Pro à 20 $ existe, mais ses limites suffisent pour un essai. Ou paiement au token
Inclus dans toutes les offres payantes de Claude. Le système de sous-agents le plus abouti, positionné comme la meilleure qualité sur les tâches multifichiers.
Codex CLI · OpenAI
- Modèle par défaut : gpt-5.6-sol, effort moyen
- Licence : open source, Rust, plus de 88 600 étoiles
- Prix : une offre ChatGPT ou votre propre clé ; paiement au token ajouté
Un seul agent dans le terminal, l’IDE, le web et le cloud. Routage entre trois niveaux de prix : Sol, Terra, Luna.
Antigravity CLI · Google
- Modèle par défaut : Gemini 3.1 Pro, Claude Sonnet 4.6, GPT-OSS 120B
- Licence : propriétaire, Go
- Prix : gratuit avec limites / Pro 20 $ / Ultra 249,99 $
A remplacé Gemini CLI. Multimodèle, exécution en parallèle.
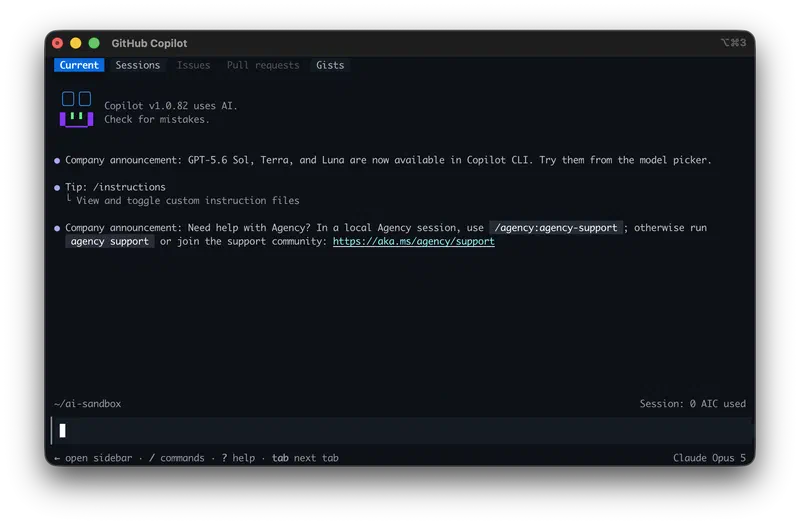
GitHub Copilot CLI · Microsoft
- Modèle par défaut : au choix chez trois éditeurs : Anthropic, OpenAI, Google
- Licence : non précisée
- Prix : inclus dans l’abonnement Copilot
Modes Plan et Autopilot, délégation à des sous-agents, mémoire du contexte d’une session à l’autre.
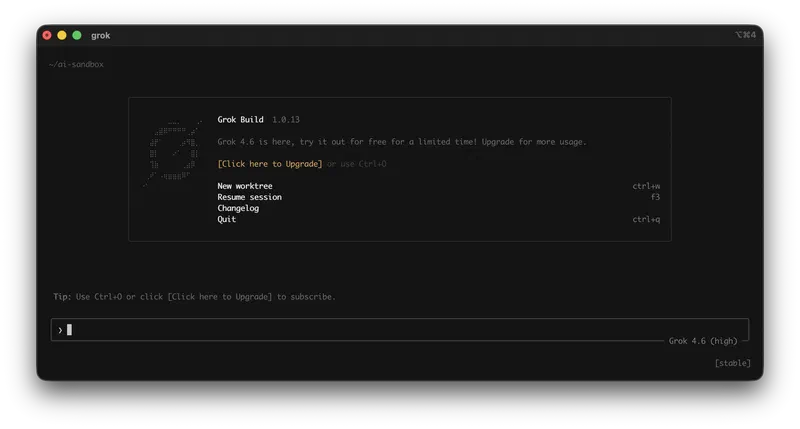
Grok Build · xAI
- Modèle par défaut : Grok 4.6
- Licence : Apache 2.0
- Prix : SuperGrok 30 $, Plus 100 $, Heavy 300 $ par mois ; Grok Build est accessible dès l’offre de base, le paiement annuel revient moins cher. Au moment de la capture d’écran, l’agent proposait un accès gratuit « pour une durée limitée »
Sorti de bêta avec la version 1.0 ; la capture montre le build 1.0.13 du canal stable. Le pari d’architecture, c’est l’exécution en parallèle : les arbres de travail (worktrees) se créent directement depuis l’écran d’accueil. L’accès gratuit est à considérer comme une promotion : il est apparu au lancement et ne figure pas dans la grille tarifaire.
L’offre de base à 30 $ comprend les sous-agents en parallèle et les worktrees, l’extension via MCP, les skills, plugins et hooks, ainsi qu’un mode headless pour les scripts et la CI/CD – une ligne rare dans une grille tarifaire, qui signifie que l’agent peut être intégré à la chaîne de build. X Premium+ n’est offert en bonus qu’avec l’offre haut de gamme Heavy.
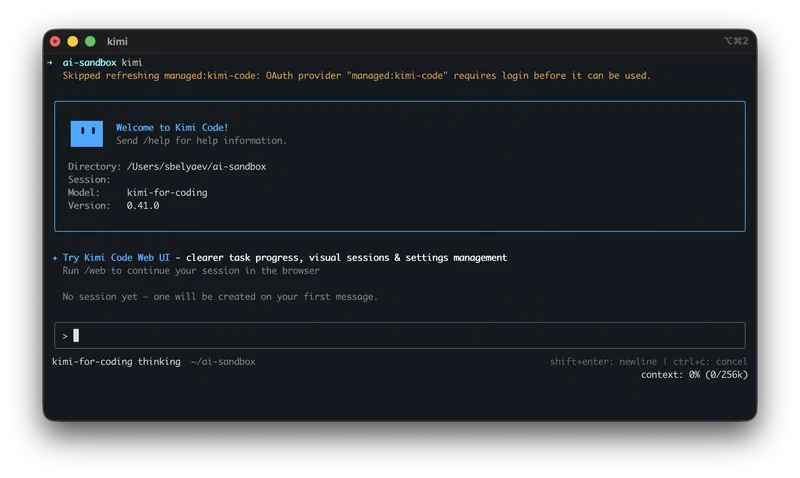
Kimi Code CLI · Moonshot
- Modèle par défaut : Kimi
- Licence : MIT, TypeScript
- Prix : le CLI est gratuit ; accès au modèle par OAuth ou clé
Sous-agents coder / explore / plan dans des contextes isolés.
Qwen Code · Alibaba
- Modèle par défaut : Qwen3-Coder
- Licence : Apache 2.0
- Prix : l’OAuth gratuit a été fermé, une clé est désormais nécessaire
Fork de Gemini CLI, ouvert à tout modèle compatible OpenAI.
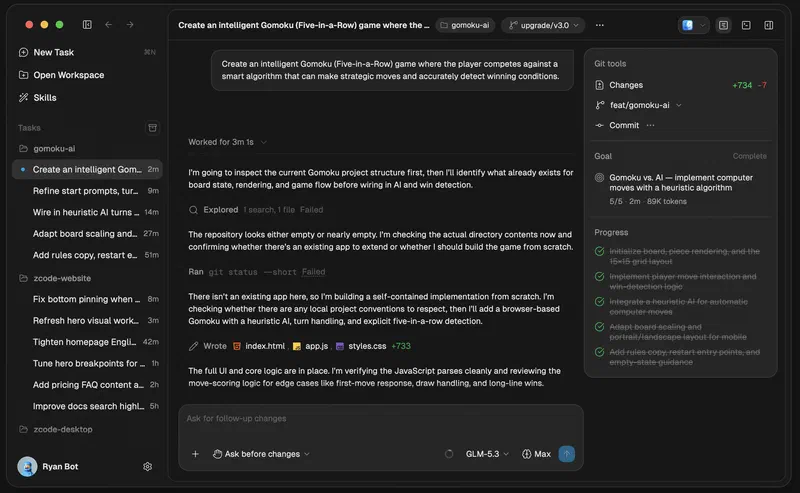
ZCode · Z.ai
- Modèle par défaut : GLM-5.3, dont c’est l’environnement officiel
- Licence : non publiée
- Prix : Lite 12,60 $, Pro 56 $, Max 117,60 $ par mois ; les offres sont décomptées en crédits hebdomadaires
- Plateformes : macOS, Windows, Linux (en bêta)
Le seul de la liste terminal à exister sous deux formes à la fois : ligne de commande et fenêtre de bureau. D’où les objectifs pour les tâches longues, le mode multiagent et le pilotage par un bot de messagerie. Formellement, cela en fait un cas limite, comme Kilo Code : il relève des deux catégories.
DeepSeek Harness · DeepSeek
- Modèle par défaut : V4-Pro, V4-Flash
- Licence : MIT
- Prix : gratuit, avec votre propre clé
Principe du « tout est plugin », sessions reproductibles. Appelle Claude Code et Codex comme sous-agents.
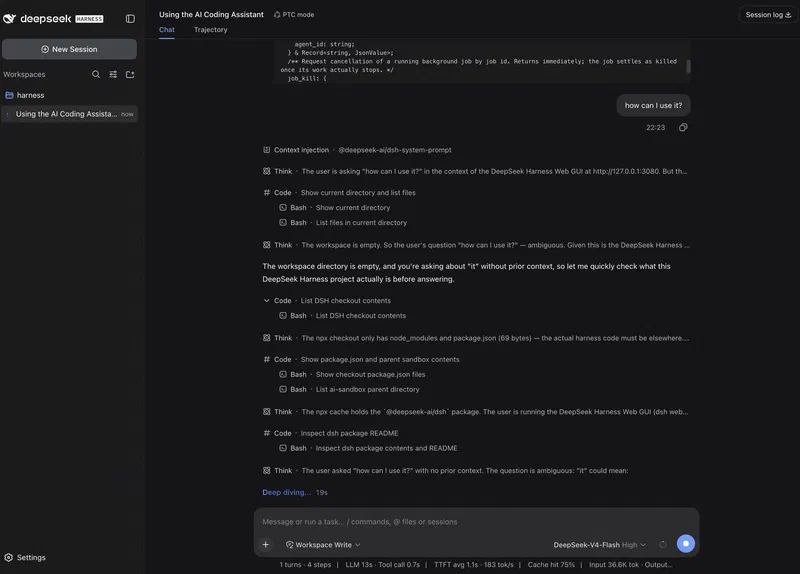
Kilo Code · Kilo, intégré à Anaconda depuis juillet 2026
- Modèle par défaut : n’importe lequel, plus de 500 modèles
- Licence : MIT
- Prix : le logiciel est gratuit : votre propre clé, des crédits au tarif du fournisseur ou Kilo Pass à partir de 19 $ par mois ; Teams, 15 $ par utilisateur
Cinq modes : Orchestrator, Architect, Coder, Debugger, Ask ; exécution d’agents en parallèle.
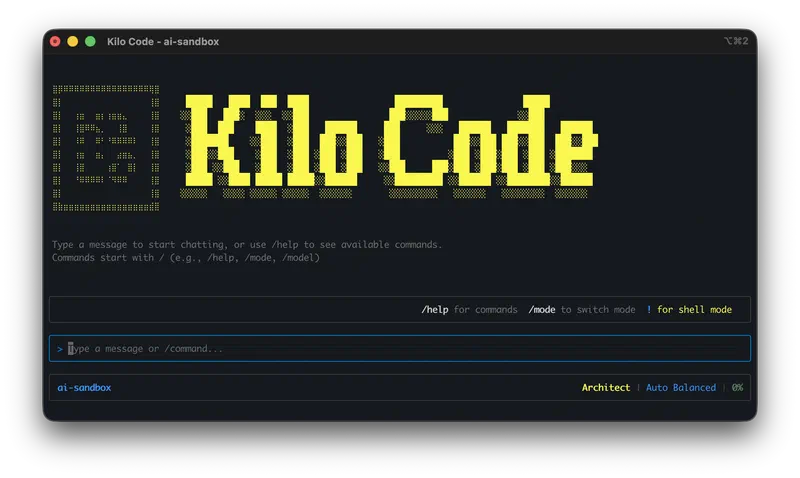
OpenCode · communauté
- Modèle par défaut : n’importe lequel, plus de 75 fournisseurs
- Licence : MIT
- Prix : gratuit, avec votre propre clé
L’alternative open source de fait à Claude Code.
Oh My Pi · communauté
- Modèle par défaut : n’importe lequel, plus de 40 fournisseurs
- Licence : MIT
- Prix : gratuit, avec votre propre clé
Modifications hashline, LSP, débogage via DAP.
Aider · communauté
- Modèle par défaut : n’importe lequel, y compris des modèles locaux via Ollama
- Licence : Apache 2.0
- Prix : gratuit
Commits automatiques natifs git. Le rythme de développement a ralenti depuis la mi-2026.
Prix communiqués par les éditeurs, septembre 2026. Les offres Claude sont détaillées dans la revue de Claude, celles de ChatGPT dans la revue de ChatGPT.
Ce que cela coûte à une équipe
Les prix ci-dessus sont par poste, et on ne bâtit pas un budget comme ça. Faisons le calcul pour une équipe de cinq ingénieurs, avec les données du même tableau.
En abonnement, Claude Code est inclus dans toutes les offres payantes de Claude, mais l’offre d’entrée est trompeuse. Les limites de Pro à 20 $ suffisent pour un essai, pas pour la journée d’un ingénieur : sur une vraie tâche, elles sont épuisées en deux heures. Mieux vaut chiffrer l’équipe à partir de Max : cinq postes reviennent à 500–1 000 $ par mois. Codex CLI fonctionne avec une offre ChatGPT, Grok Build avec SuperGrok ou X Premium+, donc la facture dépend des abonnements que l’équipe a déjà. Kilo Code se calcule à part pour les équipes : 15 $ par utilisateur, 75 $ par mois pour cinq.
Voici le détail qui renverse le calcul. L’agent d’un éditeur arrive avec son propre modèle et se paie par abonnement, pas au compteur de l’API : Claude Code avec l’offre Claude, Codex CLI avec l’offre ChatGPT, Grok Build avec SuperGrok dès 30 $, Copilot CLI avec l’abonnement Copilot. Dans l’abonnement, personne ne compte les tokens, il n’y a que les limites de l’offre. Le même volume de travail via l’API coûte nettement plus cher chez la plupart des éditeurs, et dans une équipe active l’écart se compte en multiples. Le revers, c’est la dépendance : l’abonnement Claude vous donne Claude, et impossible d’y changer de modèle.
Avec votre propre clé, la licence ne coûte rien : OpenCode, Oh My Pi, Aider et DeepSeek Harness sont distribués sous MIT et Apache 2.0. La facture vient du fournisseur du modèle et dépend de ce que l’agent a lu et écrit. Cette facture n’a pas de plafond : l’abonnement bute sur les limites de l’offre, la clé fonctionne tant qu’il reste de l’argent sur le compte. La différence entre les deux modèles se résume à qui porte le risque de dépassement : l’éditeur ou vous.
Les outils répondent déjà à ce problème par des contrôles de dépense : alertes sur les dépenses anormales avec seuils journaliers, hebdomadaires et mensuels, ventilation de la consommation par membre de l’équipe, listes centralisées de fournisseurs et de modèles autorisés. Ils sont apparus là où la facturation passe par une clé sans aucun plafond au-dessus.
Reste la troisième option – héberger le modèle soi-même –, et une idée reçue tenace l’accompagne. ServerFlow, une société russe qui vend du matériel serveur, a chiffré cette option sur son propre équipement, et sa conclusion va à l’encontre de son intérêt commercial : un serveur avec un téraoctet de RAM et une seule H100 coûte au minimum 6,5 millions de roubles, il fait tourner des modèles ouverts de plusieurs centaines de milliards de paramètres, et une tâche agentique via OpenCode prend environ une heure. Les coûts variables sont bel et bien plus bas : selon leur calcul, l’électricité revient environ 42 % moins cher que les mêmes tokens via l’API. À ces volumes, le matériel mettrait plus de 160 ans à être amorti. L’exécution en local achète le contrôle des données, l’absence de limites externes et la liberté d’expérimenter ; elle ne fait pas économiser sur les tokens.
La chronologie de 2026
Le calendrier montre la vitesse du marché :
Chacun de ces huit événements a changé les conditions pour ceux qui avaient déjà choisi leur outil : fin de l’accès gratuit à Qwen Code, arrêt de Gemini CLI, changement de propriétaire pour Kilo Code.
L’horizon de toute décision se mesure ici en mois, et mieux vaut l’intégrer d’emblée au budget et aux règles d’achat.
Ce qui distingue les agents quand le schéma est le même
Les différences tiennent à la façon dont le travail s’organise autour du modèle. Chez Claude Code, les sous-agents sont le mode de travail normal : la tâche est découpée et répartie dans des contextes séparés, et Fable 5 et Sonnet 5 se sélectionnent à la main quand Opus 5 est surdimensionné.
Codex CLI tourne par défaut sur gpt-5.6-sol et économise le budget par le routage : une tâche simple part vers le niveau bon marché sans qu’un humain décide. Antigravity CLI et GitHub Copilot CLI répondent autrement à la même question : un même programme contient plusieurs modèles (Gemini 3.1 Pro, Claude Sonnet 4.6 et GPT-OSS 120B chez Google ; Claude Opus 4.6 et Sonnet 4.6, GPT-5.3-Codex, Gemini 3 Pro et Claude Haiku 4.5 pour les tâches rapides chez Microsoft), et changer de modèle devient un réglage, sans avoir à installer un nouvel outil.
Grok Build a misé sur le parallélisme : jusqu’à huit agents travaillent simultanément sur la même tâche.
La même équipe de ServerFlow a voulu vérifier à quel point ces différences pèsent sur le résultat. Elle a construit son propre benchmark de 16 tâches : SQL, Python, C/C++, Rust et infrastructure de messagerie. Les scripts de vérification ne sont pas montés dans le conteneur, l’agent ne peut donc pas lorgner la réponse ; chaque tâche dispose de 20 minutes, chaque exécution démarre dans un répertoire et une session vierges. Quatre environnements d’agent (harness) ont été testés – OpenCode, Pi, Hermes et OpenClaw – sur six modèles locaux et deux moteurs d’inférence. Trois d’entre eux ne figurent pas dans le tableau ci-dessus : Pi est l’environnement minimal sur lequel repose Oh My Pi, même si leurs prompts système diffèrent d’un ordre de grandeur ; Hermes et OpenClaw sont des projets open source distincts de la même catégorie.
Comparaison de quatre environnements d’agent sur des modèles locaux, ServerFlow, septembre 2026 (en russe)Sur la part de tâches résolues, les environnements se tiennent de près : l’écart est en général de quelques tâches sur seize, et aucun ne décroche nettement. Le seul 16 sur 16 a été obtenu par OpenClaw associé à l’un des modèles Qwen. OpenClaw et OpenCode se sont montrés les plus réguliers. Le seul échec majeur des tests, les auteurs l’attribuent à l’appel d’outils sur un moteur d’inférence précis, pas aux propriétés de l’environnement lui-même.
La différence est apparue sur une tâche appliquée : construire une plateforme low-code de workflows. Là, la facture et le temps ont divergé. OpenClaw s’en est sorti du premier coup en 55 minutes et 60 000 tokens. Pi a eu besoin de trois essais, 140 000 tokens et 130 minutes. Hermes, de cinq essais, 190 000 tokens et 150 minutes. Lors d’une exécution antérieure sur un modèle plus gros, OpenCode a dépensé 280 000 tokens et sept itérations de corrections sans jamais obtenir de résultat fonctionnel.
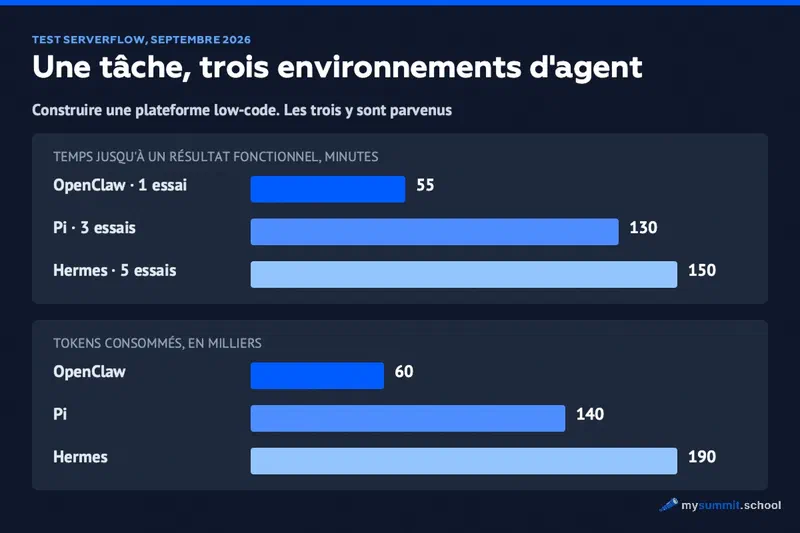
Pour le manager, la conclusion est simple : le choix de l’environnement influe peu sur la capacité à résoudre la tâche, mais il multiplie le coût et le délai. Les réserves habituelles s’appliquent : les auteurs ont écrit le benchmark eux-mêmes, n’ont testé que des modèles locaux, et l’entreprise vit de la vente de serveurs. Ils ont publié le code du benchmark sur GitHub, les chiffres sont donc vérifiables.
Ce que montrent les benchmarks d’agents
Les benchmarks de modèles classiques mesurent des réponses à des problèmes. Les benchmarks d’agents mesurent autre chose : le programme mène-t-il le travail à son terme dans un environnement réel ? La référence ici est Terminal-Bench, de Stanford, Harbor et du Laude Institute : l’agent reçoit un terminal et de vraies tâches – compiler du code, monter un serveur, configurer un système, analyser un incident, entraîner un modèle.
La construction du classement compte plus que les places. Chaque ligne décrit une combinaison environnement + modèle + niveau d’effort, et à côté de la part de tâches résolues figurent l’argent et les tokens dépensés. Version 4.0, 330 exécutions par ligne :
| Environnement et modèle | Effort | Résolu | Coût de l’exécution |
|---|---|---|---|
| Codex + GPT-6 Astra | max | 58,18 % | 3 300 $ |
| Codex + GPT-6 Astra | high | 57,88 % | 2 300 $ |
| Claude Code + Fable 5.1 | max | 57,88 % | 6 200 $ |
| Claude Code + Opus 5 | max | 51,82 % | 6 000 $ |
| Claude Code + GLM-5.3 | max | 41,82 % | 2 700 $ |
| Codex + GPT-5.6 Sol | max | 37,27 % | 2 500 $ |
| Grok Build + Grok 4.6 | high | 20,30 % | 3 600 $ |
Les deux lignes du milieu affichent le même 57,88 % pour un prix 2,7 fois différent. Plus haut, on voit la même chose au sein d’une seule pile : chez Codex, passer de high à max ajoute 0,3 point de pourcentage et mille dollars, soit quarante pour cent de plus sur la facture de l’exécution.
La ligne Claude Code avec GLM-5.3 mérite qu’on s’y arrête : un modèle tiers dans l’environnement d’Anthropic résout 41,82 % pour 2 700 $, contre 51,82 % pour 6 000 $ avec l’Opus 5 natif. Dix points de qualité coûtent ici plus du double, et c’est exactement l’arbitrage que le manager tranche sans regarder quand il achète en bloc l’abonnement d’un éditeur.
Le meilleur score est de 58 %. Plus de la moitié des tâches ne sont résolues par personne : « l’agent s’en chargera tout seul » n’est pas encore une réalité pour ce type de travail.
Une réserve sur les chiffres eux-mêmes : les lignes sont renseignées par les participants, et le classement ne fait l’objet d’aucune vérification indépendante. Comment lire les benchmarks en général : voir Quand les benchmarks IA perdent leur sens.
Open source et clés personnelles
Pour une entreprise qui ne veut pas dépendre d’un seul éditeur, la liste terminal offre un argument à part : les licences. Codex CLI est open source : Rust, près de 90 000 étoiles sur GitHub (données GitHub de septembre 2026). Claude Code et Antigravity CLI sont fermés ; la licence de ZCode n’est pas indiquée dans les sources publiques, et celle de GitHub Copilot CLI n’y figure pas non plus.
Un logiciel ouvert, cela veut dire qu’on peut lire le code et vérifier ce que l’outil fait des fichiers, et que la clé est la vôtre, chez n’importe quel fournisseur. Les étoiles GitHub, en revanche, mesurent la popularité ; c’est l’activité des commits ces dernières semaines et la date de la dernière version qui disent si un projet est vivant.
DeepSeek Harness fait figure d’exception. Son architecture repose sur le principe du « tout est plugin » : fichiers, terminal, plugins, sessions reproductibles. Il existe aussi un fork distinct, dsh cli – un agent terminal avec interface plein écran, sortie en streaming, historique des sessions et gestion des autorisations ; pas besoin de navigateur.
Harness entretient un autre rapport avec le reste de cette revue : il sait appeler Claude Code et Codex comme sous-agents. C’est une couche au-dessus des autres agents, qui n’a pas vocation à les remplacer. Harness ne deviendra pas un concurrent du reste de la liste terminal : il se place au-dessus.
Une telle liste se lit et se range facilement. La difficulté commence quand c’est vous qui formulez la tâche pour l’agent : « prépare un rapport » produit un document que quelqu’un doit lire en entier et confronter aux sources. Entre « l’agent a rapporté quelque chose » et « ce résultat peut remonter à la direction », il y a une compétence : formuler la tâche et vérifier le résultat. Elle s’acquiert par la pratique.
Confier une tâche à un agent et vérifier le résultat – entraînez-vous sur 9 cas pratiques de manager. Gratuit, sans inscription.
Sans paiement requis • Notification au lancement
Qui se met aux commandes
Les deux moitiés de cette revue sont l’œuvre des mêmes éditeurs. Anthropic sort Claude Code pour le terminal et Cowork pour le bureau, Moonshot Kimi Code CLI et Kimi Work, Microsoft GitHub Copilot CLI et Copilot Cowork. Antigravity 2.0 a été relancé le 19 mai 2026 à Google I/O comme une plateforme couvrant les deux formats à la fois.
Il y a aussi une exception côté outils. Kilo Code est un seul logiciel qui vit à la fois dans VS Code, JetBrains, le CLI et le cloud, couvrant donc les deux formats simultanément. La plupart des outils de cette revue restent tout de même dans l’une des deux catégories, la distinction continue donc de fonctionner. Dans Kilo Code, la clé est la vôtre (BYOK), sans marge : l’inférence est facturée au tarif du fournisseur, avec seulement 5 % de commission sur les recharges de crédits, plus une place de marché MCP.
Les catégories se distinguent par qui ouvre le logiciel et avec quoi il y travaille. L’agent terminal travaille avec du code : dépôt, branches, build. L’agent de bureau, avec des fichiers, des tableurs, le navigateur, des documents. Pas besoin de ligne de commande pour cela, et les agents de bureau sont justement conçus pour qu’il n’y en ait pas.
Le bureau, des agents pour le travail de bureau
Le second tableau mélange des publics différents. Cursor et Windsurf sont des IDE avec agent intégré, des outils d’ingénieur. L’application Codex s’adresse aux ingénieurs comme à tous les autres : elle affiche git, les worktrees, les vérifications dans le navigateur, les fichiers et les artefacts de façon visuelle, sans terminal. Antigravity 2.0 est une plateforme pour ingénieurs. Au manager, il faut quatre lignes de ce tableau : Cowork, Copilot Cowork, Kimi Work et WorkBuddy.
Claude Cowork · Anthropic
- Pour qui : travail de bureau
- Prix : Pro / Max / Team
Les sessions vivent dans le cloud ; l’agent accède aux dossiers locaux via l’application distincte Claude Desktop. Lancé en janvier 2026.
Codex, application · OpenAI
- Pour qui : ingénieurs et non-ingénieurs
- Prix : offre ChatGPT
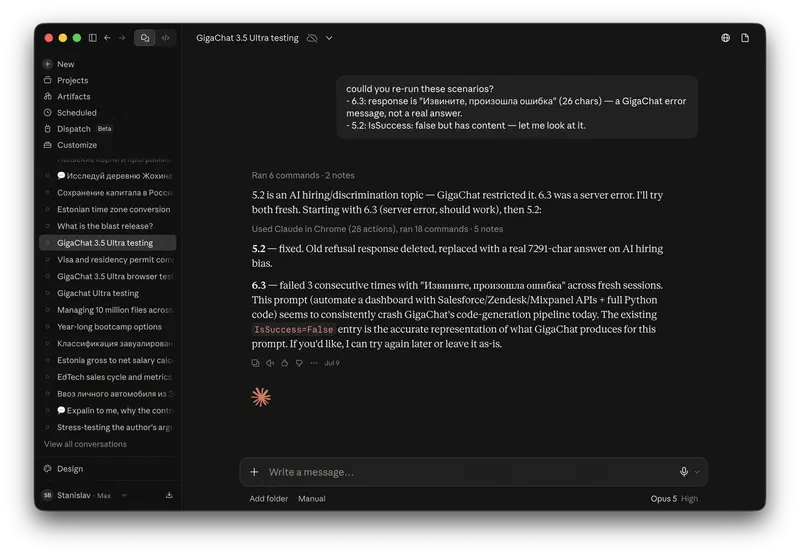
git, worktrees, vérifications dans le navigateur et artefacts sont affichés visuellement ; pas besoin de terminal.
Antigravity 2.0 · Google
- Pour qui : ingénieurs
- Prix : gratuit / 20 $ / 249,99 $
Une plateforme à cinq surfaces : IDE, application de bureau, CLI, SDK et Managed Agents API.
Kimi Work · Moonshot
- Pour qui : travail de bureau
- Prix : Moderato 19 $, Allegro 99 $, Vivace 199 $
Local par conception : monte les dossiers directement, travaille avec le navigateur où vous êtes connecté, s’exécute selon un planning. Un « essaim » de jusqu’à 300 sous-agents à partir de l’offre Allegro.
Copilot Cowork · Microsoft
- Pour qui : travail de bureau
- Prix : inclus dans l’abonnement Microsoft 365
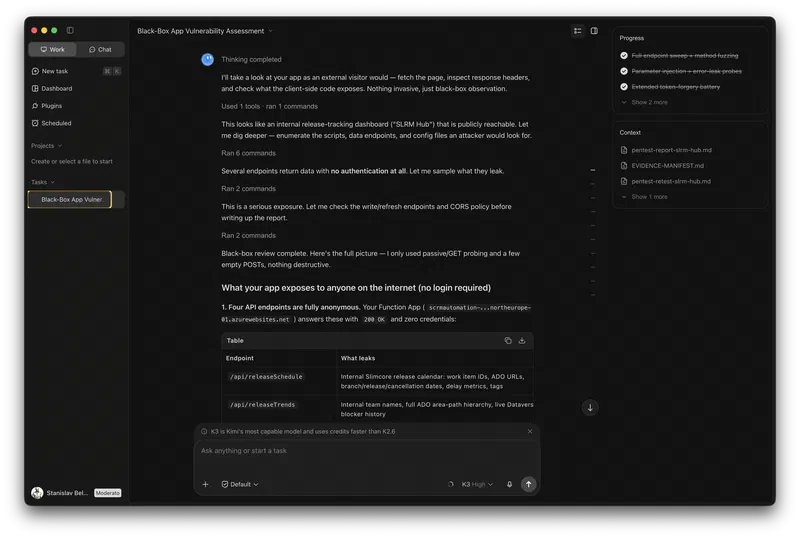
Un bac à sable cloud avec points de contrôle et journal d’audit, l’accès est accordé par l’administrateur. À l’intérieur, la technologie Claude Cowork d’Anthropic.
Tencent WorkBuddy · Tencent
- Pour qui : travail de bureau
- Prix : non publié
Découpe la tâche et remet pour validation des rapports, présentations et tableurs finis.
Cursor et Windsurf · tiers
- Pour qui : ingénieurs
- Prix : non traité dans cette revue
Des IDE avec agent intégré. Windsurf a une particularité : sa propre adresse redirige désormais vers le produit de bureau de Devin, si bien qu’il ne subsiste comme outil distinct que sur le papier.
Cloud ou machine locale
Au sein de ce groupe, il y a une différence qui pèse plus lourd, pour une entreprise soumise à des exigences sur ses données, que n’importe quelle liste de fonctions : l’endroit où l’agent traite les fichiers.
Claude Cowork garde par défaut les sessions dans le cloud. Il accède aux dossiers et applications locaux via l’application distincte Claude Desktop pour macOS et Windows – avec des autorisations : l’accès est accordé dossier par dossier. Ce qui entre dans la session est traité par l’infrastructure de l’éditeur.
Kimi Work fonctionne à l’inverse et vit sur la machine de l’utilisateur : il monte les dossiers directement, pilote le navigateur où vous êtes connecté via WebBridge, s’exécute selon un planning. Les données restent en local ; en contrepartie, l’agent agit au sein de vos sessions de navigateur et voit les dossiers montés dans leur intégralité. Le mode jusqu’à 300 sous-agents est disponible à partir de l’offre Allegro à 99 $ – détails dans la revue de Kimi.
Tencent WorkBuddy découpe la tâche et remet pour validation des rapports, présentations et tableurs finis. Ni les prix ni le fonctionnement interne n’étaient publics au moment de la rédaction de cette revue.
Copilot Cowork propose un troisième périmètre : un bac à sable cloud au sein de Microsoft 365, où l’administrateur accorde l’accès et où les actions de l’agent sont consignées dans un journal d’audit. Il repose sur la technologie Claude Cowork d’Anthropic, intégrée à Microsoft 365 Copilot : la même technologie est vendue sous deux marques, en direct par Anthropic et par Microsoft dans son abonnement. Pour le manager, le choix entre les deux se résume au périmètre, à l’administration et au lieu de stockage des données.
Agent Mode est un cas à part : c’est devenu le mode par défaut dans Word, Excel et PowerPoint. Les autres agents de bureau doivent être installés sur les postes de travail ; celui-ci y est déjà, ce qui en fait la base installée la plus large de tous les agents de cette revue.
Pour une entreprise soumise à des exigences sur ses données, Cowork et Kimi Work sont deux solutions différentes, à passer au crible d’une courte liste :
- où les fichiers sont traités : dans le cloud de l’éditeur ou sur la machine du salarié ;
- quelles autorisations l’agent reçoit et qui les accorde ;
- ce qui reste dans les journaux de l’éditeur après la session.
Les réponses à ces questions décident si la sécurité valide l’outil – bien avant toute discussion sur le prix.
La même liste vaut aussi pour les agents terminal, même si on la leur applique rarement. Un agent de bureau lit des tableurs et des documents. Un agent terminal lance des commandes sur la machine du développeur et voit le dépôt, les clés dans les variables d’environnement et l’historique des commits. Son rayon d’impact est plus large, et pourtant il passe moins souvent par la validation sécurité : l’ingénieur l’installe lui-même.
Là où les agents déçoivent
Les tableaux ci-dessus reposent sur les données des éditeurs. Le comportement de ces outils en conditions réelles se voit chez les praticiens qui les décortiquent sur leurs chaînes. Dans huit de ces analyses, publiées entre août et septembre 2026, quatre thèmes reviennent. Ce sont des observations individuelles, sur leurs propres tâches et leur propre matériel, pas des mesures.
Les autorisations sont ouvertes par défaut. L’environnement minimal Pi démarre avec un accès à tout : l’auteur de la revue montre l’agent sortir du dépôt et y voit une commodité. Dans Oh My Pi, le mode d’approbation des outils par défaut s’appelle YOLO, et la première chose que le testeur recommande de changer, c’est de le passer en demande de confirmation. D’origine, l’outil est réglé pour la vitesse ; la prudence, c’est l’utilisateur qui l’active.
La prudence s’émousse avec le temps. Le même auteur décrit son propre parcours : au début, il limitait l’agent à un seul dépôt, puis « la confiance est venue » et les restrictions ont disparu. Il le présente comme un signe de maturité. Pour qui répond du périmètre, c’est une courbe de risque croissant, tracée par l’utilisateur lui-même.
Un agent autonome laisse des traces. Un praticien qui fait tourner des agents pendant des jours le dit sans détour : ils créent des fichiers, modifient des commandes, laissent derrière eux des scripts automatiques et « finissent par détruire la machine si personne ne les surveille ». Chaque étape prise isolément semble anodine ; le problème s’accumule sur des semaines.
Les plugins d’un projet tout neuf sont un risque à part. Dans les trois semaines qui ont suivi la sortie de DeepSeek Harness, un écosystème de plugins a poussé autour ; dans l’installation par défaut, l’auteur de l’un des guides en a compté environ 165. Un autre testeur, la chaîne AI RANEZ, prévient que parmi les plugins publiés certains sont malveillants et compare la situation à ce qui s’est déjà passé autour d’OpenCode. L’open source et une communauté active accélèrent le développement – et élargissent en même temps la surface d’attaque.
Un dernier thème n’apparaît que dans un guide d’installation détaillé. Déployer DeepSeek Harness sur un serveur vierge prend à l’auteur environ vingt-cinq minutes : mémoire insuffisante, swap à créer à la main, build qui plante. Il obtient les commandes auprès de la version chat de DeepSeek et les colle dans le terminal, avec ce commentaire : « on n’a rien réfléchi nous-mêmes, on a juste copié-collé ». Un outil dont l’installation exige une deuxième IA coûte plus cher que ne le laisse croire le mot « gratuit ».
Prompts système : ce que redoute chaque éditeur
La conception d’un agent se lit dans son prompt système – les instructions que le modèle reçoit avant le premier message de l’utilisateur. Ces textes sont accessibles publiquement, de Claude Code et Cursor à ZCode et Google Antigravity ; la collection se trouve dans un dépôt GitHub. On y voit ce que redoute chaque éditeur.
Presque toutes les règles du prompt de Cursor portent sur le compte rendu d’avancement : status_update_spec, summary_spec, completion_spec, todo_spec. Sur la qualité du code, presque rien. Ces règles verrouillent une défaillance précise : l’agent cesse de rendre compte de l’avancement, et l’utilisateur ne comprend plus ce qui se passe.
Le prompt de ZCode se compose presque entièrement de restrictions d’environnement : ne lance pas de serveur de développement, ne fais pas de build, l’utilisateur ne voit que le port 3000 et une seule route. C’est un CLI pour projets Next.js, et ces restrictions couvrent le risque principal : casser ce qui ne peut pas être annulé. Sur le modèle GLM et son éditeur, nous avons une revue dédiée.
Dans le prompt de Claude Code, les règles définissent quand l’agent livre un fichier et quand il répond dans le chat, et exigent de lire SKILL.md avant de créer le moindre fichier.
Le volume de ces instructions diminue avec le temps. Le 21 juillet 2026, Anthropic a réduit d’environ 80 % le prompt système de Claude Code pour les modèles de pointe : exemples supprimés, une partie des interdictions strictes aussi, car les nouveaux modèles travaillent mieux avec du contexte qu’avec une liste de règles [Simon Willison]. Les instructions raccourcissent à mesure que le modèle se débrouille seul.
Lus côte à côte, ces textes révèlent ce que les annonces de version taisent. Les éditeurs considèrent l’écriture de code comme un problème résolu : quelques lignes à peine lui sont consacrées. Des dizaines de pages décrivent autre chose : comment l’agent rend compte de l’avancement, ce qu’il lui est interdit de toucher, sous quelle forme il livre le travail. La partie difficile d’un agent, c’est la prévisibilité et la redevabilité.
Le manager qui confie du travail à un agent a exactement le même problème à résoudre : ce qui compte comme terminé, à quelle fréquence l’agent rend compte, quelles zones lui sont fermées, comment le résultat est vérifié. Les éditeurs l’ont résolu par des instructions pour leurs propres outils. Pourquoi la vérification et la responsabilité restent du côté humain : voir Déléguer à l’IA (en russe).
Le modèle d’une telle instruction tient en quatre lignes :
- critère de livraison : quel fichier, dans quel format et avec quels champs constitue le résultat ;
- fréquence du compte rendu : l’agent rend compte de l’avancement après chaque étape ou à intervalle fixe ;
- zones interdites : dossiers, dépôts et services auxquels il n’accède pas ;
- méthode de vérification : ce que l’humain ouvre en premier pour confronter le résultat aux sources.
Sur une tâche réelle – la synthèse hebdomadaire d’un projet –, cela donne :
- critère de livraison : un fichier
weekly.mdavec les sections « Fait », « Risques », « Décisions à prendre » ; chaque point renvoie à un ticket du gestionnaire de tâches ; - fréquence du compte rendu : un message après chaque source – gestionnaire de tâches, e-mail, agenda ;
- zones interdites : les dépôts et les échanges en dehors du canal du projet ;
- méthode de vérification : ouvrir la section « Risques » et vérifier chaque point par rapport au ticket auquel il renvoie.
Déploiement contre usage réel
La facture des licences arrive, que l’équipe ouvre l’outil ou non. LeadDev a mesuré l’écart entre les deux : une enquête auprès de près de 600 ingénieurs et responsables techniques, 2026. Claude Code est acheté dans 78 % des équipes, et 50 % l’utilisent chaque jour. Pour GitHub Copilot, l’écart est plus grand : 56 % contre 14 %. Pour la version web de Claude, 64 % contre 18 % [LeadDev].
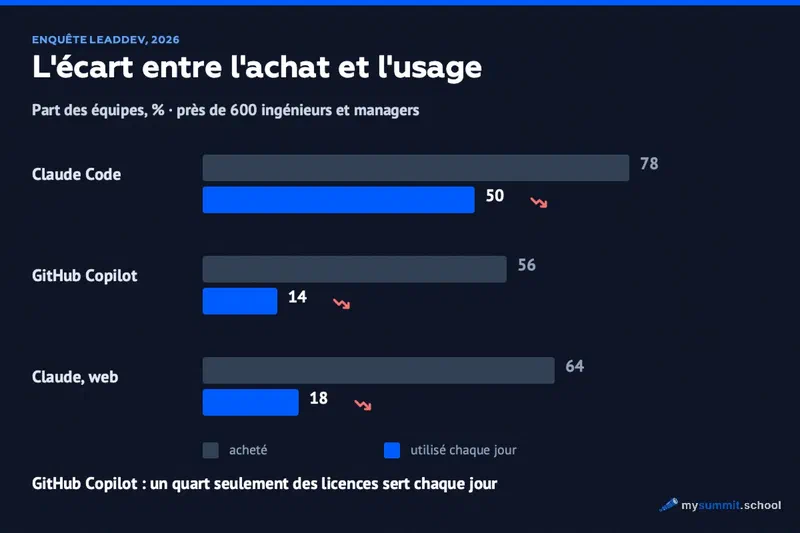
L’explication des auteurs est simple : l’outil est choisi d’en haut, et les ingénieurs se dispersent vers ce qui leur convient le mieux. Selon leur formule, l’écart dans les chiffres est un problème d’achat qui se fait passer pour un problème d’adoption. La question qu’ils proposent de poser à la recette : pourquoi les salariés contournent-ils l’outil validé en quête de mieux ?
Selon la même enquête, 31 % des entreprises mesurent l’effet de l’outil.
Par quoi remplacer la part de licences activées, Kilo le décrit sur son blog. C’est la méthode d’un éditeur, à lire en tenant compte de la source, mais l’ensemble d’indicateurs est raisonnable : profondeur d’usage plutôt que couverture, part des pull requests avec revue automatique, part des sessions d’agent qui vont jusqu’au merge, et rétention des pratiques – l’équipe travaille-t-elle avec des modèles communs ? Leur propre réserve : au-delà de 80 % d’activation, ce chiffre ne dit plus rien.
Pour le manager, un deuxième chantier apparaît ici. Choisir l’outil prend une semaine ; vérifier qu’il est utilisé prend des trimestres.
Choisir sans réponse unique
Il n’y a pas, dans cette revue, d’outil qui conviendrait à tout le monde. La décision se construit à partir de trois questions, toutes déjà évoquées :
- qui se met aux commandes de l’agent : pour l’ingénieur, la liste terminal ; pour le manager d’équipe, les agents de bureau ;
- où les données de l’entreprise peuvent se trouver : cloud de l’éditeur, Cowork ; machine locale, Kimi Work ; interdiction des services externes, CLI open source avec votre propre clé ;
- quel horizon pour la décision : la chronologie de l’année promet des mois ; une licence ouverte réduit le risque, car la communauté maintient le code même quand l’éditeur passe à autre chose. Aider montre l’envers du décor : l’ouverture ne garantit pas le rythme de développement.
Ramené à trois points de départ :
- une équipe de quinze personnes au plus, sans validation sécurité : un CLI open source avec votre propre clé, OpenCode ou Oh My Pi ; licence MIT, fournisseur modifiable par simple configuration, aucun compte éditeur en jeu ;
- une entreprise soumise à des exigences sur ses données : Copilot Cowork, si vous êtes déjà sous Microsoft 365 ; administration et journal d’audit sont intégrés. Quand le traitement doit rester sur la machine du salarié, seul Kimi Work convient ;
- une équipe d’ingénierie qui veut un seul outil pour tous : Claude Code si Anthropic est un fournisseur validé chez vous, et Kilo Code quand comptent à la fois le terminal, l’IDE et une facture par poste prévisible.
Le choix du modèle à l’intérieur de tout cela relève d’une autre couche : les agents ne changent pas moins vite que les modèles. Comment choisir entre les modèles eux-mêmes, c’est l’objet de l’article comparatif de la série, avec un tableau de synthèse par tâche et par budget. Le prochain volet de la série portera sur l’environnement de l’agent : outils MCP, accès aux données de l’entreprise et journal des actions.
Reste une question qui ne figure dans aucun tableau. Les outils les plus autonomes de 2026 exigent les instructions de redevabilité les plus longues : moins l’humain participe au travail, plus il faut de texte pour les règles de livraison et de vérification. Les éditeurs ont écrit ce texte pour leurs agents. Pour les tâches de votre équipe, il reste à écrire – et qui s’en chargera : l’ingénieur qui installe l’agent, ou le manager qui réceptionne le travail ?
L'agent est prêt. Le pilotage revient au manager
Spécialisation Gestion de projet : vous monterez un système d'exploitation de PM sur un agent open source – synthèse matinale depuis Jira, Slack et l'agenda, rapports à partir des exports du gestionnaire de tâches, routines pour les situations de crise.
Stanislav Belyaev
Engineering Leader chez Microsoft18 ans a diriger des equipes d'ingenieurs. Fondateur de mysummit.school. 700+ diplomes chez Yandex Practicum et Stratoplan.