GigaChat au travail : tirer le meilleur de l'IA souveraine russe
AI-модели в этой статье
GigaChat est le grand modèle de langage de Sber, la première banque russe. Hors de Russie, presque personne ne l’utilise. En Russie, c’est souvent la seule option : banques, administrations, industrie de défense et grands groupes industriels le font tourner sur leurs propres serveurs, parce que les règles russes de localisation des données et les sanctions excluent ChatGPT, Claude et Gemini. Si vous travaillez avec une équipe russe, une filiale en Russie ou un client d’un secteur régulé là-bas, c’est l’outil qu’ils ont sous la main.
Ce guide a été écrit pour ces utilisateurs quotidiens, et cela se voit : les exemples sont des contrats russes, des lois russes, des prix en roubles. Pour les autres lecteurs, c’est une étude de cas sur un problème plus large : comment obtenir un travail correct d’un modèle « souverain » ou déployé en interne, en retard sur l’état de l’art, quand c’est la réglementation et non la qualité qui a imposé ce choix.
Tapez « GigaChat » dans un moteur de recherche russe et vous tomberez sur deux types de contenus : des revues promotionnelles signées par des partenaires de Sber et des critiques méprisantes d’utilisateurs de ChatGPT. Ni l’un ni l’autre n’aide quand il faut écrire un prompt tout de suite et obtenir un premier jet exploitable.
Voici donc un guide pratique. Ce qu’il faut faire pour que GigaChat produise 20 à 30 % mieux. Ce qu’il faut éviter pour ne pas dégrader le résultat. Et où passe la limite au-delà de laquelle aucun prompt ne vous sauvera et où il faut un autre outil.
Là où GigaChat a sa place
Avant les techniques, une carte honnête de ses points forts. Il existe trois terrains où GigaChat fait aussi bien, voire mieux, que la concurrence.
Le déploiement sur site : son principal atout
GigaChat est le seul LLM russe proposant un véritable déploiement on-premise. Selon Sber, 65 % des contrats GigaChat Enterprise sont réalisés on-premise ou en cloud privé.
SIBUR, le groupe pétrochimique, utilise déjà GigaChat pour des assistants de diagnostic (l’ingénieur décrit les symptômes d’un équipement, le système propose des hypothèses de réparation) et pour un optimiseur d’achats. Le sidérurgiste Severstal a étendu l’IA à un millier de salariés au quotidien et à plus de 60 solutions en huit ans.
Pour les banques, l’industrie de défense et les prestataires de l’État, c’est décisif : les données ne quittent pas le périmètre, le modèle est conforme à la loi 152-FZ (la loi russe sur les données personnelles) et il existe une piste d’audit conforme aux exigences de la Banque de Russie. ChatGPT, Claude et DeepSeek n’offrent rien d’équivalent en Russie. Si votre organisation ne peut pas envoyer de requêtes vers des clouds étrangers, la question du choix ne se pose pas, et cette section est pour vous.
La correspondance officielle
GigaChat a été entraîné sur un corpus de documents administratifs et d’entreprise russes, et cela se sent dans les textes formels : numéros d’enregistrement, lignes de référence, niveau de formalité des formules d’appel, disposition des mentions telle que la fixent les normes russes GOST. ChatGPT et DeepSeek trébuchent plus souvent sur ces éléments : ils inversent l’ordre des mentions ou glissent vers un registre familier dans un courrier officiel.
Une réserve : il s’agit d’une observation de terrain, pas du résultat de tests systématiques. Dans notre benchmark, GigaChat obtient de faibles scores en « communication » et en « connaissance régionale », mais le benchmark mesure la qualité analytique des réponses, pas l’exactitude de la mise en forme. Si vous rédigez des courriers officiels pour l’administration russe, essayez GigaChat et comparez-le à votre outil habituel sur un vrai modèle de document.
Documents juridiques : la forme oui, le fond à vérifier
En 2025, GigaChat battait nettement ChatGPT 4 sur l’identification des textes réglementaires russes. En 2026, l’écart s’est refermé : DeepSeek V4 Flash l’a rattrapé et le dépasse par endroits sur la précision des références à des articles précis (tests détaillés dans la section « Là où le prompt ne suffit plus », plus bas). GigaChat met toujours mieux en forme les documents juridiques : mentions obligatoires, numéros d’enregistrement, formules de politesse. Mais les numéros d’articles et la logique des conclusions sont à revérifier, quel que soit le modèle.
Comment écrire ses prompts pour GigaChat : ce qui marche vraiment
Si vous reprenez tels quels vos prompts ChatGPT dans GigaChat, vous obtiendrez des résultats moins bons que possible. Les modèles ont été entraînés sur des corpus différents et calibrés différemment. Notre expérience sur les techniques de prompt, sur 1 717 exécutions, a montré que le bon prompt améliore les réponses de GigaChat de 20 à 30 %.
Un piège mérite un avertissement à part : les prompts rafistolés. Le scénario classique : un prompt fonctionnait sur GigaChat Pro, vous avez ajouté une consigne (« cite toujours ta source »), puis une autre (« n’invente pas de faits »), puis encore une (« réponds strictement d’après le document »). Chaque rustine réglait un problème précis, mais ensemble elles se contredisent : le modèle essaie à la fois de citer une source et de ne rien inventer, et finit soit par inventer la citation, soit par refuser de répondre. Quand Sber met à jour le modèle (et GigaChat est mis à jour sans préavis), les anciens contournements deviennent gênants. Avant d’ajouter de nouvelles consignes, vérifiez qu’elles ne doublonnent pas ou ne contredisent pas celles qui existent.
Voici des techniques précises, vérifiées sur des données. Une remarque d’abord : GigaChat est optimisé avant tout pour le russe, et toutes nos mesures ont été faites avec des prompts en russe. Les prompts traduits ci-dessous tournent sur les mêmes modèles pour que vous puissiez comparer vous-même, mais attendez-vous à un GigaChat moins performant en français qu’en russe.
L’impératif plutôt que les questions polies
GigaChat a appris sur des documents administratifs et d’entreprise russes, où le style directif est la norme. Les prompts à l’impératif obtiennent des réponses plus concrètes.
Ce conseil est ancré dans la grammaire russe. Un utilisateur russe écrirait spontanément « Можно ли подготовить анализ… ? » (« Serait-il possible de préparer une analyse… ? »). La version qui fonctionne mieux emploie des impératifs secs : « подготовь » (« prépare »), « укажи » (« indique »), « сформируй » (« établis »). En français, c’est la différence entre « Pourrais-tu éventuellement… ? » et « Prépare… » ; le principe vaut pour la plupart des modèles, mais l’effet que nous avons mesuré concerne le russe.
Testez sur un exemple réel : les deux prompts tournent sur le même GigaChat, mais le premier est rédigé comme on écrit d’habitude à ChatGPT, le second est adapté :
Le prompt naïf donne à GigaChat l’occasion de répondre « oui, c’est possible » et de livrer un panorama général qui cite le RGPD (qui ne s’applique pas à un service russe). Le prompt structuré obtient un tableau concret avec numéros de lois et mesures. Toute la différence tient à la formulation de la demande.
Le rôle : plus important que dans ChatGPT
Dans ChatGPT, un rôle système aide, mais le corps du prompt pèse souvent davantage. Dans GigaChat, le contexte organisationnel a plus de poids.
Faible : « Vérifie la conformité de ce contrat à la 44-FZ. »
Plus fort : « En tant que directeur juridique d’un acheteur public, analyse le projet de contrat au regard de la loi 44-FZ sur les marchés publics. L’acheteur est un établissement public, le prix maximal initial du marché est inférieur à 3 millions de roubles, l’achat se fait auprès d’un fournisseur unique. Relève les clauses à corriger et propose une rédaction. »
(La 44-FZ est la loi fédérale russe sur la commande publique, l’équivalent approximatif de notre Code de la commande publique.) La seconde version fixe la position juridique, le contexte de la procédure et le livrable attendu, et GigaChat exploite mieux cette structure qu’une demande courte.
Une structure en trois temps pour les tâches complexes
Pour les questions juridiques et de conformité, une formule en trois blocs fonctionne : (1) rôle et objectif avec référence aux textes, (2) contraintes de contexte, (3) format de sortie attendu.
Exemple : « [1] En tant que juriste d’une entreprise industrielle russe, réalise l’analyse juridique d’un projet de contrat de fourniture au regard du Code civil de la Fédération de Russie (chapitres 30 et 25) et de la jurisprudence des tribunaux de commerce. [2] Le fournisseur est un entrepreneur individuel, l’acheteur une SARL, le montant du contrat est de 1,5 million de roubles, la livraison se fait en trois étapes, l’acompte est de 50 %. [3] Résultat : liste des risques par section du contrat, modifications de rédaction recommandées, clauses conformes à la jurisprudence. »
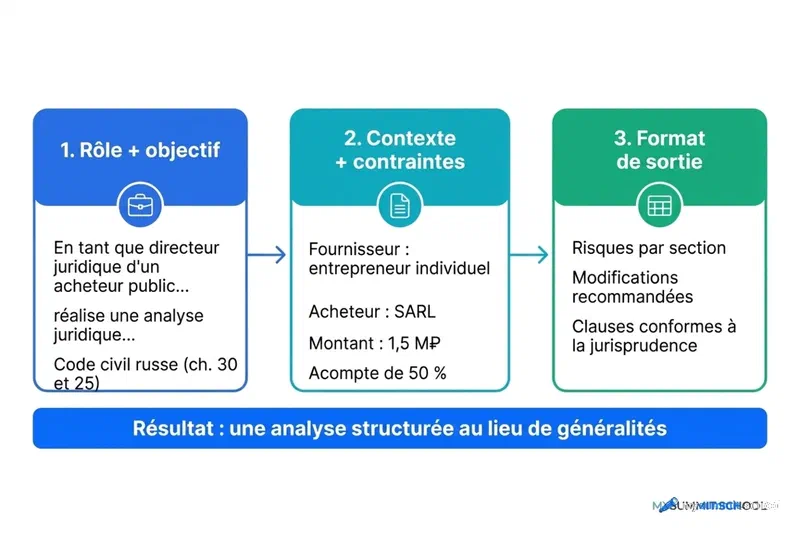
Cette structure réduit la part de réponses superficielles, principal point faible de GigaChat d’après notre benchmark.
Si vous passez par l’API, ajoutez aux paramètres de l’appel une séquence d’arrêt (stop) avec la balise fermante de votre format, par exemple </réponse> ou </résultat>. Le modèle s’arrêtera exactement où il faut, sans « postface » qui casse votre parsing. C’est gratuit : le prompt ne change pas et aucun token supplémentaire n’est consommé.
Demander des contre-arguments
Sur les zones grises réglementaires, GigaChat a tendance à donner des réponses assurées mais pas toujours exactes. Une technique qui marche : avant la conclusion, demander des arguments dans les deux sens.
« Donne trois arguments en faveur du fait que cette activité est soumise à licence et trois arguments contre. Puis donne ton évaluation finale en précisant quels faits seraient déterminants. »
Le modèle est ainsi obligé d’envisager d’autres interprétations avant de se prononcer, et les hallucinations sur les questions réglementaires se raréfient.
Derrière cette technique se cache un principe plus général : chaque fois que vous contraignez le modèle, énoncez les deux côtés du compromis.
Faible : « Sois concret. Pas de formulations vagues. Appuie chaque affirmation sur une référence réglementaire. »
Plus fort : « Sois concret, mais si tu n’es pas sûr de l’exactitude d’une référence, dis-le franchement. Une référence erronée à un article de loi est plus dangereuse qu’un honnête “à vérifier dans le texte source”. »
La première version pousse GigaChat vers des affirmations assurées mais non vérifiées : le modèle remplira chaque point d’une référence, même s’il s’en « souvient » mal. La seconde lui laisse la marge de bien se comporter dans les deux sens. Notre expérience l’a confirmé sur les données : un ton agressif dans le prompt a totalement supprimé chez GigaChat l’aveu d’incertitude. Le modèle a cessé de nuancer, sans devenir plus précis. L’exactitude factuelle est même passée de 71 % à 70 %.
Limite de contexte : 25 000 tokens
La fenêtre de contexte de GigaChat 2 Max est de 32 000 tokens, contre 128 000 et plus chez les concurrents. Pour des résultats fiables, restez sous 25 000 : au-delà, la qualité se dégrade.
Une astuce n’a de sens qu’en russe, où les lois portent des intitulés officiels interminables. Écrivez « ФЗ-44 » (« loi 44-FZ ») plutôt que l’intégralité de « Федеральный закон от 05.04.2013 № 44-ФЗ „О контрактной системе в сфере закупок товаров, работ, услуг для обеспечения государственных и муниципальных нужд" » (« loi fédérale n° 44-FZ du 5 avril 2013 relative au système contractuel de passation des marchés de fournitures, travaux et services pour les besoins de l’État et des collectivités »). Sur un long document, les tokens économisés s’accumulent. L’habitude sous-jacente – des noms courts et constants pour ce que vous citez souvent – vaut dans toutes les langues.
Pour le prompting en général, voir nos articles sur la structure de base d’un prompt et les mythes les plus répandus (en russe).
Les techniques de prompt sont le minimum qui fonctionne sans coût supplémentaire. Mais pour les appliquer à bon escient, il faut savoir quand GigaChat produit un résultat correct et quand il se trompe avec aplomb sans que vous le remarquiez. C’est cette frontière que nous allons tester maintenant, sur des tâches réelles.
Les techniques de prompt de cet article tirent 20 à 30 % de plus de GigaChat. Vérifier la réponse est la même compétence quel que soit le modèle – GigaChat, DeepSeek ou Claude. Dans le module gratuit du cours, vous la travaillez sur 9 cas de management et apprenez à distinguer un bon résultat d'une hallucination.
Sans paiement requis • Notification au lancement
Là où le prompt ne suffit plus
Les prompts réorganisent ce que le modèle sait déjà ; ils ne créent pas de connaissances absentes de ses poids. Notre expérience Make Weak Model Great Again l’a montré chiffres à l’appui : si GigaChat n’a pas « vu » un texte réglementaire pendant son entraînement, aucun prompt du type « tu es un avocat expérimenté en droit du travail russe » ne lui fera citer correctement le code.
Pour voir où passe cette limite, nous avons soumis GigaChat et DeepSeek V4 Flash à deux tâches réelles. Nous les avons exécutées en russe ; les versions françaises ci-dessous vous permettent de les reproduire.
Test 1 : une crise managériale
Ce qu’il faut observer : GigaChat via l’API produit un plan structuré mais générique – toutes les actions reviennent au « chef de projet », les indicateurs sont du type « retours positifs », sans priorisation jour par jour. DeepSeek V4 Flash distingue les symptômes des causes profondes, répartit les responsabilités entre des rôles précis et prévient de ce qu’il vaut mieux ne pas faire.
GigaChat Ultra dans l’interface web fait nettement mieux : il répartit les rôles, ajoute l’eNPS et des comptes rendus. Mais Ultra n’est disponible que sur le web, pas via l’API. Et en mode raisonnement, Ultra a commis une erreur factuelle : il a proposé « d’organiser un transfert de connaissances depuis les développeurs partis », alors que l’énoncé précise qu’ils sont partis chez un concurrent il y a un mois. Nous expliquons plus bas pourquoi le mode raisonnement est contre-productif.
Test 2 : la réglementation russe (152-FZ)
La 152-FZ est la loi russe sur les données personnelles, en gros l’équivalent local du RGPD. GigaChat joue ici à domicile.
C’est une tâche où GigaChat devrait être sur son terrain. Vérifiez trois choses : (1) quel modèle distingue correctement les catégories particulières (art. 10) et les données biométriques (art. 11), (2) lequel remarque que le portail dépasse le cadre de la relation de travail, ce qui rend obligatoire la notification à Roskomnadzor, le régulateur russe de la protection des données, (3) lequel ne confond pas les numéros d’articles.
Dans nos tests, le GigaChat de l’API a confondu l’art. 9 (consentement) avec l’art. 10 (catégories particulières). DeepSeek V4 Flash a correctement cité tous les articles applicables, distingué les catégories de données et donné les montants des amendes prévues par le Code russe des infractions administratives. GigaChat Ultra en mode normal a fait mieux – il a cité correctement l’art. 10 et l’art. 11 –, mais Ultra n’est disponible que dans l’interface web, pas via l’API.
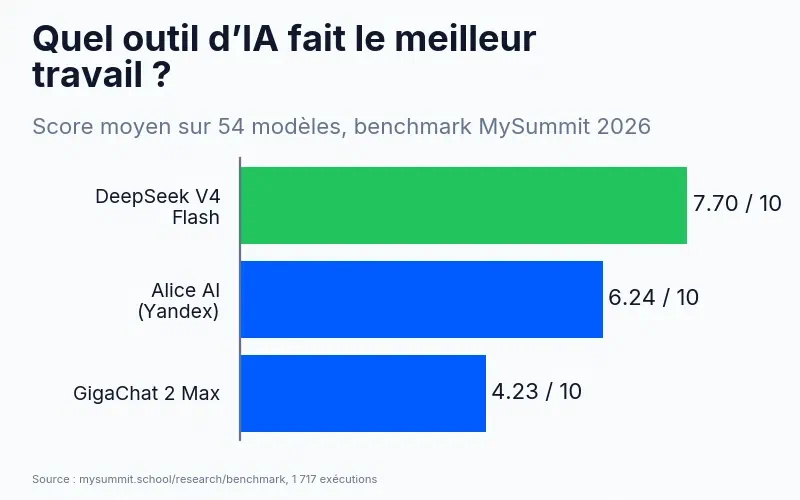

La conclusion honnête : l’avantage de GigaChat sur les tâches juridiques était réel en 2025, face à ChatGPT 4. En 2026, DeepSeek V4 Flash a comblé l’écart. GigaChat reste meilleur sur la forme des documents (mentions, numéros d’enregistrement, style formel), mais sur le fond – exactitude des références et logique des conclusions – la différence a disparu.
Le piège du mode raisonnement
Un avertissement à part : n’utilisez pas le mode raisonnement de GigaChat pour des tâches qui exigent des références exactes.
Nous avons soumis la même tâche juridique à GigaChat Ultra dans les deux modes. En mode normal, le modèle a correctement cité l’art. 10 et l’art. 11. En mode raisonnement, il a invoqué l’art. 8 (sources accessibles au public, sans rapport avec la question) et a complètement omis l’art. 11. Le raisonnement semblait logique, mais il a mené à de mauvaises références.
C’est cohérent avec les travaux de Wei et al. (Google Brain, 2022) et avec nos données issues de l’expérience MWMGA : chez les petits modèles, le chain-of-thought provoque des raisonnements assurés mais faux. Le modèle génère cinq étapes qui paraissent logiques et aboutit à une conclusion erronée. Pour la même raison, ne demandez pas à GigaChat « d’améliorer sa réponse » : des recherches (Zhang et al., ACL 2024) ont montré que les petits modèles sont incapables de repérer leurs propres erreurs et, au lieu de se critiquer, reformulent la même réponse.
La règle pratique : posez la bonne structure dès la première requête (la formule en trois temps ci-dessus). N’itérez pas, n’activez pas le raisonnement : ce ne sera pas meilleur.
Ces tests montrent une chose précise : la différence entre un bon et un mauvais résultat ne tient pas au choix du modèle, mais à la capacité de vérifier la réponse. GigaChat a cité l’art. 9 au lieu de l’art. 10, et si vous ignorez que les catégories particulières relèvent de l’art. 10, vous prendrez l’erreur pour la vérité. C’est exactement ce qu’enseigne notre cours : distinguer une réponse fiable d’une hallucination sûre d’elle.
GigaChat a confondu l'art. 9 et l'art. 10. L'auriez-vous remarqué ? Le module gratuit du cours propose 9 cas où vous apprenez à vérifier les réponses de l'IA sur de vraies situations de management.
Sans paiement requis • Notification au lancement
Quand changer d’outil
Notre expérience MWMGA a montré que choisir le bon modèle pour la tâche rapporte plus que de peaufiner des prompts pour un modèle inadapté. La fidélité à un outil est une habitude coûteuse.
Même si GigaChat est votre outil principal, certaines tâches gagnent à être confiées à un autre :
| Tâche | GigaChat s’en sort ? | Alternative |
|---|---|---|
| Correspondance officielle aux normes russes | Essayez – d’après notre expérience, meilleur sur la forme | Comparez avec DeepSeek sur votre modèle de document |
| Premier jet d’un document juridique | La forme oui, le fond à vérifier | DeepSeek V4 Flash pour recouper les références |
| Analyse, planification, raisonnement complexe | Faible – mal classé au benchmark | DeepSeek / Claude / ChatGPT |
| Documents longs (>25K tokens) | Non – la qualité se dégrade | Claude / Gemini (contexte 128K+) |
| Génération de code | Faible – 25 à 35 % moins bon | DeepSeek |
| Réglementation internationale | Non – la précision tombe à 65 % | ChatGPT / Claude |
| Tâches créatives | Faible – 40 % de moins en originalité | ChatGPT |
DeepSeek V4 Flash fonctionne en Russie sans VPN, coûte environ 25 roubles le million de tokens et devance nettement GigaChat dans notre benchmark. Alice AI, de Yandex, fait également mieux. Pour comparer les alternatives russes, voir notre revue de YandexGPT et notre comparatif complet des outils.
Si vous travaillez en environnement fermé et que changer d’outil est impossible, ce n’est pas une fatalité, ce sont vos conditions de travail. Voici à quoi ressemble un processus efficace : une juriste de banque reçoit un projet de contrat, le passe dans GigaChat avec la formule en trois temps (rôle + contraintes + format) et obtient une première analyse structurée en trois minutes au lieu d’une heure. Elle vérifie ensuite les numéros d’articles dans les textes sources, ce qui prend encore dix minutes. Bilan : une tâche d’une heure et demie bouclée en un quart d’heure, en sachant précisément quelles parties de la réponse sont fiables et lesquelles exigent une vérification manuelle.
La compétence clé ici consiste à distinguer la partie fiable d’une réponse d’une hallucination. Les prompts organisent ce que le modèle sait déjà ; ils ne créent pas de connaissances.
Combien ça coûte en pratique
Le tableau honnête de notre propre usage : nous avons acheté un forfait de 6 millions de tokens pour 3 450 roubles. En un mois, nous avons envoyé environ 900 requêtes et consommé moins d’un cinquième du forfait. Le prix réel du token est ressorti 5,6 fois au-dessus du prix affiché.
C’est le propre des forfaits prépayés : sans volume élevé et régulier, vous payez trop. Depuis 2026, les tokens non utilisés sont reportés pendant 90 jours, ce qui atténue un peu le problème.
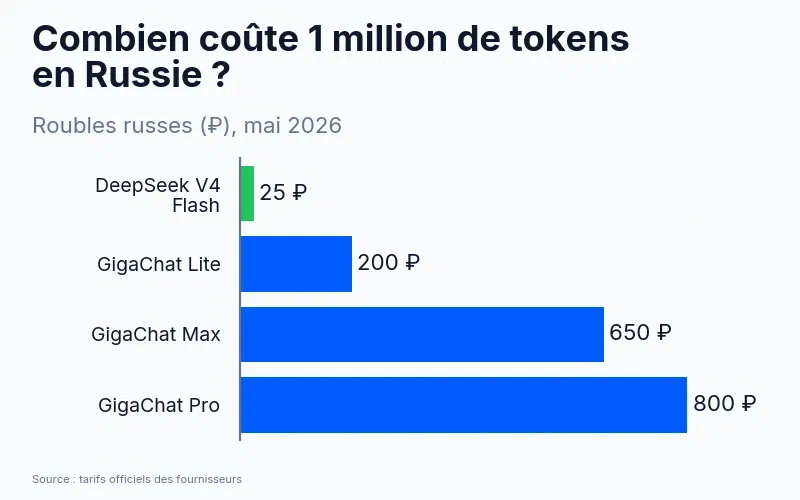
Côté offres : Lite (~200 roubles le million de tokens) couvre environ 90 % des tâches courantes – brouillons, synthèses, courriers simples. Pro (~800 roubles) est le meilleur choix pour le travail réglementaire. Max (~650 roubles) est présenté comme le haut de gamme, mais notre benchmark lui donne un résultat faible : inutile de payer Max pour des tâches où GigaChat n’excelle pas de toute façon.
Pour comparaison : DeepSeek V4 Flash coûte 25 roubles le million de tokens, pour une qualité nettement supérieure. Plus de détails dans notre revue de DeepSeek et notre comparatif des outils d’IA pour managers en Russie.
Si vous utilisez GigaChat via l’interface web plutôt que l’API, l’abonnement GigaChat Plus coûte 399 roubles par mois et inclut l’accès à Ultra. Pour la plupart des tâches de cet article, cela suffit. Le forfait API prépayé se justifie avec un volume élevé et prévisible, par exemple un service juridique de dix personnes qui analyse des contrats chaque jour. Pour un usage ponctuel, payer un forfait d’avance n’est pas rationnel.
Aide-mémoire : les règles pour travailler avec GigaChat
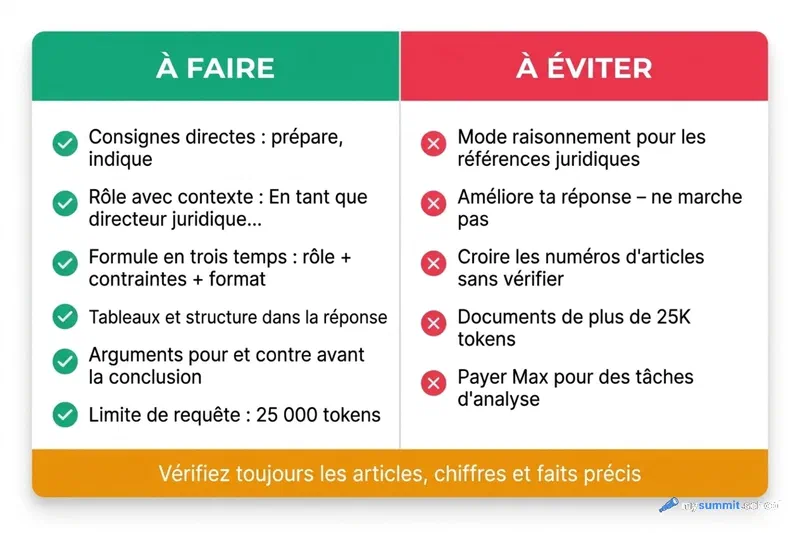
À faire :
- Écrire à l’impératif : en russe « подготовь », « укажи », « сформируй » (« prépare », « indique », « établis »)
- Donner un rôle avec contexte : « En tant que directeur juridique d’un acheteur public… »
- Utiliser la formule en trois temps : rôle + contraintes + format
- Exiger des tableaux et une structure dans le format de réponse
- Demander des arguments pour et contre avant la conclusion
- Énoncer les deux côtés du compromis : pas seulement « sois concret », mais aussi « si tu n’es pas sûr, dis-le franchement »
- Rester sous 25 000 tokens par requête
- Vérifier l’absence de consignes contradictoires avant d’en ajouter de nouvelles
À éviter :
- Activer le mode raisonnement pour des tâches citant des textes réglementaires
- Lui demander « d’améliorer » sa réponse ou d’y « trouver les points faibles »
- Se fier aux numéros d’articles sans les revérifier
- Utiliser GigaChat pour des documents de plus de 25K tokens
- Payer Max pour des tâches d’analyse et de planification
- Brusquer le modèle avec un ton agressif : il sera plus assuré, pas plus précis
Revérifiez systématiquement dès que GigaChat cite des articles, des chiffres ou des faits précis. Le modèle a l’air tout aussi sûr de lui, qu’il ait raison ou non.
Le prompt est écrit. La réponse est-elle juste ?
La compétence clé avec l'IA, c'est de vérifier le résultat. Dans le module fondamental du cours, vous travaillez la pensée critique avec l'IA sur de vraies tâches de management : distinguer une analyse approfondie d'une analyse superficielle, savoir quand faire confiance aux références et quand les revérifier. Commencez par le module de diagnostic gratuit : 9 leçons, sans inscription.
Stanislav Belyaev
Engineering Leader chez Microsoft18 ans a diriger des equipes d'ingenieurs. Fondateur de mysummit.school. 700+ diplomes chez Yandex Practicum et Stratoplan.