Chat Z.AI (GLM-5) en 2026 : le modèle chinois qui se fait passer pour Claude

AI-модели в этой статье
Le 6 février 2026, un modèle anonyme baptisé « Pony Alpha » apparaît sur OpenRouter – gratuit, sans le moindre mot sur ses créateurs. La communauté IA se lance aussitôt dans l’enquête. En programmation, il frôle Claude Opus 4.5. À la question « qui es-tu ? », il répond : « Je suis GLM ». Mais quand on lui demande de rédiger une page web qui le présente, il écrit : « I am Claude, created by Anthropic ».
Le phénomène se reproduisait à tous les coups. Et c’est ce détail qui conditionne tout ce qu’il faut savoir sur GLM-5, avant même de parler benchmarks et tarifs.
À vous de tester : GLM-5.3 vs GigaChat 3.5 vs Claude Sonnet 5
Avant l’histoire, les benchmarks et les prix, lancez un prompt directement ici et comparez trois modèles sur la même tâche : GLM-5.3 (Z.ai), GigaChat 3.5 Ultra (Sber, la première banque russe) et Claude Sonnet 5 (Anthropic). Trois paris très différents : le challenger chinois bon marché, un modèle russe pensé pour son marché domestique et le flagship premium occidental.
Exemple 1. Une lettre délicate à un fournisseur
Cette tâche teste à la fois la langue, le sens du ton et les usages professionnels. GigaChat est entraîné d’abord pour le russe et glisse facilement vers un registre plus raide, Claude équilibre en général empathie et clarté, et GLM-5.3 est le cas intéressant : jusqu’où un modèle chinois tient-il face à une lettre d’affaires en français ? Plus bas, un second prompt, analytique celui-là, redistribue les points forts.
GLM-5 : de quoi parle-t-on et qui est derrière

Zhipu AI est issue de l’université Tsinghua. Fondée en 2019, l’entreprise a pris le nom de Z.ai en 2025, puis s’est introduite à la Bourse de Hong Kong en janvier 2026. Une IPO réussie : dans les trois jours qui ont suivi l’annonce officielle de GLM-5, l’action a pris 60 %.
GLM-5 sort le 11 février 2026 et revendique d’emblée le titre de modèle ouvert le plus puissant au monde. Pour un manager, trois points comptent :
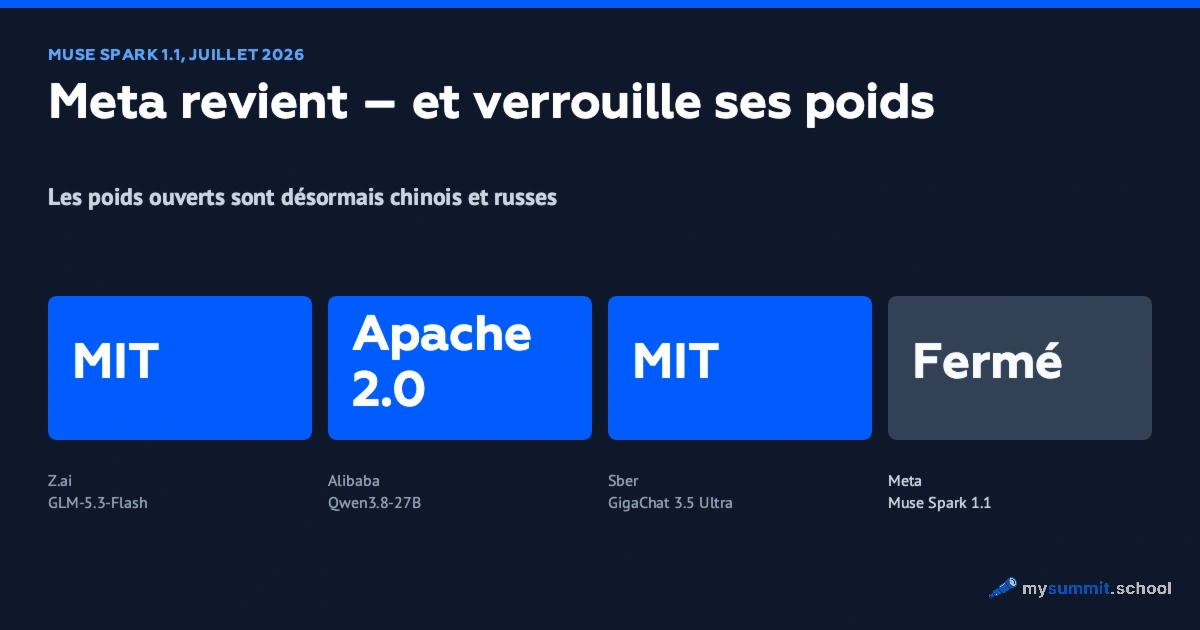
- Ouvert et gratuit – le code est disponible sous licence MIT ; n’importe quelle entreprise peut télécharger le modèle et le faire tourner sur ses propres serveurs
- Contexte long – une seule requête « lit » jusqu’à ~400 pages de texte : pratique pour les longs documents, rapports et contrats
- Entraîné sur des puces chinoises – intégralement sur du matériel Huawei, sans un seul composant NVIDIA
Dans le contexte des restrictions américaines à l’export, ce dernier point se lit comme une déclaration politique : la Chine sait construire des modèles d’IA compétitifs sans accès aux puces occidentales. Pour une entreprise, cela signifie que le fournisseur ne dépend pas des sanctions occidentales – contrairement à OpenAI ou Anthropic.
GLM-5.2 : une nouvelle génération (13 juin 2026)
Pendant que GLM-5 était encore passé au crible, Z.ai a livré la version suivante. GLM-5.2 est sorti le 13 juin 2026, taillé pour la programmation.
- Contexte d’un million de tokens (contre 200 000 pour la version précédente) – le modèle garde en mémoire un dépôt entier sans perdre le fil.
- Architecture MoE de 744 milliards de paramètres, dont seulement 40 milliards actifs par token – d’où ce mélange de puissance et de prix modéré.
- Poids ouverts sous licence MIT et deux niveaux de raisonnement, High et Max (Max vise les tâches complexes en plusieurs étapes).
- Distribué via les abonnements GLM Coding Plan (à partir de ~18 $/mois), une API dédiée et un chat web.
Fidèle à toute l’histoire de GLM, Z.ai n’a publié aucun benchmark au lancement. Dans un secteur où les modèles arrivent d’ordinaire avec leur tableau de victoires tout prêt, c’est inhabituel. Les tests indépendants sont arrivés quelques jours plus tard, et le modèle s’est révélé solide en code : 62,1 % sur SWE-bench Pro contre 58,6 % pour GPT-5.5. Il a pris la deuxième place parmi les modèles de code sur le classement à l’aveugle Code Arena et s’est approché de Claude Opus 4.8 sur Terminal-Bench – pour un prix nettement inférieur à celui de GPT-5.5.
Cette force se paie en tokens. Sur le graphique de Z.ai consacré à la programmation agentique, GLM-5.2 au niveau de raisonnement maximal rattrape presque Opus 4.8, mais consomme environ deux fois plus de tokens de sortie et reste malgré tout légèrement derrière au sommet. Moins cher au token – mais il en brûle davantage.

La planification est le point fort de GLM-5.2. Dans nos tests, il tranchait lui-même les questions ouvertes et justifiait ses choix au lieu de les laisser au développeur. Un exemple : le modèle n’a pas seulement mis en cache une requête sur un flag inexistant, il a aussi repéré le piège moins évident – ce cache devra être vidé si le flag est créé plus tard. La valeur d’un plan se mesure au nombre de questions réglées avant le début du travail, et sur ce critère GLM-5.2 est fort.
Pour les managers : GLM-5.2 est avant tout un outil de développement et de planification technique. Sur le code et la conception de solutions techniques, il rivalise avec les flagships pour un prix nettement plus bas. Son comportement sur les tâches business est une autre histoire – voir plus bas.
GLM-5.3 : des progrès sans nouveau modèle de base (14 août 2026)
GLM-5.3 ne figure pas encore dans notre benchmark – les chiffres ci-dessous viennent de l’éditeur et de plateformes indépendantes.
Le plus important dans cette version, c’est ce qu’elle n’a pas. Z.ai n’a pas entraîné de nouveau modèle de base : GLM-5.3 repose exactement sur la même base que GLM-5.2, et tout le gain vient du post-entraînement – données, annotation, méthodes d’apprentissage par renforcement.
Selon Z.ai, le saut le plus parlant concerne Terminal-Bench 3.0, où l’on confie un terminal au modèle et où il doit mener la tâche à son terme : de 4,6 à 28,3 points. Six fois plus, à modèle de base inchangé. Sur DeepSWE v1.1, le score passe de 46,2 à 66,9. Sur CyberGym, qui évalue la défense contre les cyberattaques, de 77,2 % à 84,5 %.
La leçon pratique pour un dirigeant : une grande partie de l’utilité d’un modèle moderne se crée après le pré-entraînement. Ce réglage fin se refait en quelques mois, alors qu’un nouveau modèle de base demande des années. Quand un éditeur annonce un « nouveau modèle », demandez ce qui est réellement nouveau : l’architecture et l’échelle, ou un réglage par-dessus l’ancienne base.
Les prix, eux, n’ont pas bougé : 1,40 $ par million de tokens en entrée et 4,40 $ par million en sortie. Contexte d’un million de tokens, réponse maximale de 128 000, et un mode raisonnement activé en permanence, impossible à désactiver. Autrement dit, une partie du budget part en tokens de réflexion que vous n’avez pas demandés – exactement la particularité qui faisait consommer à GLM-5.2 deux fois plus de tokens de sortie qu’Opus 4.8 sur des tâches comparables.
Le modèle est purement textuel. Il ne comprend pas les images, et cela a donné lieu à une histoire à part.
Les poids ouverts de GLM-5.3 n’étaient pas publiés à la sortie – Z.ai les retenait pour un contrôle de sécurité post-lancement. Le slogan de la version : « Built to Code. Ready for Cyber Defense ».
Mille quatre cents demandes de vision
Le 29 juin 2026, le fondateur de Zhipu, Tang Jie, a demandé à la communauté ce qui manquait au prochain GLM. Plus de 1 400 réponses sont arrivées, et la demande la plus fréquente était la vision. Les développeurs voulaient que le modèle lise seul les captures d’écran, les PDF, les maquettes d’interface et les messages d’erreur. Le contournement en usage ressemblait à ceci : Qwen-VL analyse l’image et transmet le texte à GLM-5.2. Un maillon de plus, une latence de plus – et deux requêtes à payer au lieu d’une.
Li Xuan, dirigeant de Z.ai, a reconnu publiquement que le mot « vision » avait envahi les commentaires. Aucun engagement n’a suivi.
Un mois et demi plus tard, GLM-5.3 est sorti – sans vision. La vision est arrivée douze jours après, dans un autre modèle.
Le cas est instructif justement parce qu’il est typique du secteur. Un éditeur peut recueillir autant de retours qu’il veut ; rien ne l’oblige à y donner suite. Planifiez sur ce qui est déjà sorti et accessible via l’API.
GLM-5.3-Flash (26 août 2026)
Voilà la grande nouvelle de l’été chez Z.ai, et elle non plus ne figure pas encore dans notre benchmark. Six jours avant l’annonce, ce même modèle tournait gratuitement sur OpenRouter sous le nom stealth/ox-alpha, sans auteur indiqué – nous revenons sur cet épisode plus bas, dans la partie consacrée à Pony Alpha.
GLM-5.3-Flash est le premier modèle nativement multimodal de la famille GLM-5. En entrée, il accepte texte, images, vidéo et fichiers. Plus besoin d’un second modèle pour analyser une image.
Côté architecture, c’est un MoE de 320 milliards de paramètres, dont 18 milliards actifs par token : chaque token est routé vers 8 experts sur 288. L’attention est hybride – des couches linéaires KDA alternent avec des couches MLA clairsemées, sans encodage positionnel. Le mécanisme IndexPool réduit le cache KV d’un facteur 4,4 par rapport à GLM-5.3, et mHC divise environ par deux le nombre de paramètres activés par rapport à GLM-4.5. Contexte d’un million de tokens.
Ces détails comptent pour une seule raison : ce sont eux qui permettent un prix dix fois inférieur à celui du flagship pour une qualité comparable. L’économie vient de l’ingénierie du service des requêtes, tandis que la profondeur et la qualité du raisonnement n’en ont presque pas souffert.
Tarifs : 0,15 $ par million de tokens en entrée, 0,03 $ pour le cache et 0,50 $ par million en sortie. Jusqu’au 9 septembre 2026, une remise de 50 % s’applique : 0,075 $ en entrée et 0,25 $ en sortie. Dans les abonnements GLM Coding Plan, Flash est inclus avec un quota triple de celui de GLM-5.3.
Sur les tests de Z.ai elle-même : Terminal-Bench 2.1 – 84,3 points contre 85,0 pour Claude Opus 4.8. DeepSWE v1.1 – 63,4 contre 46,2 pour GLM-5.2. AutomationBench – 48,8 contre 26,2. Ce sont des chiffres d’éditeur, à revérifier sur vos propres tâches, mais l’écart est trop grand pour être mis sur le compte du marketing.
Les poids de GLM-5.3-Flash sont sur Hugging Face sous MIT – sans seuil de chiffre d’affaires ni restriction d’usage. C’est la licence la plus libre de tous les modèles de cette revue. À titre de comparaison : Qwen3.8-Max est ouvert, mais au-delà de 50 millions de dollars de chiffre d’affaires il exige un contrat spécifique avec Alibaba ; pour Kimi K3, le seuil est de 20 millions. En 2026, « poids ouverts » couvre tout un éventail, de la licence MIT au contrat négocié par vos juristes, et un manager doit savoir à quel bout il se trouve.
Le faire tourner chez soi demande environ 306 Gio de poids en FP8 et des GPU de classe NVIDIA Hopper ou plus récents. Un projet à la portée d’une organisation moyenne ou grande disposant de son propre cluster – pas une affaire de week-end. Avant sa sortie, le modèle a aussi été rodé sur des puces chinoises de fabrication nationale.
Ce que montrent les plateformes indépendantes
Artificial Analysis teste tous les modèles dans les mêmes conditions, ce qui rend ses données plus utiles que les tableaux de lancement. GLM-5.3 au niveau de raisonnement maximal obtient 49 points à l’Intelligence Index. Prix mixte : 1,26 $ par million de tokens ; vitesse : 87 tokens de sortie par seconde. GLM-5.3-Flash : 46 points pour 0,18 $.
Trois points d’intelligence mesurée pour un prix sept fois plus élevé.
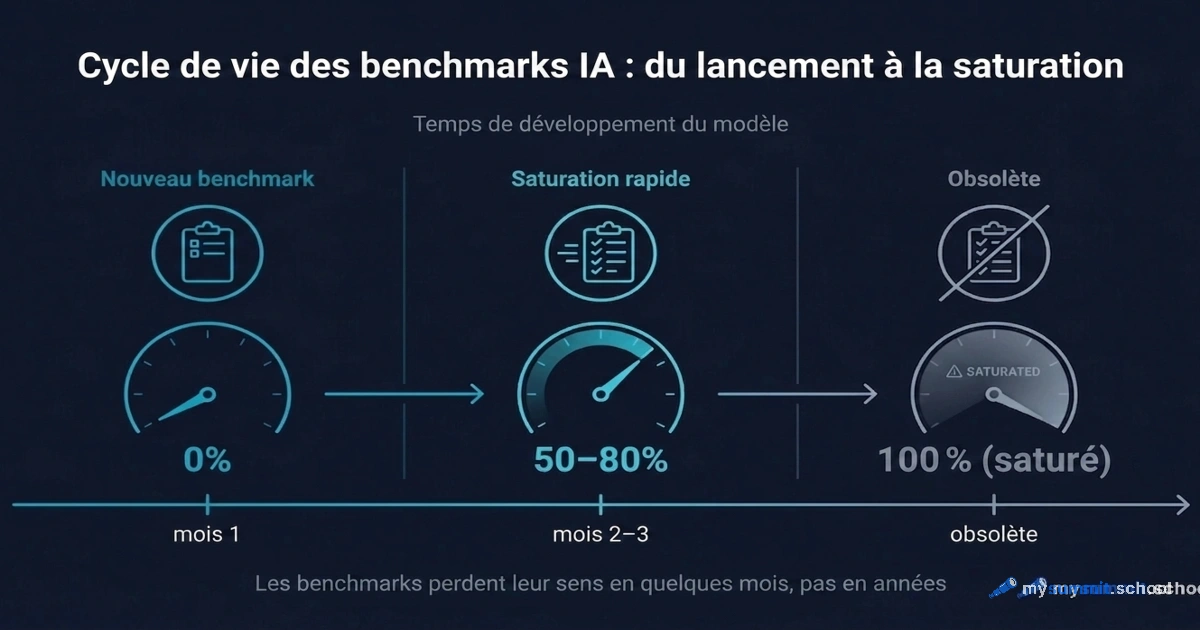
Encore faut-il vérifier l’échelle. Artificial Analysis publie son indice par versions et le recalibre de l’une à l’autre : les 60 points du communiqué d’août de Z.ai (indice en version 4.1.1) et les 49 points du classement actuel ne sont pas mesurés avec la même règle. On ne peut comparer qu’à l’intérieur d’un même instantané – un principe qui vaut d’ailleurs pour la lecture de n’importe quel classement : les classements d’IA réévaluent régulièrement les modèles.
Aucun modèle GLM ne figure actuellement dans le top 10 de LMArena. Ce classement a sa propre particularité : les intervalles de confiance des neuf premières places du classement texte se chevauchent, ce qui revient statistiquement à une égalité. La première place y relève de la marge d’erreur.
Le schéma « le modèle bon marché bat le modèle cher » n’est plus propre à Z.ai. Toujours chez Artificial Analysis, Gemini 3.8 Flash coûte 0,74 $ par million de tokens mixtes, débite 334 tokens par seconde et devance des modèles plus chers de la gamme Google elle-même. Le réflexe « le flagship est toujours meilleur » se vérifie de moins en moins en 2026 – chez Google comme chez Z.ai, le modèle du haut de gamme coûte désormais plusieurs fois plus cher que ce qu’il apporte.
L’affaire Pony Alpha : une enquête qui s’est répétée
« Pony » fait référence à l’année du Cheval dans le calendrier chinois. Le 11 février, Zhipu a confirmé officiellement que Pony Alpha était GLM-5. L’action a pris 60 % en trois jours.

L’entreprise n’a jamais expliqué officiellement ce qui s’était passé. Zhipu n’a pas commenté la confusion d’identité.
Ce n’est pas un cas isolé. En décembre 2025, des chercheurs du MIT ont constaté que les modèles de la série GLM se présentaient comme Claude dans environ 50 % des cas avec des méthodes d’interrogation non standard. DeepSeek V3 présentait une particularité similaire – avec certains prompts, il se disait ChatGPT ou GPT-4. OpenAI a riposté en accusant ouvertement DeepSeek de distillation à partir de ses modèles et a mis à jour ses conditions d’utilisation. Anthropic, Mistral et xAI ont ajouté des clauses anti-distillation comparables aux leurs.
La distillation – entraîner un modèle plus petit sur les sorties d’un modèle plus grand – est, selon toute vraisemblance, un secret de polichinelle du secteur. Impossible de confirmer son usage pour GLM-5 : nous n’avons pas d’audit technique. Impossible de l’écarter non plus : les schémas de comportement sont trop spécifiques.
Six mois plus tard, Z.ai a refait le coup. Le 20 août 2026, stealth/ox-alpha apparaît sur OpenRouter : gratuit, avec un contexte d’un million de tokens, acceptant texte, images et vidéo en entrée. Aucun auteur indiqué.
La communauté s’est mise à identifier l’auteur à partir de l’infrastructure. Stack traces, codes d’erreur et empreintes du tokenizer ont donné 30 correspondances sur 30 avec GLM-5.3 – du moins c’est ce qui ressortait des rapports de la communauté. Cela n’a pas suffi à faire l’unanimité. TechCrunch a décrit une communauté en désaccord avec ses propres conclusions : l’analyste IA Andrew Curran notait que les premières pistes menaient à Z.ai, mais que « au matin, les gens ne semblent plus sûrs de rien ». Un média a basculé vers l’hypothèse d’une version non publiée de Microsoft MAI. Reddit s’est partagé entre « ça ne peut pas être un modèle chinois » et « forte probabilité qu’il soit chinois ».
Le matin du 26 août, Bloomberg rapportait que Zhipu avait confirmé l’appartenance du modèle à la famille GLM. À 19 h 42 le même jour, Z.ai annonçait tout elle-même : « Introducing GLM-5.3-Flash – Previously previewed as Ox Alpha, running entirely on Chinese AI chips ». La publication a dépassé 740 000 vues en une heure, et dans le même temps les poids sous MIT arrivaient sur Hugging Face – explainX retrace la chronologie du lancement.
Pendant sa semaine gratuite, Ox Alpha a pris la tête du classement des applications d’OpenRouter, et le trafic était agentique : Claude Code y a fait passer environ 9,3 milliards de tokens, Hermes Agent près de 9,0 milliards. La plateforme a mesuré environ 50 tokens par seconde pour une latence médiane de 2,02 s. Un chiffre mérite qu’on s’y arrête : les erreurs d’appel d’outils, autour de 4,45 % – dans une chaîne agentique, elles se multiplient à chaque étape. Le benchmark indépendant du développeur explainX lui a attribué 80 % sur DeepSWE. Aujourd’hui, stealth/ox-alpha ne répond plus et la fiche a été supprimée : le modèle est distribué sous le nom z-ai/glm-5.3-flash, présenté plus haut.
Pour un manager, une ligne de cette fiche compte plus que tout le reste. OpenRouter indiquait que le fournisseur conservait prompts et réponses et ne les utilisait pas pour l’entraînement – The Next Web résume la fiche. Pendant une semaine, des développeurs ont branché des agents de code en production, Claude Code compris, sur un fournisseur que personne ne savait nommer, et y ont fait passer des milliards de tokens de travail réel. Des données conservées par un éditeur avec qui vous avez signé un contrat et des données conservées par une partie que vous ne pouvez même pas nommer, ce sont deux risques différents, quoi qu’en dise la ligne sur la confidentialité.
Pony Alpha s’était trahi par ses mots : interrogé directement, il répondait « Je suis GLM », et prié de créer une page sur lui-même, il écrivait « I am Claude, created by Anthropic ». Ox Alpha n’a rien dit de lui-même, et il a fallu reconstituer son auteur à partir des empreintes du tokenizer, des codes d’erreur et des stack traces ; même après cela, la communauté a débattu plusieurs jours en avançant le nom de Microsoft. Le même procédé de lancement, à six mois d’écart, a produit deux types d’énigme : le premier modèle a vendu la mèche, le second a dû être pisté par son infrastructure.
De quoi faire réfléchir : si le modèle « se faisait passer » pour Claude avec des méthodes d’interrogation détournées, qu’a-t-il au juste absorbé pendant son entraînement ? Et à quel point cela importe-t-il à un manager qui a besoin d’un outil qui fonctionne ? Depuis août, la question a une seconde moitié : avec le modèle, une équipe choisit aussi qui conservera ses prompts. Dans le cas d’Ox Alpha, pendant une semaine, personne ne savait qui c’était.
Ce que montrent les tests
Sur les tests standard du secteur, GLM-5 rivalise avec les meilleurs modèles fermés – pas anodin pour un modèle ouvert et gratuit. Les chiffres ci-dessous sont ceux de l’éditeur ; voici ce qui compte pour un manager :

- Programmation – résout 77,8 % de tâches réelles issues de GitHub. À titre de comparaison : Claude Opus 4.5 – 80,9 %, GPT-5.2 – 75,4 %. L’écart avec les leaders est minime.
- Simulation d’entreprise (Vending Bench 2, un test où le modèle « gère une entreprise » pendant un an) – GLM-5 termine avec un solde de 4 432 $ contre 4 967 $ pour Claude Opus 4.5. Il prend des décisions stratégiques à peu près au niveau des meilleurs concurrents occidentaux.
- Recherche web – première place parmi tous les modèles testés, GPT-5.2 et Claude compris.
- Hallucinations – le meilleur résultat du secteur. GLM-5 dit plus volontiers « je ne sais pas » qu’il n’invente une réponse. Pour travailler avec des faits et des chiffres, c’est capital.

Comme toujours, benchmarks et travail réel sont deux choses différentes. Mais la tendance est claire : GLM-5 joue dans la même catégorie que ChatGPT et Claude.
Les benchmarks sont convaincants – mais entre « le modèle répond bien aux tests » et « le modèle règle fiablement mon problème », il y a toute une couche de savoir-faire : comment formuler la demande, comment vérifier la réponse, comment ne pas se laisser piéger par une hallucination assurée. C’est cette couche qui décide si vous tirez une vraie valeur de GLM-5 ou seulement de belles réponses.
GLM-5 réduit les hallucinations – mais sans approche systématique, vous en laisserez passer. 9 tâches pratiques de manager dans le module ouvert vous montrent où – gratuit, sans inscription.
Sans paiement requis • Notification au lancement
Résultats de notre benchmark
Dans notre benchmark, nous testons les modèles sur des tâches managériales réelles réparties en 8 catégories – de la planification et l’analyse à la communication et au travail d’équipe.
GLM-5 se place dans le haut du peloton intermédiaire – un concurrent solide qui devance la plupart des modèles occidentaux de milieu de gamme, mais reste derrière des leaders comme Kimi K2.5 et MiniMax M2.7.
Le profil sur huit catégories se lit sans ambiguïté. GLM-5 est le plus fort en planification, en analyse et en gestion d’équipe, où il talonne les leaders. Il décroche là où le contexte local compte : formation et développement, connaissance régionale (les pratiques d’affaires des marchés post-soviétiques sont mieux maîtrisées par les modèles régionaux conçus pour eux, YandexGPT et GigaChat). Recherche d’information et communication : pile au milieu.
En pratique : GLM-5 est un outil solide pour la planification et l’analyse. Si vous découpez un projet, évaluez des risques ou analysez des données, il fera bonne figure. Si vous avez besoin d’une connaissance fine d’un contexte d’affaires régional précis ou de bâtir un programme de formation, les résultats seront plus faibles. Côté accès, peu de friction : le chat web est gratuit et ouvert à quiconque possède un compte Google.
Et GLM-5.2 ? Dans notre benchmark, la nouvelle version fait jeu égal avec la première sur les tâches business, mais coûte nettement moins – et reste l’un des modèles les plus abordables de sa gamme de qualité (rang, score et prix à jour figurent dans la fiche sous le titre consacré à GLM-5.2, plus haut). Pour un modèle ouvert d’environ 750 milliards de paramètres, c’est un résultat notable – les modèles ouverts de cette taille restaient rares.
Mais un paradoxe apparaît. Sur les tests de code purs, GLM-5.2 est parmi les leaders, alors que sur les tâches business liées au code, à l’analyse et au marketing (qui demandent un bon anglais), il fléchit. Le point le plus faible, ce sont les tâches « de réflexion » : le modèle laisse systématiquement passer des détails du texte ou en tire des conclusions qu’il ne contient pas. Il respecte en revanche proprement le format, donc s’intègre à d’autres systèmes sans surprise – mais surveillez ses conclusions. La force de GLM-5.2, c’est le raisonnement d’ingénieur : code, plans techniques, décomposition. Le raisonnement « sur papier », où il faut saisir une nuance dans un texte ordinaire, lui réussit moins.
Nous n’avons pas encore passé GLM-5.3 et GLM-5.3-Flash sur nos tâches managériales : ce qui précède sur les benchmarks de code ne se transpose donc pas automatiquement aux scénarios business. Dès que nous les aurons testés, ces sections recevront des fiches avec les résultats à jour.
Les résultats détaillés pour toutes les catégories sont sur la page du benchmark.

Vous hésitez entre GLM-5.3-Flash, DeepSeek et Claude ? Le module ouvert propose 9 tâches pratiques de manager, gratuitement et sans inscription. Voyez avec quelle assurance vous confiez des tâches à l'IA.
Sans paiement requis • Notification au lancement
Comment utiliser Chat Z.AI (GLM-5) dès maintenant
L’interface web officielle, c’est chat.z.ai. Connexion avec un compte Google. L’interface existe en anglais et en chinois, pas en français, mais le modèle comprend le français et y répond.
Deux modes de fonctionnement :
- Chat Mode – le format de dialogue habituel. Convient à la plupart des tâches : rédaction, analyse de documents, réponses aux questions.
- Agent Mode – c’est là que GLM-5 donne toute sa mesure. Le modèle peut utiliser des outils : générer des fichiers .docx, .pdf, .xlsx, faire des recherches web, exécuter des tâches en plusieurs étapes. Si vous voulez un rapport avec des tableaux, c’est ce mode qu’il vous faut.
Un conseil pratique sur la langue : la qualité des réponses est nettement meilleure en anglais qu’en français. Si la tâche le permet, formulez vos prompts en anglais, surtout pour les demandes analytiques complexes. C’est la même situation qu’avec Qwen : les modèles chinois fonctionnent mieux dans les langues sur lesquelles ils ont été le plus entraînés.
La semaine qui a suivi le lancement de GLM-5 a été agitée : le trafic a été multiplié par dix, le service a été instable pendant plusieurs jours et Zhipu a présenté des excuses publiques. Mi-mars, la situation s’était normalisée, mais gardez en tête qu’il s’agit d’un service jeune, sous une charge en forte croissance.
Exemple 2. Un pre-mortem avant le lancement d’un produit
La seconde tâche est analytique. C’est traditionnellement le terrain de Claude, et pour GLM-5 c’est un test honnête : un modèle chinois bon marché peut-il livrer une analyse structurée au niveau d’un flagship ? Pour GigaChat, c’est l’occasion de montrer comment il se débrouille sur un marché qui n’est pas le sien.
Regardez non seulement le fond mais aussi la structure de chaque réponse : la capacité à tenir toutes les exigences du prompt à la fois (6 à 8 causes, catégories, signaux, actions) est précisément ce qui sépare un outil de travail d’une belle démo.
Limites et risques
La censure chinoise fonctionne de façon prévisible : sujets politiquement sensibles, critique historique de l’État, certains événements – tout est bloqué. Dans le travail d’un manager, cela pose rarement problème, mais mieux vaut le savoir.
La qualité hors de l’anglais et du chinois est l’une des faiblesses majeures. Sur des tâches en russe, dans nos tests, GLM-5 perdait nettement en précision et en nuance, là où DeepSeek tenait bien mieux. Si votre équipe travaille en français, testez-le d’abord sur vos propres documents.

En mode d’analyse approfondie, les réponses sont environ 30 à 40 % plus lentes qu’avec Claude et GPT. Pas critique pour des tâches ponctuelles, mais sensible en usage intensif. GLM-5.3 change la donne : Artificial Analysis mesure 87 tokens de sortie par seconde – plus que Claude Opus 5 et GPT-6 Astra dans les mêmes conditions.
La question de la distillation reste ouverte. Elle n’affecte pas la fiabilité technique du modèle – il fonctionne. Mais les organisations qui utilisent Claude et se soucient de l’éthique de l’IA devraient en tenir compte.
L’hébergement sur vos propres serveurs est techniquement possible (le code est ouvert), mais demande un matériel serveur conséquent. Contrairement aux modèles compacts de Qwen, GLM-5 n’est pas à la portée d’une DSI seule. Pour GLM-5.3-Flash, l’exigence est connue précisément : environ 306 Gio de poids en FP8 et du NVIDIA Hopper ou plus récent.
Pas d’application mobile – uniquement le web.
Tarifs
| Option | Coût | Pour qui |
|---|---|---|
| chat.z.ai | Gratuit (avec limites) | Essayer sans engagement |
| GLM Coding Plan | à partir de ~18 $/mois | Développeurs ; GLM-5.3-Flash inclus avec un quota triple |
| API GLM-5.3-Flash | 0,15 $ entrée / 0,50 $ sortie, cache 0,03 $ par million de tokens | Tâches multimodales et gros volumes |
| API GLM-5.3 | 1,40 $ entrée / 4,40 $ sortie par million de tokens | Textes longs et raisonnement maximal |
| API GLM-5 via OpenRouter | coût par tâche dans la fiche du modèle et sur le graphique prix/qualité ci-dessous | Intégration aux processus métier |
Jusqu’au 9 septembre 2026, GLM-5.3-Flash bénéficie d’une remise de 50 % : 0,075 $ en entrée et 0,25 $ en sortie. Si vous prévoyiez un pilote sur une tâche multimodale, il reste moins d’une semaine.
Le rapport qualité-prix se lit le mieux sur un seul graphique – tous les modèles de notre benchmark, avec GLM-5 et GLM-5.2 en surbrillance.
Analyser le même rapport de 100 pages avec Claude Opus 4.5 ou GPT-5.2 coûte plusieurs fois plus cher qu’avec GLM-5 – pour des capacités comparables sur de nombreuses tâches.
Cela dit, parmi les modèles ouverts chinois, GLM-5 est le plus cher : DeepSeek et Qwen coûtent nettement moins. Que paie-t-on en plus ? De solides résultats en planification et en analyse – si ce sont vos priorités, l’écart se justifie.
Après le lancement de GLM-5, Zhipu a augmenté le prix du forfait Pro d’environ 30 %, ce qui a suscité le mécontentement des utilisateurs.
Faut-il l’essayer ?
Si vous choisissez dans la gamme Z.ai en septembre 2026, le point de départ logique est GLM-5.3-Flash. Il est multimodal, coûte environ dix fois moins que GLM-5.3, est distribué sous MIT et tient la distance face aux flagships sur les tests de code. GLM-5.3 se justifie pour les textes longs et le raisonnement maximal, quand quelques points d’écart pèsent vraiment sur le résultat et que le budget le permet. GLM-5 et GLM-5.2 restent utilisables, mais il y a peu de raisons de commencer par eux aujourd’hui.
GLM-5 est un modèle aux forces réelles et aux faiblesses tout aussi réelles. L’histoire qui l’entoure n’a toujours pas de réponse définitive.
Ses bons résultats en planification et en analyse sont réels et reproductibles. Si vous découpez un projet, évaluez des décisions stratégiques ou analysez des données, GLM-5 mérite d’être essayé.
S’il vous faut un modèle pour un contexte d’affaires régional précis, la formation de votre équipe ou des tâches à forte spécificité locale, GLM-5 est en retrait sur la concurrence. Pour cela, DeepSeek ou Claude feront mieux.
L’affaire Pony Alpha et l’identification à Claude sont une raison de garder une distance analytique. Elles n’empêchent pas d’utiliser l’outil. Le secteur évolue depuis longtemps dans une zone grise où la frontière entre « inspiration » et « distillation » est floue à dessein. GLM-5 fait partie de ce tableau d’ensemble, et il vaut la peine de le garder en tête.
L’accès, lui, ne fait pas débat : chat.z.ai se connecte avec Google et propose une offre gratuite. Une heure de test suffit pour vous faire votre propre opinion.
La paire de sorties d’août semble avoir distribué les rôles au sein même de Z.ai : le flagship fixe le plafond dans les tableaux, tandis que l’entreprise gagne de l’argent avec le modèle bon marché et les abonnements Coding Plan. La question à garder en tête : combien de temps ce modèle tient-il, si le post-entraînement à lui seul multiplie les résultats par six sur une base ancienne ?
Vous avez l'outil. Place à la compétence
Un programme complet : des bases du prompt engineering aux spécialisations en gestion de projet et en management d'équipe. Choisissez n'importe quel modèle – GLM-5.3-Flash, Claude, DeepSeek – et testez votre approche sur des scénarios managériaux réels.
Stanislav Belyaev
Engineering Leader chez Microsoft18 ans a diriger des equipes d'ingenieurs. Fondateur de mysummit.school. 700+ diplomes chez Yandex Practicum et Stratoplan.