Meta Muse Spark : le premier modèle fermé de Meta depuis 2023
Jusqu’ici, cette série ne comptait aucun volet consacré à Meta. Tant que Llama 4 faisait l’actualité, ce silence se justifiait : le modèle était sorti dans la controverse, et il n’y avait rien à en dire à un manager en tant qu’outil de travail.
Le 9 juillet 2026, Meta a publié Muse Spark 1.1 et ouvert le même jour l’accès public à la Meta Model API. L’annonce est parue sur le blog de l’entreprise. La famille Muse, qui remplace Llama, avait démarré trois mois plus tôt : la version 1.0 est sortie le 8 avril, et le modèle actuel est construit sur sa base. Dans l’instantané de septembre de LMArena, muse-spark-1.2 en mode xHigh occupe la cinquième place du classement texte, muse-spark-1.1 la dixième, et muse-spark est sixième du classement images. Quiconque compare les outils à coups de classements tombera sur ce nom. La série n’avait encore rien à en dire.
Les scores ne sont ici que la troisième information par ordre d’importance. La première, c’est la licence : en neuf mois, Meta a changé la direction de son pôle IA, reconstruit sa pile technique et est revenue avec des poids fermés. La deuxième, c’est la nature du modèle obtenu : la 1.1 est en tête sur l’appel d’outils et nettement à la traîne sur l’écriture de code.
Ce qui est arrivé à Llama
Llama 4 est sorti sous des critiques mitigées, et le lancement a tourné au scandale : Meta a reconnu avoir préparé une configuration distincte du modèle pour l’un des benchmarks. Cet aveu lui a coûté la confiance précisément du public qui lit les tableaux de scores avec le plus d’attention.
À l’été 2025, Zuckerberg a réorganisé tout ce qui touchait à l’IA. Le poste de Chief AI Officer, responsable de l’ensemble du pôle IA, est revenu à Alexandr Wang, 29 ans, cofondateur de Scale AI, autour duquel a été bâti Meta Superintelligence Labs. Wang résume ainsi le travail accompli : « Il y a neuf mois, nous avons reconstruit notre pile IA de zéro. Nouvelle infrastructure, nouvelle architecture, nouveaux pipelines de données… C’est un premier pas. »
Le marché a vu ce premier pas le 8 avril 2026, avec la sortie de Muse Spark 1.0 : la première famille de modèles à remplacer Llama et la première décision de la nouvelle direction visible de l’extérieur. Le deuxième pas, c’est la 1.1 de juillet, avec l’API ouverte le même jour.
Des poids fermés
Le modèle n’est distribué que par API, les poids n’ont pas été publiés. Depuis juillet 2023 et la sortie de Llama 2, Meta n’avait pas lancé de modèle fermé de premier plan. Pendant trois ans, l’entreprise a expliqué au marché que les poids ouverts étaient la bonne stratégie et a fondé là-dessus son argumentaire face à Anthropic et OpenAI.
Pour la 1.1, cela signifie exactement la même chose que pour la 1.0. Impossible de déployer le modèle en local, impossible de l’affiner sur vos propres données, et tout ce que vous lui transmettez part sur les serveurs de Meta.
En interne, les produits Meta sont déjà passés au nouveau modèle : Muse Spark a remplacé Llama 4 dans les lunettes connectées. Le détail est parlant. Des lunettes, c’est un appareil où la latence et la consommation de tokens se voient directement côté utilisateur, et on n’y installe pas un modèle dont on doute.
La frontière entre ouvert et fermé a sauté
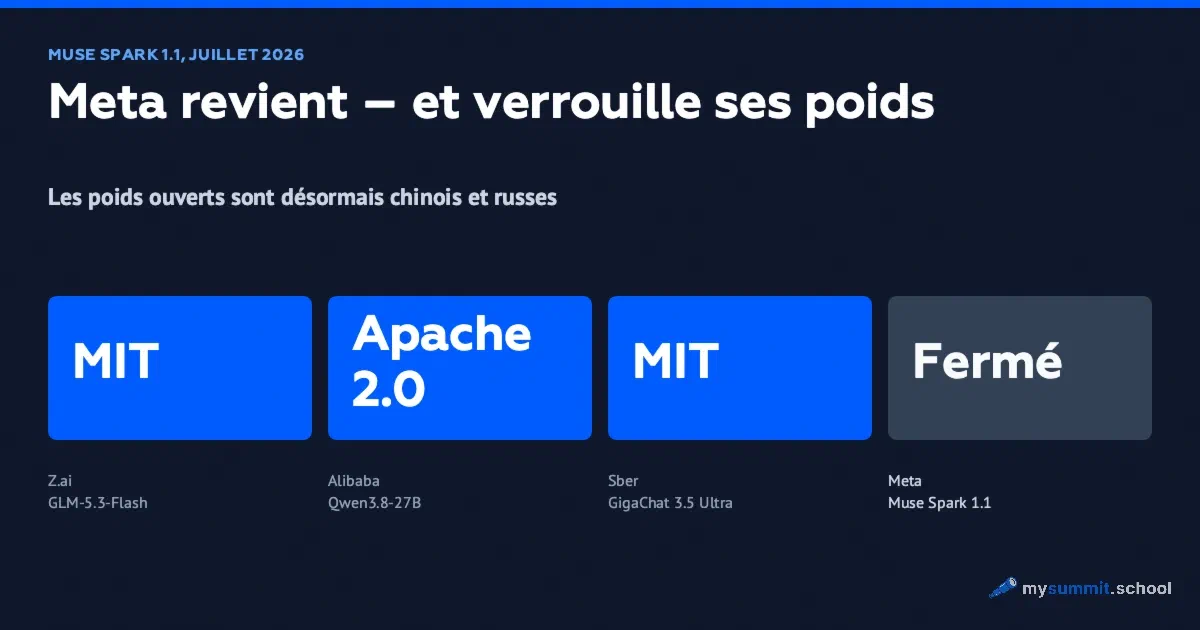
Toute l’année, cette série s’est appuyée sur une distinction simple : les laboratoires américains vendent des modèles fermés, les chinois distribuent leurs poids. En 2026, elle a cessé de fonctionner, et des deux côtés à la fois.
Meta a fermé ses poids. Z.ai a publié la même saison GLM-5.3-Flash sous licence MIT, sans seuil de chiffre d’affaires ni restriction d’usage. Alibaba a mis en ligne Qwen3.8-27B sous Apache 2.0 : le modèle comprend les images et tourne sur une seule carte graphique grand public.
Sber, première banque russe et éditeur des modèles GigaChat, a sorti GigaChat 3.5 Ultra : 432 milliards de paramètres, lui aussi sous MIT.
Les poids ouverts viennent désormais de laboratoires chinois et russes. Meta, elle, demande qu’on fasse confiance à son API.
Le modèle de l’intérieur
Meta positionne la 1.1 face à GPT-5.5, Claude Opus 4.8 et Gemini 3.1 Pro. Le modèle dispose d’un contexte de 1 million de tokens et le gère activement : il compresse et élague lui-même une partie de l’historique pour qu’une longue conversation ne bute pas sur la limite.
En entrée, il accepte images, vidéo, PDF et audio. C’est plus large que GPT-6 Astra et Grok 4.6, qui ne traitent que les images.
La particularité de conception de la 1.1, c’est son rôle d’agent orchestrateur. Le modèle reçoit la demande, rassemble le contexte nécessaire, établit un plan et répartit l’exécution entre des sous-agents en parallèle, puis assemble la réponse à partir de leurs résultats. Dans l’application Meta AI et sur meta.ai, cela prend la forme du mode Thinking : sur les tâches qu’il juge difficiles, le modèle réfléchit plus longtemps.
L’intérêt pratique se voit le mieux sur une tâche qu’un manager confie réellement : « voici trois propositions commerciales et notre modèle de contrat, trouve les écarts sur les délais, les pénalités et les conditions de recette ». Un agent unique traite tout le lot d’un coup et commence à mélanger les clauses dès le troisième document. Un orchestrateur découpe la demande, confie chaque morceau à son sous-agent et reconstitue la réponse à partir des pièces.
Cette conception vient de la première version. Muse Spark 1.0 a été conçu d’emblée comme multimodal : une seule architecture traite texte et images, sans encodeur d’images greffé sur un modèle de texte. Il proposait trois modes de raisonnement. Instant répondait immédiatement aux demandes simples, Thinking s’activait sur les tâches difficiles, et Contemplating décomposait une demande et lançait des sous-agents en parallèle, d’où l’orchestrateur de la 1.1. Pendant l’apprentissage par renforcement, Meta a appliqué une « compression des pensées » : le modèle résout les problèmes complexes avec moins de tokens de raisonnement. Selon Meta, la 1.0 atteignait le niveau de raisonnement visé avec un ordre de grandeur de calcul en moins que Llama 4 Maverick. Les deux chiffres, sur le calcul et sur la compression, viennent de l’éditeur ; nous n’en avons aucune vérification indépendante.
Combien de tokens coûte une tâche
Sur sa batterie de tâches (Intelligence Index v4.0), Artificial Analysis a compté 58 millions de tokens pour Muse Spark 1.0. Le modèle d’Anthropic en a consommé 157 millions sur la même batterie, GPT-5.4 d’OpenAI 120 millions. Soit environ un tiers de la consommation pour un travail comparable. Ces tokens finissent sur la facture, et ce sont eux qui disparaissent le plus souvent des tableaux comparatifs.
Deux réserves. Les tâches d’Artificial Analysis sont standardisées ; sur vos longs documents et dans un dialogue avec allers-retours, la consommation serait différente. Et le chiffre concerne la 1.0 : Meta n’a pas publié la consommation de la 1.1, et un orchestrateur avec des sous-agents en parallèle fait plus de travail qu’un seul passage sur la demande, donc consomme davantage.
Ce que montrent les classements indépendants
Muse Spark ne figure pas encore dans notre benchmark : voici les données de Meta et de plateformes indépendantes ; la page /research/benchmark/ ne contient pas ce modèle.
Sur LMArena, où des humains comparent les réponses à l’aveugle, muse-spark-1.2 (xHigh) tient 1499 ± 10 et la cinquième place du classement texte, muse-spark-1.1 la dixième avec 1492 ± 5. La première place revient à Claude Fable 5. Au classement images, muse-spark est sixième avec 1294 ± 9, muse-spark-1.2 xHigh huitième avec 1292 ± 15. La troisième place y revient à qwen3.8-max.
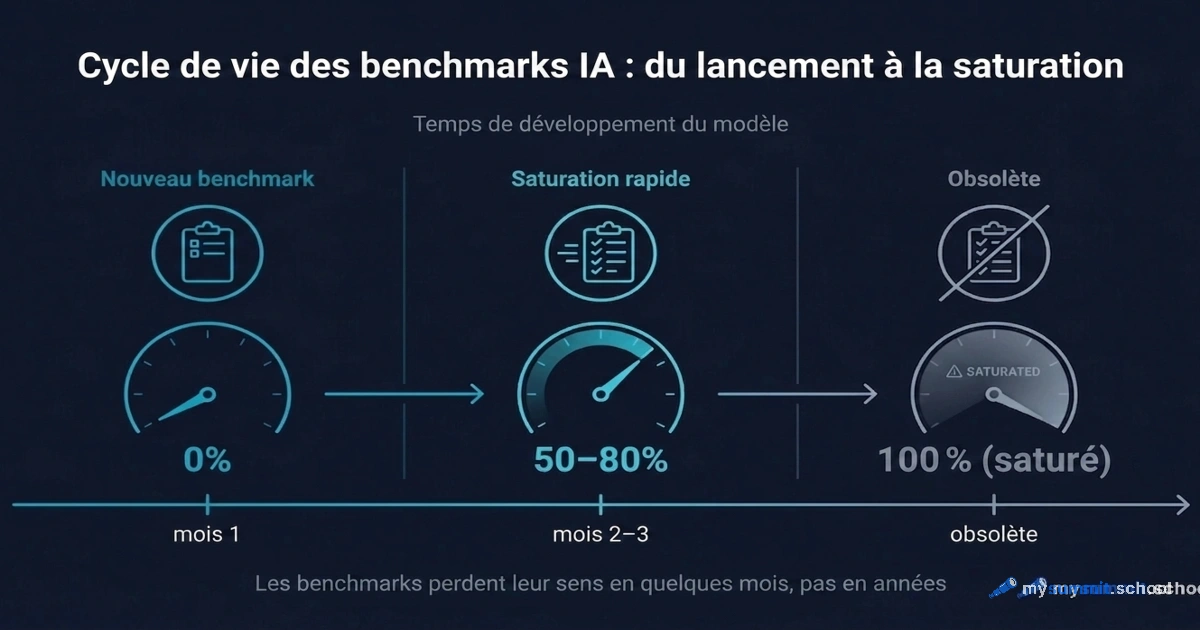
Dans les deux classements, l’écart entre lignes voisines est inférieur à la largeur de l’intervalle de confiance de chacune. Les places un à neuf sont une égalité statistique, et tout texte qui désigne le meilleur modèle à partir de ces tableaux y voit plus qu’ils ne contiennent. Nous l’avons analysé dans l’article « Les benchmarks d’IA perdent leur sens », et Muse Spark en est une nouvelle illustration : le modèle entre dans le top dix des deux classements tout en restant dans le peloton indiscernable.
Dans l’Intelligence Index v4.0, Artificial Analysis attribue à Muse Spark 1.0 un score global de 52. Sur le papier, c’est plus que les 51 de Grok 4.6, mais ces deux chiffres ne se comparent pas : la plateforme publie l’indice par versions et change d’échelle entre elles. Le « 60 » de l’annonce d’avril et le « 49 » du tableau en direct de septembre ne sont pas sur la même échelle. Au sein d’un même instantané, le tableau varie selon le type de tâche : sur CharXiv Reasoning, où le modèle raisonne sur des graphiques scientifiques, la 1.0 obtient 86,4, et sur HealthBench Hard 42,8, nettement au-dessus de la concurrence.
Les points faibles de la 1.0, Meta les a publiés elle-même. ARC-AGI-2, test de raisonnement abstrait : 42,5, quand la concurrence dépasse 76. Programmation : 77,4, alors que selon Meta, Claude et Gemini dépassent 80 sur cette même batterie.
Où il mène, où il décroche
Trois benchmarks de l’annonce de juillet décrivent la 1.1 plus précisément que son rang au classement général. MCP Atlas, test d’appel d’outils à grande échelle : 88,1, première place. JobBench, tâches professionnelles avec outils : 54,7, première place également. DeepSWE 1.1, programmation sur un horizon long : 53,3 contre 67,0 pour GPT-5.5.
Les trois chiffres ont été publiés par Meta, sans vérification indépendante. Ils dessinent pourtant un tableau cohérent, qui recoupe le profil de la 1.0 : solide sur les documents et les graphiques, faible en programmation.
Muse Spark est un modèle d’orchestration d’outils. Rassembler du contexte depuis plusieurs systèmes, établir un plan, distribuer l’exécution aux sous-agents et consolider les résultats : là, il devance tout ce qui a été mesuré. Écrire et réécrire du code sur la durée : là, le retard sur GPT-5.5 dépasse treize points, et aucun réglage du prompt ne comble un tel écart.
Où placer un tel modèle
Ces données débouchent sur une recommandation concrète. Si la tâche ressemble à « rassemble les données de trois systèmes, compare-les à notre modèle et montre-moi les écarts », le modèle mérite d’être envisagé. « Écris une migration », c’est plutôt pour Claude ou Gemini.
La façon dont tout cela s’articule avec les autres modèles est détaillée dans la synthèse du panorama des outils GenAI 2026.
La recommandation tient en une ligne : orchestration d’outils, oui ; code, non. En pratique, tout se joue dans la formulation. L’orchestrateur découpera la demande, mais c’est vous qui décidez de quels morceaux il a besoin. Entre « la réponse a l’air juste » et « la réponse peut aller dans le rapport », il y a une compétence : savoir formuler une tâche pour l’IA.
Neuf tâches courantes d'un manager, de la lecture critique du rapport d'un autre au mail à un prestataire, résolues avec l'IA dans un module gratuit. Sans inscription.
Sans paiement requis • Notification au lancement
Accès et prix
L’accès grand public est gratuit : application Meta AI et site meta.ai. Côté développeurs, l’accès passe par la Meta Model API, ouverte en préversion publique le 9 juillet 2026, le jour même de la sortie de la 1.1, et réservée aux développeurs basés aux États-Unis. L’API est compatible OpenAI : un code écrit pour ChatGPT se transpose en changeant l’adresse et la clé. Les tarifs sont annoncés : 1,25 $ par million de tokens en entrée et 4,25 $ par million en sortie, avec 20 $ de crédit offert au départ. Meta cite Replit, Cline, Box et l’OpenClaw Foundation comme premiers partenaires.
Pour une entreprise hors des États-Unis, ce n’est pas la grille tarifaire qui tranche. L’accès à l’API suppose aujourd’hui un compte développeur américain, et le produit grand public n’est disponible que là où Meta AI est proposé ; il n’existe pas de voie à part pour Muse Spark.
Concrètement, les données de travail envoyées au modèle partent sur les serveurs américains de Meta, dans le cadre d’une préversion conçue pour les développeurs américains. La plupart des politiques de données d’entreprise auront leur mot à dire, aussi bon que soit le modèle. Mieux vaut poser directement la question à vos juristes et à votre DPO avant d’y faire entrer quoi que ce soit de sensible.
La promesse des poids ouverts
Wang affirme que les poids ouverts de l’une des versions de Muse Spark 1.2 arriveront « bientôt ». Les développeurs sont sceptiques, et ce scepticisme a des fondements formels.
La formule « l’une des versions » laisse à Meta la liberté de publier une variante allégée. Les précédents modèles Llama étaient distribués sous une licence maison assortie d’un seuil de 700 millions d’utilisateurs actifs mensuels : les « poids ouverts » de Meta ont donc déjà voulu dire, une fois, « ouverts sous conditions ». Et la promesse émane de la même direction qui expliquait auparavant pourquoi la publication ouverte de Llama 4 prenait du retard.
Si les poids sont finalement publiés, le calcul change : une infrastructure propre règle à la fois la question du coût et celle de la transmission des données à un fournisseur. D’ici là, Muse Spark n’entre dans une architecture que comme l’API d’un tiers, ouverte pour l’instant aux seuls développeurs américains.
Des scores, mais pas de poids
Meta a mis neuf mois à revenir dans le top cinq d’un classement où les neuf premières places sont statistiquement indiscernables. Pendant ces mêmes mois, Z.ai, Alibaba et Sber ont publié leurs poids sous MIT et Apache 2.0, sans seuil de chiffre d’affaires.
L’entreprise qui a passé trois ans à expliquer que les poids ouverts étaient la seule stratégie honnête revient avec des poids fermés. La question que Muse Spark laisse ouverte : les poids ouverts étaient-ils pour Meta une stratégie, ou un moyen de compenser un retard de qualité ? Réponse quand « bientôt » sera arrivé.
L’outil est là. Place à la compétence
De l'expérimentation au système
Le socle du programme : prompt engineering, esprit critique et limites de la confiance dans l'IA – 4 chapitres, 23 leçons.
Stanislav Belyaev
Engineering Leader chez Microsoft18 ans a diriger des equipes d'ingenieurs. Fondateur de mysummit.school. 700+ diplomes chez Yandex Practicum et Stratoplan.