Les modèles Microsoft MAI en 2026 : ce qui est vraiment accessible, et à quel prix
Le 2 juin, à Build 2026, Microsoft a présenté sept modèles maison sous la marque MAI (Microsoft AI) : raisonnement, code, images, voix, transcription. Une entreprise qui a été pendant des années le premier investisseur d’OpenAI parle d’un virage vers « l’autosuffisance à long terme ».
Pour un manager, deux choses comptent dans cette annonce. D’abord le prix : transcrire une heure de réunion enregistrée coûte 0,10 $, sans contrat Azure. Ensuite Frontier Tuning, c’est-à-dire l’entraînement d’un modèle sur vos propres processus métier, à l’intérieur de votre propre périmètre de conformité. C’est l’idée la plus forte que Microsoft ait sortie cette année, et elle ne se vend qu’avec l’ensemble de la pile entreprise de Microsoft.
Commençons donc par qui peut acheter quoi, avant de passer aux modèles et aux chiffres.
D’abord : qui y a réellement accès
MAI existe en deux niveaux très différents. La moitié entreprise – Microsoft Foundry et Frontier Tuning – passe par une relation commerciale avec Azure : un compte, les achats, un contrat. L’autre moitié est ouverte à quiconque a une carte bancaire : les modèles d’image, de voix et de transcription sur OpenRouter à prix publics, plus le modèle de code intégré à GitHub Copilot.
Cet article fait volontairement l’impasse sur les tutoriels de configuration de Foundry. La documentation de Microsoft les couvre pour les équipes déjà sur Azure. On se concentre ici sur ce qu’un manager peut tester dès cette semaine, sans passer par le juridique ni par les achats.
Sept modèles conçus « de zéro »
Microsoft insiste sur l’origine : « Nous ne faisons pas de distillation à partir d’autres laboratoires et nous ne nous appuyons pas sur des données opaques. » Selon elle, l’entreprise a construit elle-même l’architecture, la chaîne d’entraînement et le post-entraînement, et a co-conçu les modèles avec sa propre puce Maia 200 – d’où un gain d’efficacité de 1,4 fois. MAI-Thinking-1 a été entraîné de zéro sur des données propres, sous licence commerciale, sans distillation d’OpenAI ni d’aucune autre famille de modèles.
Pour un acheteur entreprise soumis à des exigences de conformité sur l’origine des données, c’est là le vrai différenciateur. Le benchmark est secondaire : n’importe qui peut vérifier des chiffres de qualité, seul le fournisseur peut garantir d’où viennent les poids.
L’an dernier, nous écrivions que Microsoft avait discrètement gagné le marché de l’IA en entreprise. Cette même stratégie a désormais abouti à une gamme de modèles maison :
| Modèle | Ce que c’est | Chiffres clés |
|---|---|---|
| MAI-Thinking-1 | Modèle phare de raisonnement | MoE clairsemé : 35 milliards de paramètres actifs sur environ mille milliards ; contexte de 256K, réponse jusqu’à 64K tokens, texte uniquement |
| MAI-Code-1-Flash | Modèle de code agentique | 5 milliards de paramètres actifs, fenêtre de contexte de 256K tokens |
| MAI-Image-2.6 | Génération et retouche d’images | Variante Flash pour le volume à bas coût |
| MAI-Transcribe-2 | Reconnaissance vocale | 60 langues, terminologie métier |
| MAI-Voice-2 | Synthèse vocale | 15 langues, adaptation de la voix à partir d’un court échantillon, protections anti-abus |
Dix centimes l’heure d’enregistrement
Ce que l’on peut utiliser dès aujourd’hui se trouve sur OpenRouter, un agrégateur de modèles à prix publics, sans contrat entreprise. Voici ce qui y est proposé :
microsoft/mai-transcribe-2– 0,10 $ par heure d’audio, 60 langues. La version précédente,mai-transcribe-1.5, coûte 0,36 $ l’heure : la nouvelle est 3,6 fois moins chère.microsoft/mai-voice-2– 22 $ le million de caractères, 15 $ pour la variante flash.microsoft/mai-image-2.6– 5 $ le million, flash à 1,75 $ ; les versions 2.5 et 2.5-pro à 5 $ le million chacune.microsoft/mai-ds-r1– contexte de 164K tokens, prix non indiqué.
Une heure de réunion enregistrée pour dix centimes : c’est le chiffre le plus utile de toute l’annonce MAI. Microsoft qualifie elle-même MAI-Transcribe-2 de « modèle de reconnaissance vocale le plus rapide, le plus précis et le moins cher au monde » et revendique une vitesse cinq fois supérieure à celle de la concurrence. Comme toujours avec les déclarations d’un fournisseur, la précision mérite d’être vérifiée sur vos propres enregistrements – mais le prix est réel et public, et y accéder ne demande l’aval ni du juridique ni des achats.
La structure de la gamme est parlante. Le modèle phare de raisonnement est une préversion pour laquelle on obtient difficilement du quota, tandis que ce qui est prêt à l’emploi aujourd’hui, c’est un modèle de transcription qui ne fait pas les gros titres. Ce qui fonctionne chez MAI, c’est la partie ennuyeuse.
Les prix et les modes d’accès sont un savoir qui se périme en quelques mois. Décider quel modèle reçoit quelle tâche, et quel budget y consacrer, relève d’une compétence – et elle dure plus longtemps que n’importe quelle grille tarifaire.
Dix centimes l'heure d'enregistrement, c'est le prix. La question, c'est ce que vous confiez au modèle pour cette somme. Testez l'IA sur 9 tâches réelles de manager – gratuitement, sans inscription.
Sans paiement requis • Notification au lancement
Une réunion de 40 minutes en russe, trois modèles
Microsoft revendique pour MAI-Transcribe-2 la première place sur FLEURS : un WER moyen de 5,2 % sur 60 langues. Elle ne publie aucun chiffre par langue. La page du modèle indique 3,4 % pour les 25 premières langues : l’écart au sein du jeu de données est donc important, et impossible de savoir où tombe une langue donnée.
La moyenne a d’ailleurs augmenté par rapport aux 3,7 % de MAI-Transcribe-1.5 sur 43 langues. La raison tient à la composition : 17 langues peu dotées en données ont été ajoutées, si bien que la moyenne porte désormais sur un matériau plus difficile. Et FLEURS, c’est de la parole lue : des locuteurs natifs qui lisent environ 2 000 phrases préparées. Une réunion où l’on se coupe la parole, avec du bruit de fond et des essais de micro, ne sonne pas du tout pareil.
Nous avons donc testé sur quelque chose de plus proche de la réalité, et dans une langue autre que l’anglais. Nous avons choisi le russe : c’est la langue de notre lectorat d’origine, et Microsoft ne publie aucun chiffre pour cette langue, alors qu’ElevenLabs annonce un WER de 3,1 % en russe sur FLEURS. Au classement WER d’Artificial Analysis, MAI-Transcribe-2 arrive deuxième, derrière Alibaba Fun-Realtime-ASR. Microsoft revendique le leadership sur la vitesse et le prix, pas sur la précision.
L’enregistrement : une rencontre ouverte d’une communauté de team leads du Kazakhstan, « Тимлид не кодит » (« Le team lead ne code pas »), le 3 juin 2026. 39,6 minutes de russe parlé, plusieurs intervenants, des essais de micro au début ; au programme, un laboratoire de serveurs, le passage de la communauté de Telegram à Discord et la culture du recrutement. L’enregistrement est public, chacun peut donc revérifier les chiffres ci-dessous. Nous avons lancé MAI-Transcribe-2 via OpenRouter (microsoft/mai-transcribe-2), la voie qui ne demande pas de contrat Azure : les résultats ont été obtenus par le même chemin que celui dont dispose le lecteur. Le modèle est aussi disponible dans Azure Speech en préversion, mais cette voie exige un compte Azure. Pour comparer, nous avons utilisé Gemini 3.5 Flash et Yandex SpeechKit, l’API vocale de référence sur le marché russe.
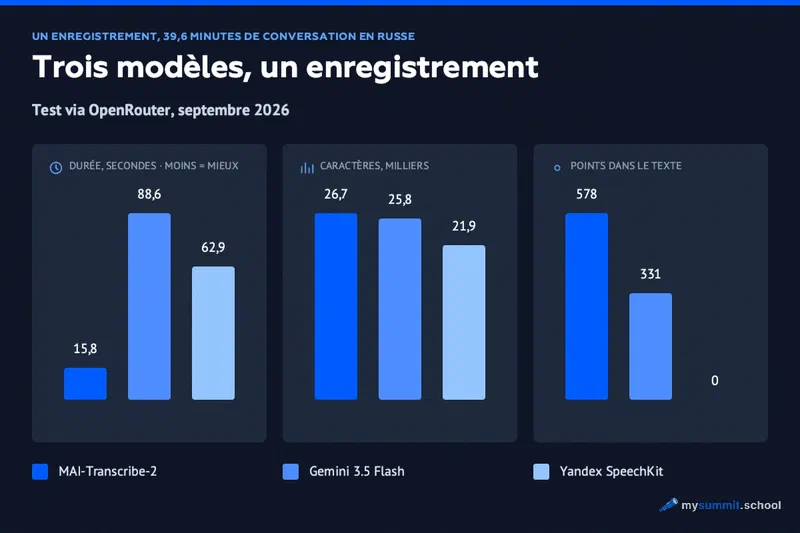
MAI a été 5,6 fois plus rapide que Gemini et 4 fois plus rapide que Yandex : 39,6 minutes d’audio en 15,8 secondes, quatre segments en parallèle, soit environ 150 fois le temps réel. La promesse de Microsoft sur la vitesse se vérifie sur de l’audio réel.
Yandex ne renvoie aucune ponctuation : zéro point, zéro virgule, une seule ligne de 21 910 caractères. Pour un compte rendu de réunion, cela impose un second traitement.
MAI conserve les hésitations : le « euh » russe (« э-э ») apparaît 54 fois dans sa transcription, zéro fois chez les autres. Le modèle propose des modes verbatim et clean : le premier pour une transcription intégrale, le second pour un compte rendu.
Les écarts visibles dans le texte
Le tout début de l’enregistrement, les essais de micro (en russe, tel que renvoyé par chaque modèle) :
| Modèle | Transcription |
|---|---|
| MAI-Transcribe-2 | «Добрый вечер. Так. А сейчас какой-то шум от меня хотя бы идёт. О, сейчас пошло. А, так, так, так, спикерс.» |
| Gemini 3.5 Flash | «Добрый вечер. Так. А сейчас какой-то шум от меня хотя бы идёт? О, сейчас пошло. А-а, так-так-так, спикером…» |
| Yandex SpeechKit | «Добрый вечер Так А сейчас какой то шум от меня хотя бы идет вова сейчас пошла а А так так так спикер с» |
L’intervenant dit à peu près : « Bonsoir. Bon. Est-ce qu’on m’entend, là ? Ah, ça marche. » Yandex a transformé l’interjection « Ah » (« О, ») en prénom, « Vova » (« вова »), et a même accordé le verbe avec. Il a aussi perdu le prénom « Aram », que les deux autres modèles ont bien entendu.
Le cas le plus grave est une inversion de sens au milieu de l’enregistrement :
| Modèle | Transcription |
|---|---|
| MAI-Transcribe-2 | «…музыку-то слышал. Мне интересно. Похоже, т- техника как бы, которая… всё портит.» |
| Gemini 3.5 Flash | «…музыку-то слышал? Мне интересно. Похоже тут техника как бы, которая всё портит.» |
| Yandex SpeechKit | «…музыку то слышал Не интересно. Покажите техника как бы которая Все портит» |
Deux erreurs dans une seule phrase, et toutes deux inversent le sens : « Ça m’intéresse » (« Мне интересно ») est devenu « Pas intéressant » (« Не интересно »), et « On dirait » (« Похоже ») est devenu « Montrez-moi » (« Покажите »). Dans un compte rendu de réunion, c’est une autre affirmation – et quelqu’un va la valider.
À écouter vous-même
Les essais de micro, c’est le cas facile. Prenons le milieu de la réunion, là où l’on parle vraiment travail : de 10:55 à 11:55, les participants discutent du passage de la communauté de Telegram à Discord et de la répartition des droits dans les canaux. L’audio est en russe. Lancez-le et passez d’un onglet à l’autre : chacun contient la transcription littérale de cette même minute par un modèle, suivie d’une note en français sur ce qu’il a réussi ou raté.
▸Le nom du produit est reconnu à chaque fois, mais écrit de deux façons : d'abord en cyrillique (« Дискорд »), puis en alphabet latin, « Discord ». Dans la même minute.
▸Les deux noms de produit en alphabet latin, écrits de la même façon dans les quatre occurrences.
▸Le mot Discord n'apparaît pas une seule fois. À la place : « лесики скорбь » (à peu près « petits bois chagrin »), « без слов » (« sans mots ») et, deux fois, « диспорт ». Quatre tentatives, quatre ratés.
Extrait de l’enregistrement public de la rencontre « Тимлид не кодит » du 3 juin 2026, organisée par une communauté de team leads du Kazakhstan. Les tirets à l’intérieur des transcriptions sont ceux que les modèles ont renvoyés.
Un nom de produit déformé se repère d’un coup d’œil, et en ce sens cette erreur est moins dangereuse qu’une inversion de sens. Le vrai problème est ailleurs : « в принципе без слов мало кто пришёл » (« en principe, sans mots, peu de gens sont venus ») se lit comme une phrase complète, et personne ne la signalera dans le compte rendu.
On voit aussi ici la différence entre les modes verbatim et clean. MAI a conservé le bégaiement « т- техника » (« la t- technique »), tandis que Gemini l’a lissé en « тут техника » (« ici la technique »), en ajoutant un mot absent de l’enregistrement. On ne peut pas en conclure que « Gemini est plus précis » : les modes sont différents, et pour une transcription intégrale, la version lissée est moins bonne.
Troisième écart : un passage qui a entièrement disparu. MAI l’a : « Мо- может кто-то поговорить, э-э, просто так, чтобы… Раз-раз. Ну, раз-раз я слышу. О, ну всё хорошо тогда, хоть что-то слышат. » (« Quel- quelqu’un peut parler, euh, juste pour… Un, deux. Bon, le un, deux, je l’entends. Ah, tout va bien alors, on entend au moins quelque chose. ») Chez Gemini et Yandex, le passage du « un, deux » est absent : les deux modèles l’ont sauté.
Ce que ce test ne montre pas
- Nous n’avons pas mesuré le WER : il n’existe pas de transcription de référence pour cet enregistrement, la comparaison est qualitative.
- La terminologie sectorielle n’a pas pu être testée – il n’y en avait pas dans l’enregistrement. C’est précisément là que joue le keyword biasing de MAI, et précisément ce qui reste à vérifier.
- Un enregistrement, un domaine, une acoustique. C’est une vérification avant achat ; on ne peut pas appeler ça un benchmark.
Des services spécialisés pour l’audio en russe
Si c’est précisément un compte rendu en russe qu’il vous faut, il existe des alternatives testées sur de l’audio russe. Un comparatif des meilleures API de reconnaissance vocale publié sur Habr (en russe, février 2026) donne ces WER :
- Nexara – 0,391
- Palatine – 0,414
- Shopot – 0,444
- Sber API – 0,448
- Yandex SpeechKit – 0,550, dernière place
De petites startups russes font mieux que les deux grands acteurs locaux, Yandex et Sber. Si votre équipe tient ses réunions en russe, c’est une vraie alternative.
La conclusion reste la même : testez le modèle sur votre propre enregistrement avant de l’intégrer à un processus. Microsoft a la transcription la plus rapide et le prix le plus bas, aucun chiffre publié pour le russe, et sur notre enregistrement MAI-Transcribe-2 a donné le meilleur résultat en ponctuation et en structure. C’est suffisant pour lancer un test. Pas pour acheter les yeux fermés.
MAI-Thinking-1 : une préversion avec un prix public
Le modèle phare figure dans le catalogue de Microsoft Foundry en préversion, mais Microsoft a publié ses tarifs d’emblée : 2 $ par million de tokens en entrée et 8 $ par million en sortie [Microsoft Foundry blog].
À titre de comparaison, dans la même grille tarifaire, Sonnet 4.6 coûte 3 $ et 15 $ : en sortie, MAI-Thinking-1 est donc presque deux fois moins cher. Chez un modèle de raisonnement, le mix entrée/sortie penche vers la sortie, donc l’écart sur la facture sera plus proche de deux fois que d’une fois et demie.
Le prix catalogue et l’accès au modèle sont deux choses différentes. Les quotas de la préversion sont distribués au compte-gouttes : les requêtes vers MAI-Thinking-1 se heurtent régulièrement à un manque de quota, et « le modèle est au catalogue » ne veut pas dire qu’il traitera votre tâche aujourd’hui. Il est trop tôt pour bâtir un processus dessus.
D’après la fiche du modèle : fenêtre de contexte de 256K tokens, plafond de réponse de 64K tokens, entrée et sortie en texte uniquement, hébergement sur Azure. Il n’accepte ni images ni audio : pour des tâches avec des captures d’écran ou des enregistrements de réunion, il ne sert tout simplement à rien.
Les garanties de résidence des données dépendent de la région Azure, et la couverture régionale était encore en cours de déploiement au lancement.
Les affirmations sur la qualité sont, elles aussi, celles de Microsoft. Selon ses données, MAI-Thinking-1 égale Opus 4.6 sur SWE-Bench Pro et a été préféré à Sonnet 4.6 lors d’une évaluation humaine à l’aveugle. On attribue à MAI-Code-1-Flash une consommation de tokens jusqu’à 60 % inférieure à celle de Haiku 4.5 sur les benchmarks de code, avec une meilleure précision. Aucune de ces comparaisons n’a encore été confirmée de façon indépendante, et aucun modèle MAI ne figure non plus dans notre benchmark. Nous avons une analyse dédiée à la lecture de ce genre d’annonces : Les benchmarks IA perdent leur sens – alors comment choisir un modèle ?
MAI-Code-1-Flash : un prix qu’on ne peut pas payer
Pour le modèle de code, on annonce 0,75 $ par million de tokens en entrée et 4,50 $ par million en sortie, l’entrée en cache à 0,075 $. Ce sont exactement les chiffres de GPT-5.4 Mini.
Il faut les donner avec une réserve : le modèle n’a ni point d’accès public ni fiche dans Azure AI Foundry, et sa fiche indique un prix « à déterminer ». Autrement dit, ces tarifs décrivent la comptabilité interne des tokens dans Copilot. Il n’existe aucune API où l’on pourrait les payer.
Là où le modèle est réellement disponible, c’est dans GitHub Copilot et VS Code : les requêtes sont routées automatiquement vers MAI-Code-1-Flash, sur toutes les formules, de Free à Max ; une version CLI est prévue. C’est la deuxième voie d’accès à la gamme MAI, après OpenRouter, qui ne demande pas de contrat Azure.
Frontier Tuning : l’entraînement à l’intérieur de votre périmètre
La vraie nouveauté de l’annonce. Le fine-tuning classique travaille sur des documents : vous fournissez un corpus de textes et obtenez un modèle qui connaît votre terminologie. Frontier Tuning fonctionne autrement : l’apprentissage par renforcement se déroule dans le périmètre de conformité du client, et le modèle apprend à partir de traces réelles de processus métier – enchaînements d’outils, décisions et leurs résultats. Microsoft appelle ces environnements d’apprentissage par renforcement des « salles de sport pour l’IA » ; les données ne quittent pas l’environnement du client. Pour la première fois sur cette plateforme, les développeurs peuvent ajuster les poids eux-mêmes.
Nous avons détaillé ce que les environnements d’entraînement apportent déjà aux dirigeants : Environnements d’entraînement de l’IA : des enseignements de management à 1 milliard de dollars.
Les résultats de Frontier Tuning relèvent, pour l’instant, des déclarations du fournisseur et de ses partenaires :
- Dans le déploiement RH interne de Microsoft, le taux de tâches menées à bien est passé de 13 % à 87 % après ajustement.
- Un modèle MAI ajusté pour Excel égale GPT-5.4 avec une efficacité jusqu’à 10 fois supérieure.
- McKinsey fait état du meilleur taux de victoire parmi tous les modèles testés, pour un écart de coût d’environ 10 fois.
Le message à retenir pour un manager : un petit modèle taillé pour votre processus bat un modèle phare généraliste pour une fraction du prix. Le calcul n’est pas nouveau – nous l’avions vu sur un marché de 53 modèles : 99 % de la qualité pour 1,4 % du prix.
L’autre moitié de la vérité, c’est que Frontier Tuning est aussi un argument pour acheter toute la pile Microsoft : Foundry, Copilot Studio, les puces Maia, les Forward Deployed Engineers. L’idée forte ne se vend ici qu’avec l’écosystème : si vous n’êtes pas déjà un client Azure engagé, le ticket d’entrée, c’est l’ensemble. La tendance mérite tout de même d’être suivie : d’autres fournisseurs vont dans le même sens, et si vos données ne peuvent absolument pas sortir de l’entreprise, la réponse passe par votre propre matériel – LLM locaux pour managers.
Le cas de la Mayo Clinic s’inscrit dans la même logique entreprise : un modèle de pointe pour la médecine, construit sur l’expertise de la clinique et ses données cliniques anonymisées, déployé d’abord en interne chez Mayo, promis plus tard dans Foundry. Le point clé, c’est une clause du contrat : Mayo reste propriétaire du modèle. Pour tout leader de son secteur, c’est le modèle à suivre pour co-construire un modèle avec une plateforme sans lui céder son actif.
Où obtenir l’accès
Toutes les voies, de la plus accessible à la plus fermée :
| Voie | Ce qu’elle donne | Réalité |
|---|---|---|
| OpenRouter | Modèles d’image, de voix et de transcription, prix publics | Pas de contrat Azure – la seule voie qui fonctionne sans relation commerciale |
| GitHub Copilot / VS Code | MAI-Code-1-Flash, routage automatique | Formules de Free à Max ; version CLI prévue |
| Fireworks, Baseten | MAI-Thinking-1 | Hébergement tiers |
| Microsoft Foundry | Toute la gamme, évaluation, sécurité, observabilité, Frontier Tuning | Nécessite un compte entreprise Azure |
| Copilot Studio / Forward Deployed Engineers | Projets Frontier Tuning | Contrat direct, entreprise uniquement |
Aucun modèle MAI ne figure encore dans notre benchmark ; ce qu’il contient et comment comparer entre eux les modèles testés, c’est dans le hub de la série : Comparatif des outils GenAI 2026.
Comment l’appliquer au travail
- Enregistrez votre prochaine réunion et passez l’audio dans MAI-Transcribe-2 sur OpenRouter : une heure coûte 0,10 $. Comparez avec ce que vous payez aujourd’hui pour la transcription, et avec la fréquence à laquelle elle écorche la terminologie de votre métier.
- Si votre équipe paie déjà GitHub Copilot, regardez vers quel modèle partent vos tâches courantes et si la qualité change quand le routage choisit MAI-Code-1-Flash.
- Ne budgétez pas Foundry si votre entreprise n’est pas déjà très engagée sur Azure. Surveillez plutôt les offres d’ajustement sur les processus chez les fournisseurs avec lesquels vous travaillez déjà.
Après des années comme premier investisseur d’OpenAI, Microsoft en arrive à une idée qui dérange tout le marché des modèles de pointe : un petit modèle bien ajusté donne le même résultat pour un dixième du prix. Et elle ne vend cette idée qu’avec son cloud, son matériel et ses ingénieurs. Ce que n’importe quel manager peut utiliser aujourd’hui, c’est une heure d’enregistrement pour dix centimes.
La question ne porte plus vraiment sur Microsoft. Si l’ajustement à un processus permet réellement d’obtenir le même résultat pour une fraction du prix, combien de temps les grilles tarifaires des modèles phares tiendront-elles – et lequel des fournisseurs avec lesquels vous travaillez déjà réagira le premier ?
Le prix des tokens change. Savoir choisir un modèle, ça reste
Programme complet : des bases du prompt engineering et de la pensée critique aux spécialisations en gestion de projet et analytique. Des compétences pratiques, pas de la théorie.
Stanislav Belyaev
Engineering Leader chez Microsoft18 ans a diriger des equipes d'ingenieurs. Fondateur de mysummit.school. 700+ diplomes chez Yandex Practicum et Stratoplan.