Сравнение GenAI инструментов 2026: какой ИИ выбрать менеджеру

AI-модели в этой статье
К сентябрю 2026 года на рынке генеративного ИИ – десятки инструментов. Каждый производитель заявляет о лидерстве, а маркетинговые материалы соревнуются в громкости. Как менеджеру выбрать инструмент, который реально решает задачи?
В этой статье – ключевые характеристики основных GenAI-инструментов, которые мы подробно разобрали в серии обзоров. Здесь сводные таблицы, рекомендации по сценариям и практические советы для выбора.
Между июльской и сентябрьской версией этой страницы сменился почти каждый флагман в таблицах. OpenAI, Anthropic, Google, xAI, Alibaba и Z.ai выпустили новые старшие модели за шесть недель. Ниже – что из этого меняет решение менеджера и что останется в пресс-релизах.
Линейка на 6 сентября 2026
| Вендор | Флагман сейчас | Дата релиза | Что стояло в июльской версии этой статьи |
|---|---|---|---|
| OpenAI | GPT-6 Astra | 3 сентября | GPT-5.6 Sol |
| Anthropic | Claude Fable 5.1, рабочая модель – Opus 5 | 1 сентября и 24 июля | Opus 4.6 / 4.8 |
| Gemini 3.8 Flash; старшей модели нет | 2 сентября | Gemini 3.1 Pro | |
| xAI | Grok 4.6 | 12 августа | Grok 4.5 |
| Alibaba | Qwen3.8-Max | 3 августа | Qwen 3.6 Plus / 3.7 Max |
| Z.ai | GLM-5.3 и GLM-5.3-Flash | 14 и 26 августа | GLM-5.1 / 5.2 |
| DeepSeek | V4-Pro в статусе GA | 13 августа | V4-Pro / V4-Flash |
| Moonshot | Kimi K3 | 16 июля | без изменений |
| Сбер | GigaChat 3.5 Ultra, теперь под MIT | июль | без изменений |
| Яндекс | Alice AI, YandexGPT 5.1 Pro | 28 июля | без изменений |
Ни одна модель, выпущенная после 16 июля, в наш бенчмарк ещё не входит. Всё, что ниже сказано про GPT-6 Astra, Claude Fable 5.1 и Opus 5, Gemini 3.8 Flash, Grok 4.6, Qwen3.8 и GLM-5.3, опирается на данные производителей и на независимые площадки – Artificial Analysis и LMArena. Результаты нашего собственного бенчмарка описывают июльскую линейку, и мы везде это помечаем.
Историческую справку про GPT-5.4 из мартовской версии статьи мы убрали: за полгода её сменил GPT-5.6 Sol, а теперь Astra. От того релиза осталось одно следствие – управление компьютером перестало быть редкостью. Astra развивает ровно его: на OSWorld V2-Offline модель, по данным OpenAI, набирает 72,6% против 65,7% у GPT-5.6 Sol и тратит на задачу около 40 минут вместо 75. По коду прирост скромнее – 74,1% на DeepSWE v1.1 против 72,7%.
Результаты бенчмарка mysummit.school (июль 2026)
С момента публикации мы, образовательная платформа mysummit.school, провели независимый бенчмарк на 47 моделях. Модели решали реальные менеджерские задачи, ответы оценивали две модели-судьи – Claude Opus 4.6 и Gemini 3.1 Pro. Методика и шкала описаны на странице бенчмарка.
Граница простая: эти результаты наши, они относятся к тем моделям, которые мы прогнали. Всё, что вендоры выпустили после 16 июля, в них отсутствует и появится только после следующего прогона.
Главные открытия:
- На вершине – GPT-5.6 Sol от OpenAI и Kimi K3 от Moonshot: первое и второе места июльского прогона. Kimi K3 – самая сильная модель рейтинга из тех, что работают из России без VPN.
- Китайские модели – в топ-10. Помимо Kimi K3, из России напрямую доступны MiniMax M3 и MiMo v2.5 Pro от Xiaomi. Все три стоят в 5–10 раз дешевле западных аналогов.
- DeepSeek V4 Flash на Яндекс Облаке в 28–33 раза дороже оригинала при чуть более низком качестве.
- Новейшая модель Сбера GigaChat 3.5 Ultra заметно подтянулась относительно GigaChat 2 Max, но по цене сравнялась с GPT-4, и до лидеров ей ещё далеко.
- Grok 4.5 замыкает топ-10 и остаётся одним из лучших по управлению командой – но в российский шорт-лист не попадает.
- У Qwen пять моделей в топ-30, все доступны из России. Qwen 3.6 Plus – лучшее соотношение цена/качество.
Подробные результаты по каждому инструменту – в обновлённых статьях серии ниже.
Что изменилось по существу
Семь сюжетов, которые идут поперёк вендоров. Их стоит держать в голове раньше, чем открывать любую таблицу.
Дешёвая модель теперь часто оказывается лучшей
Gemini 3.8 Flash стоит $0,75 за 1M входных токенов и $3,75 за 1M выходных – это вводный прайс Google. По индексу Artificial Analysis она набирает 47 пунктов – столько же, сколько Qwen3.8-Max за $2/$6, и на пять больше, чем DeepSeek V4-Pro. На текстовой таблице LMArena она восьмая.
Две оговорки, которые меняют расчёт. Вводная цена действует до 31 декабря 2026, обычный тариф Google не опубликовала. И сама же Google предупреждает: реальная стоимость запроса выходит примерно на 40% выше прайса, потому что модель порождает больше выходных токенов и делает больше агентских шагов.
GLM-5.3-Flash стоит $0,15/$0,50 против $1,40/$4,40 у старшей GLM-5.3. По индексу Artificial Analysis она отстаёт от неё на три пункта – 46 против 49 – при семикратной разнице в смешанной цене. Z.ai приводит и собственные сравнения с прошлым поколением: на DeepSWE v1.1 у Flash 63,4 против 46,2, на AutomationBench 48,8 против 26,2. Три пункта индекса за семикратную экономию – сделка, которую считают под конкретную задачу, а не принимают на веру.
Anthropic выстроила на этом же принципе линейку. Opus 5 за $5/$25, по данным Anthropic, укладывается в 0,5% от пика Fable 5 на CursorBench 3.2 при вдвое меньшей стоимости задачи. Fable 5.1 за $10/$50 – эскалация для действительно трудных задач, а не рабочий режим.
Покупать старшую модель по умолчанию в сентябре 2026 года ошибочно чаще, чем правильно.
Пороги цены пересчитывают весь запрос
GPT-6 Astra по прайсу OpenAI: $10 вход и $50 выход за 1M токенов, пока во вход не попадает больше 272K. Дальше ставка входа удваивается до $20, выхода – до $75, и пересчитывается весь запрос, а не только токены за чертой. Один длинный документ в контексте меняет цену всего обращения.
Grok 4.6 устроен так же, черта ниже – 200K: $2/$6 превращаются в $4/$12.
DeepSeek V4-Pro с 16 августа считает по пиковым и непиковым окнам; пики – 01:00–04:00 и 06:00–10:00 UTC, непиковое время вдвое дешевле. Одновременно тарифы на попадание в кеш выросли относительно первоначальных preview-цен на порядок с лишним – по данным официального changelog DeepSeek, до 1 100%. Дешевле всех – да, агрессивно дёшево – уже нет.
Ни один из этих механизмов не виден на странице с ценами так, как его увидит финансовый отдел в конце месяца.
Скорость – переменная, которую никто не сравнивает
Artificial Analysis меряет скорость вывода в токенах в секунду. У Gemini 3.8 Flash – 334. У остальных девяти моделей первой десятки – от 40 до 87; медленнее всех Qwen3.8-Max и Kimi K3, 40 и 42 соответственно.
Задержку не выносят на слайд, и её чувствуют все, кто ждёт ответа дольше пары секунд. В сценариях, где модель работает внутри интерфейса пользователя – поддержка, разбор документа, черновик письма, – четырёхкратная разница в скорости заметнее трёх пунктов индекса.
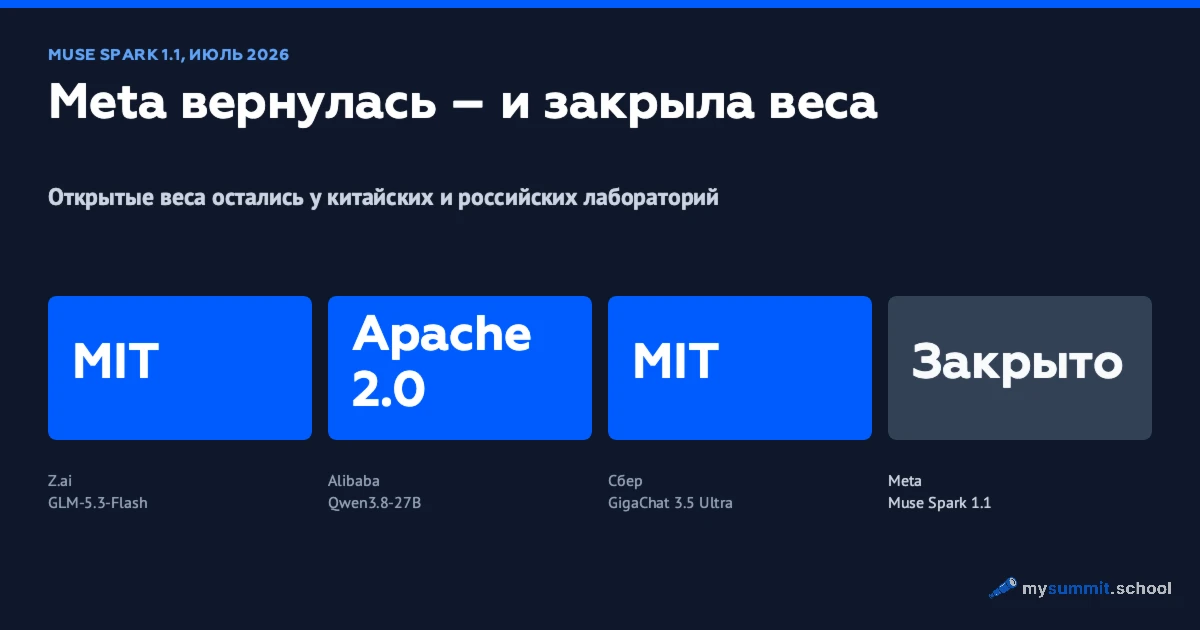
«Открытые веса» теперь значат четыре разных вещи
| Что написано | Что это даёт | Примеры из сентябрьской линейки |
|---|---|---|
| MIT | Весами можно распоряжаться без условий | GLM-5.3-Flash, GigaChat 3.5 Ultra, DeepSeek V4-Pro |
| Apache 2.0 | То же плюс явная патентная оговорка | Qwen3.8-27B, всё семейство Qwen 3.5 |
| Своя лицензия с порогом по выручке | Ниже порога – свободно, выше – договор с вендором | Qwen3.8-Max (порог $50 млн дохода от AI-сервисов), Kimi K3 ($20 млн) |
| Закрытые веса | Только API или подписка | OpenAI, Anthropic, Google, xAI, Яндекс, Meta |
Эта колонка полезнее любой бенчмарк-колонки. Оценку модели пересчитают через шесть недель, а текст лицензии вендоры меняют реже и предупреждают заранее.
Отдельно про Qwen3.8-Max: Alibaba впервые пообещала открыть Max-модель, но лицензия, по имеющимся данным, своя, с выручкой свыше $50 млн как условием для переговоров. Проверьте её до того, как закладывать самостоятельный хостинг в план.
Хостинг у себя перестал быть компромиссом
Qwen3.8-27B – плотная модель на 27–28 млрд параметров с энкодером зрения, контекст 262K, Apache 2.0. В квантовании Q4_K_M это около 17 ГБ: помещается на одну потребительскую видеокарту уровня RTX 4090 или в 16-гигабайтный ноутбук через Ollama и llama.cpp.
GLM-5.3-Flash под MIT требует около 306 GiB в FP8 и NVIDIA Hopper или новее. Это уже масштаб средней и крупной компании, но условия в лицензии отсутствуют полностью.
GigaChat 3.5 Ultra – 432B MoE, тоже MIT. Qwen3.8-Max весит около 2,5 ТБ в FP8 и остаётся решением для дата-центра.
Для российской компании с требованиями к хранению данных это действительно новый набор вариантов: ещё в июле ответ «оставить у себя» означал выбрать модель заведомо слабее облачных.
Зрение пришло неравномерно
Qwen3.8-Max, по карточке OpenRouter, принимает текст, изображение и видео. Зрительная таблица LMArena ставит qwen3.8-max на третье место с 1300±8 – независимое подтверждение того, что мультимодальность настоящая, в противовес вторичному источнику, который называл Max-уровень текстовым.
GLM-5.3-Flash – первая нативно мультимодальная модель в линейке GLM-5: текст, изображение, видео, файлы.
История с её появлением поучительна. 29 июня основатель Zhipu Jie Tang спросил сообщество, что должно быть в следующей GLM. В 1 400 с лишним ответах доминировало зрение – разработчики хотели разбирать скриншоты, PDF, макеты и тексты ошибок без промежуточной модели. GLM-5.3 вышла 14 августа без зрения. Зрение появилось через двенадцать дней в другой продуктовой линейке.
DeepSeek ответила 21 августа моделью deepseek-v4-flash-vision-exp: изображения и скриншоты, статичные, последовательностью кадров, но без настоящего видео; тарифицируется по ценам V4-Flash, на Chartography набирает 64,3. Суффикс -exp здесь рабочий, а не декоративный – строить на этом продуктив рано.
Google сделала другое. С 1 сентября у 3.7 Flash, 3.6 Flash и 3.5 Flash-Lite работает агентское понимание видео: модель ходит по записи и забирает нужные расшифровки, кадры и звук по запросу, вместо того чтобы проглатывать всё. На длинных записях это до 88% меньше токенов – прямая строка бюджета для любого, кто обрабатывает записи звонков или обучающие видео.
Планировать вокруг этих историй стоит по одному правилу: опираться можно на то, что уже вышло.
У Google нет старшей модели
Четыре Flash-релиза за 106 дней – 3.5 Flash-Lite, 3.6, 3.7 и 3.8 Flash, с конца мая по 2 сентября. Gemini 3.5 Pro Сундар Пичаи обещал в июне; статус на сегодня – «скоро выйдет». По сообщению WSJ, внутренние кандидаты на флагман недостаточно превосходили Flash, чтобы оправдать релиз.
Для закупки это значит одно: если нужна модель верхнего уровня, Google сейчас нечего продать.
Есть и операционная сторона. 21 июля Google объявила temperature, top_p и top_k устаревшими – поменяла настройки посреди потока релизов. Промпты, подобранные под 3.6 Flash, на 3.8 Flash не гарантированы, и четыре смены модели за 106 дней – это отдельная статья расходов на регрессионные проверки.
Независимые площадки
Две площадки тестируют всех в одинаковых условиях. Когда статья сравнивает модели, опираться надо на них, а не на цифры из анонсов.
Artificial Analysis, данные на 6 сентября 2026
| Модель | Вендор | Индекс интеллекта | Смешанная цена, $/1M | Вывод, ток/с |
|---|---|---|---|---|
| Claude Fable 5.1 (max, w/ fallback) | Anthropic | 57 | $6,12 | 70 |
| GPT-6 Astra (max) | OpenAI | 55 | $2,57 | 71 |
| Claude Opus 5 (max) | Anthropic | 54 | $4,21 | 58 |
| Muse Spark 1.3 (max) | Meta | 53 | $0,96 | 190 |
| GPT-5.6 Sol (max) | OpenAI | 51 | $1,25 | 85 |
| Grok 4.6 (high) | xAI | 51 | $1,25 | 63 |
| Kimi K3 (max) | Moonshot | 50 | $1,58 | 42 |
| GLM-5.3 (max) | Z.ai | 49 | $1,26 | 87 |
| Gemini 3.8 Flash (high) | 47 | $0,74 | 334 | |
| Qwen3.8 Max | Alibaba | 47 | $1,19 | 40 |
| Qwen3.8-Flash-Next | Alibaba | 46 | – | – |
| GLM-5.3-Flash | Z.ai | 46 | $0,18 | 48 |
| DeepSeek V4 Pro 0813 (max) | DeepSeek | 42 | $0,33 | 71 |
Оговорка, без которой таблицей лучше не пользоваться: Artificial Analysis публикует индекс версиями и перемасштабирует его между ними. «60» из анонса Z.ai и «49» на живой доске – это одна модель на разных шкалах. Сравнивать можно только внутри одного снимка.
Разброс между первым и последним местом в таблице – 15 пунктов. Разброс в цене – 34 раза, $6,12 против $0,18. Между этими двумя числами и лежит реальное решение: насколько пятнадцать пунктов индекса стоят тридцатикратной переплаты именно на ваших задачах.
LMArena, данные на 6 сентября 2026
Текст, первые десять:
| # | Модель | Рейтинг |
|---|---|---|
| 1 | claude-fable-5 (Anthropic) | 1507±5 |
| 2 | claude-opus-4-6-high | 1505±4 |
| 3 | claude-fable-5.1-max | 1504±11 |
| 4 | claude-opus-4-7-high | 1502±4 |
| 5 | muse-spark-1.2 xHigh (Meta) | 1499±10 |
| 6 | claude-opus-4-6 | 1498±3 |
| 7 | claude-opus-4-7 | 1494±4 |
| 8 | gemini-3.8-flash-high (Google) | 1494±9 |
| 9 | claude-opus-5-high | 1493±5 |
| 10 | muse-spark-1.1 (Meta) | 1492±5 |
Зрение, первые десять:
| # | Модель | Рейтинг |
|---|---|---|
| 1 | claude-fable-5 | 1313±8 |
| 2 | claude-opus-4-7-high | 1301±7 |
| 3 | qwen3.8-max (Alibaba) | 1300±8 |
| 4 | claude-opus-4-7 | 1299±7 |
| 5 | claude-opus-4-6-high | 1299±7 |
| 6 | muse-spark (Meta) | 1294±9 |
| 7 | claude-opus-4-6 | 1293±7 |
| 8 | muse-spark-1.2 xHigh (Meta) | 1292±15 |
| 9 | claude-opus-5-high | 1290±8 |
| 10 | gemini-3-pro (Google) | 1289±8 |
Цифры в этих двух таблицах – с LMArena, к нашему бенчмарку они отношения не имеют.
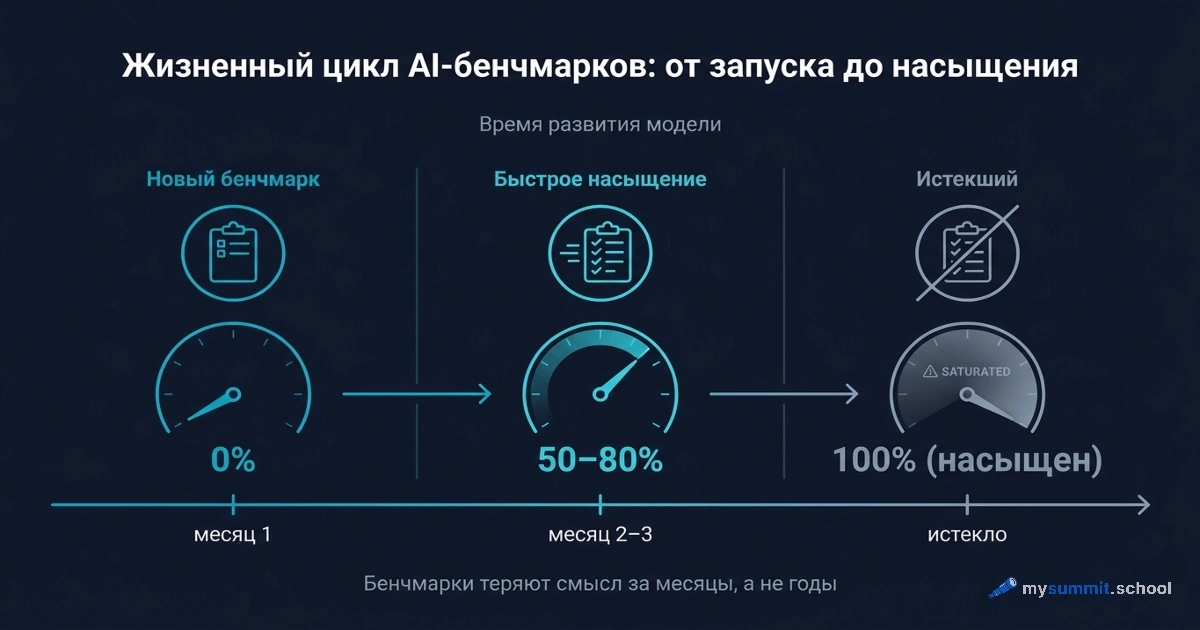
Интервалы у позиций с первой по девятую перекрываются на обеих досках. Статистически это ничья, и любой текст, который на основании LMArena называет лучшую модель, читает доску сильнее, чем она позволяет. Подробно мы разбирали этот механизм в статье «Бенчмарки ИИ теряют смысл»; про то, как устроено само измерение, – в «Как оценивают качество LLM».
Две доски расходятся показательно. Anthropic занимает шесть из десяти мест по человеческому предпочтению и при этом находится в середине таблицы Artificial Analysis. Одна доска проверяет ответы по рубрике, другая спрашивает людей, какой текст им приятнее читать. Это разные величины, и путать их – обычная ошибка при выборе.
Meta с семейством muse-spark держится в первой десятке обеих таблиц, а Muse Spark 1.3 на Artificial Analysis идёт четвёртой строкой при цене $0,96 и скорости 190 токенов в секунду – вдвое быстрее всех, кто стоит выше. Разбор линейки – в отдельной части серии.
До сих пор речь шла про то, как модели измерять. С измерениями всё непросто: наш бенчмарк описывает июльскую линейку, Artificial Analysis пересчитывает шкалу между версиями, на LMArena первые девять позиций неразличимы. Задача менеджера от этого не меняется – ему нужен ответ, который можно положить в отчёт или отдать заказчику. Одна и та же модель в двух формулировках даёт черновик, который приходится переписывать, и результат, который переписывать не нужно. Разница между «работает» и «работает надёжно» – это навык формулирования задач для AI.
9 практических задач менеджера – бесплатно и без регистрации: письмо клиенту, резюме совещания, скрининг резюме, стратегическая записка. Те же инструменты из таблиц ниже, только с вашей стороны экрана.
Доступ сразу после регистрации
Сводная таблица: 13 инструментов в сравнении
Третий столбец – модель из нашего июльского прогона, а не текущий флагман: всё, что вышло после 16 июля, мы ещё не тестировали. Места и баллы – в живой таблице «Цена и результат» ниже: она обновляется с каждой волной бенчмарка.
| Инструмент | Флагман на 6 сентября 2026 | Модель в нашем бенчмарке | Контекст | Подписка | Сильная сторона |
|---|---|---|---|---|---|
| ChatGPT | GPT-6 Astra | GPT-5.6 Sol | 1M токенов у Astra | $20–200/мес | Универсальность, экосистема, управление компьютером |
| Claude | Fable 5.1, рабочая – Opus 5 | Opus 4.6 | 1M токенов | $20–200/мес | Качество текста, планирование, браузер и Cowork |
| Gemini | 3.8 Flash; старшей модели нет | 3.1 Pro | 2M токенов у 3.1 Pro | $20–250/мес | Google Workspace, скорость вывода |
| Perplexity | Мульти-модель | не тестировался | Варьируется | $20/мес | Поиск с источниками |
| Grok | 4.6 | 4.5 | 500K токенов | $8–35/мес | Управление командой, скрипты конфликтов |
| YandexGPT | Alice AI, YandexGPT 5.1 Pro | Alice AI v3 | 128K токенов | По API | Русский язык, Яндекс 360 |
| GigaChat | 3.5 Ultra | 3.5 Ultra | – | По API | Хранение данных в РФ, открытые веса MIT |
| DeepSeek | V4-Pro (GA) | V4-Pro | 1M токенов | По API | Цена, потолок вывода почти 400 тыс. токенов |
| Qwen | Qwen3.8-Max | 3.6 Plus | 1M токенов у Qwen3.8-Max | По API | 5 моделей в топ-30, открытые веса |
| GLM-5 от Z.ai | GLM-5.3 и GLM-5.3-Flash | GLM-5.2 | 1M токенов | По API | MIT-веса у Flash, мультимодальность |
| Kimi | K3 | K3 | 1M токенов | $19–199/мес | Сильнейшая из доступных из РФ напрямую |
| MiMo (Xiaomi) | v2.5 Pro | v2.5 Pro | – | По API | Топ-10 с прямым доступом из РФ |
| MiniMax | M3 | M3 | – | По API | Доступ из РФ, лучшая цена среди доступных из РФ в топ-10 |
Meta с семейством muse-spark в эту таблицу не попала: в наш бенчмарк она не входит. Разбор – в обзоре линейки Muse Spark, данные независимых площадок приведены выше.
Цены сентябрьских релизов
Цифры – из прайсов производителей, в наш бенчмарк эти модели не входят.
| Модель | Вход, $/1M | Выход, $/1M | Что важно знать |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | Свыше 272K входных токенов – $20 и $75 на весь запрос |
| Claude Fable 5.1 | $10 | $50 | Чтение кеша $0,25, на 75% дешевле Fable 5 |
| Claude Opus 5 | $5 | $25 | Вдвое дешевле Fable 5.1 |
| Grok 4.6 | $2 | $6 | Свыше 200K – $4 и $12 |
| Gemini 3.8 Flash | $0,75 | $3,75 | Вводная цена до 31 декабря 2026, обычный тариф не объявлен |
| Qwen3.8-Max | $2 | $6 | Чтение кеша $0,25 |
| Qwen3.8-Flash-Next | $0,16 | $0,47 | Предпросмотр архитектуры Qwen4, контекст до 1M через YaRN |
| GLM-5.3 | $1,40 | $4,40 | Цена не менялась с прошлого поколения |
| GLM-5.3-Flash | $0,15 | $0,50 | Промо до 9 сентября – $0,075/$0,25 |
Batch и Flex у OpenAI стоят вдвое дешевле, быстрый режим – вдвое дороже за двукратную скорость. У GPT-6 Astra есть ещё одна особенность доступа: это первая модель, которая попала под критический порог кибербезопасности в Preparedness Framework OpenAI. Стандартный API отказывает в задачах на поиск уязвимостей, полный доступ дают только программам Trusted Access и Daybreak, а обычные пользователи, по предупреждению OpenAI, могут упираться в замедления и блокировки.
Сравнение по стоимости
| # | Модель | Балл | Цена /1M | За тест | Доступ из РФ |
|---|---|---|---|---|---|
| 2 | Kimi K3 | 9,0 | $3.00/$15.00 | $0.219 | ● напрямую |
| 1 | GPT-5.6 Sol | 9,0 | $5.00/$30.00 | $0.190 | ● заблокирован |
| 4 | Claude Opus 4.6 | 8,8 | $5.00/$25.00 | $0.216 | ● заблокирован |
| 8 | MiniMax M3 | 8,4 | $0.30/$1.20 | $0.010 | ● напрямую |
| 9 | MiMo v2.5 Pro | 8,4 | $1.00/$3.00 | $0.027 | ● напрямую |
| 10 | Grok 4.5 | 8,4 | $2.00/$6.00 | $0.028 | ● заблокирован |
| 12 | Kimi K2.6 | 8,3 | $0.74/$3.49 | $0.036 | ● напрямую |
| 18 | Qwen 3.6 Plus | 7,9 | $0.33/$1.95 | $0.011 | ● напрямую |
| 21 | DeepSeek V4 Pro | 7,8 | $0.43/$0.87 | $0.005 | ● напрямую |
| 28 | DeepSeek V4 Flash | 7,5 | $0.09/$0.18 | $0.001 | ● напрямую |
| 32 | DeepSeek V4 Flash (Yandex Cloud) | 7,3 | $3.00/$5.00 | $0.023 | ● напрямую |
| 37 | GigaChat 3.5 Ultra | 6,9 | $1.07/$3.21 | $0.011 | ● напрямую |
| 43 | Alice AI LLM (v3) | 6,3 | $0.80/$0.80 | $0.002 | ● напрямую |
| 47 | GigaChat 2 Max | 4,2 | $7.22/$7.22 | $0.013 | ● напрямую |
| 30 | Gemini 3.1 Pro | 7,3 | $2.00/$12.00 | $0.027 | ● заблокирован |
Бесплатные уровни, которые таблица не показывает: безлимитный чат у Kimi, полный бесплатный доступ у Qwen и DeepSeek, веб-интерфейс у GigaChat, Алиса и Браузер у Alice AI, Grok – через подписку X Premium.
Стоимость теста – средняя стоимость одного сценария бенчмарка (системный промпт + задача + ответ модели, в среднем около 2 000 токенов на вход и 1 500 на выход). Подробная методология бенчмарка.
DeepSeek V4 Flash на Яндекс Облаке стоит в 23 раза дороже оригинала при чуть более низком качестве – цифры в колонке «Стоимость теста» выше. Платите за прямой доступ из РФ и SLA от Яндекса.
Какой инструмент выбрать: 7 сценариев
1. Универсальный ассистент для ежедневных задач
ChatGPT – самая широкая экосистема: генерация текста, изображения, анализ данных, работа с файлами, интеграции через GPT Store. С GPT-6 Astra ставка сместилась на управление компьютером: контекст 1M токенов с лишним, вход текстовый и картинкой, вывод только текстовый, звук модель не принимает. Anthropic предлагает более понятный выбор внутри линейки: Opus 5 за $5/$25 на большинство задач, Fable 5.1 за $10/$50 на трудные, и всегда включённое адаптивное мышление (adaptive thinking), которое больше не надо переключать вручную.
Продуктовая часть у Anthropic в сентябре интереснее модельной. Claude в Chrome вышел в общий доступ на всех платных тарифах, Cowork получил встроенный браузер, память стала сквозной между чатом и Cowork. Для корпоративного внедрения есть деталь, которую надо решить заранее: на тарифах Team и Enterprise память выключена по умолчанию.
2. Исследования и фактчекинг
Инструмент, который ищет информацию в интернете и показывает ссылки на источники. Режим Deep Research – для сложных вопросов.
3. Работа в экосистеме Google
Если ваша компания использует Google Workspace – Gemini интегрирован в Gmail, Docs, Sheets, Drive. 3.8 Flash добавили в приложение Gemini на тарифах Pro и Ultra, в AI Mode поиска и в Google Sheets. Контекстное окно в 2 млн токенов есть у Gemini 3.1 Pro – она и позволяет анализировать гигантские документы.
Два обстоятельства для плана закупок. Старшей модели у Google сейчас нет, и если задача требует максимума, выбрать нечего. Вводная цена 3.8 Flash действует до 31 декабря 2026 года, а обычный тариф не опубликован – закладывать в бюджет вводные $0,75 рискованно.
4. Российская специфика и законодательство
GigaChat 3.5 Ultra – лучшая российская модель по нашему июльскому бенчмарку, но с трудовым законодательством ни одна модель не справляется надёжно (включая западные). YandexGPT интегрирован с экосистемой Яндекса (360, Браузер, Алиса). Оба хранят данные в РФ. Альтернатива – DeepSeek V4 Flash на Яндекс Облаке: по июльскому прогону опережает Alice AI, хранение в РФ, но в 28–33 раза дороже оригинала.
За лето здесь изменилось две вещи. Сбер выпустил GigaChat 3.5 Ultra под MIT – 432B MoE на линейном внимании, почти вдвое компактнее предыдущего флагмана и до четырёх раз быстрее на длинных текстах; по нашим июльским замерам до лидеров ей далеко, но возможность запустить её у себя меняет расчёт. Яндекс перезапустил Алису на новой Alice AI LLM с закрытыми весами и обновил YandexGPT 5.1 Pro. По данным Яндекса, доля хороших ответов выросла с 60% до 71%, галлюцинации снизились вдвое, до 16%. Цена упала втрое – 40 копеек за 1 000 токенов. Вся линейка Alice AI – LLM, ART и VLM – с 16 июля сертифицирована по ISO/IEC 42001.
5. Минимальный бюджет
DeepSeek V4 Flash обходится в 130 раз дешевле Gemini 3.1 Pro при более высоком качестве. Qwen 3.7 Plus – «планирование почти бесплатно». Обе доступны из России, цены за тест – в живой таблице выше.
К ним добавились два релиза, которых в нашем бенчмарке нет. Qwen3.8-Flash-Next – открытый предпросмотр архитектуры Qwen4: 125B параметров, из них 6B активных на токен. Контекст 262K расширяется до 1M через YaRN, цена – около $0,16/$0,47. Слой n-gram-эмбеддингов на 51 млрд живёт в обычной оперативной памяти вместо видеопамяти. По данным Alibaba, он обходит DeepSeek-V4-Flash и Claude Opus 4.6 на большинстве проверенных задач. GLM-5.3-Flash при $0,15/$0,50 добавляет к этому мультимодальность и MIT.
С оговоркой про DeepSeek: рост цен, пиковые окна и подорожавший кеш означают, что «агрессивно дёшево» закончилось. Дёшево – осталось.
6. Конфиденциальность данных
Qwen, и теперь это ответ по существу.
Qwen3.8-27B – Apache 2.0, энкодер зрения, нативные изображение и видео, контекст 262K, около 17 ГБ в Q4_K_M. Одна потребительская видеокарта или 16-гигабайтный ноутбук через Ollama и llama.cpp. Ещё в июле на этом месте стояли открытые модели прошлого поколения – пригодные, но заведомо слабее облачных; сейчас это модель, которую можно спокойно дать команде.
Рядом два варианта крупнее. GLM-5.3-Flash под MIT, около 306 GiB в FP8, NVIDIA Hopper или новее – единственная мультимодальная модель такого уровня, которую можно законно развернуть на своём железе без условий в лицензии. GigaChat 3.5 Ultra под MIT, если важна российская юрисдикция разработки.
Qwen3.8-Max формально тоже обещан в открытых весах, но на практике это около 2,5 ТБ в FP8, дата-центр и лицензия с порогом по выручке. Для большинства компаний это не вариант самостоятельного хостинга.
7. Создание медиаконтента
ChatGPT плюс специализированные инструменты.
GPT-6 Astra сама звук не принимает и изображения не генерирует – генерация картинки у неё подключается как инструмент. За лето вокруг флагманов вырос отдельный слой: Gemini Omni Flash генерирует и монтирует видео от 360p до 4K, Lyria 3.5 пишет полноформатные треки, Gemini 3.5 Transcribe распознаёт речь более чем на 85 языках, разделяет говорящих и ставит точные метки слов, grok-imagine-video-1.5 выдаёт нативные 1080p.
Подробный обзор AI-инструментов для создания изображений, видео, музыки и презентаций – в отдельной статье серии.
Как объективно сравнить модели
Маркетинговые заявления – не лучший критерий для выбора. Используйте независимые бенчмарки:
- Бенчмарк mysummit.school – 47 моделей на реальных менеджерских задачах, две независимые модели-судьи
- Artificial Analysis – единая шкала интеллекта, смешанной цены и скорости вывода; помните про перемасштабирование между версиями индекса
- LMArena – анонимное слепое сравнение моделей живыми людьми; первые девять позиций перекрываются интервалами
- MERA – бенчмарк для русского языка
- SWE-bench – для оценки «агентских» способностей модели
А лучше всего – протестируйте 2–3 финалиста на своих реальных рабочих задачах.
Практический совет: стратегия «основной + резервный»
Не привязывайтесь к одному инструменту. Оптимальная стратегия:
- Основной инструмент – для 80% ежедневных задач (ChatGPT, Claude или Gemini). По бенчмарку: Claude Opus 4.6 или Grok 4.5, а из доступных в России напрямую – Kimi K3 и MiMo v2.5 Pro.
- Резервный – для случаев, когда основной не справился или недоступен. DeepSeek V4 Flash и Qwen 3.7 Plus – бесплатные и доступны из России.
- Специализированный – для конкретных задач: Perplexity для исследований, GigaChat 3.5 Ultra для хранения данных в РФ, Qwen для конфиденциальных данных на своём сервере.
Такой подход даёт запас прочности и позволяет использовать сильные стороны каждого инструмента.
Если переложить ту же логику на сентябрьскую линейку, получится: GPT-6 Astra или Claude Fable 5.1 как основной инструмент, Claude Opus 5 как рабочая модель вдвое дешевле, GLM-5.3-Flash или Qwen3.8-Flash-Next как резерв, который заодно снимает вопрос доступности из России. Gemini 3.8 Flash стоит держать отдельной строкой – для задач, где скорость ответа важнее последних трёх пунктов качества.
Таблица в начале этой статьи устарела за шесть недель, и следующая устареет примерно так же: Google обещает Gemini 3.5 Pro, xAI тренирует Grok 5, Z.ai держит веса GLM-5.3 на пост-релизовой проверке безопасности. Быстрее всего в таких таблицах меняются оценки. Колонка с лицензией меняется медленнее всего, и в сентябре 2026 года читать стоит сначала её: MIT у GLM-5.3-Flash и Apache 2.0 у Qwen3.8-27B переживут и следующий релиз, и очередной пересчёт шкалы.
Инструмент есть. Теперь – навык
Специализация по проектному управлению: 10 уроков, каждый из которых строит переиспользуемый шаблон для вашей ежедневной работы.

Все обзоры серии
- ChatGPT от OpenAI – универсальная экосистема и управление компьютером
- Claude от Anthropic – лучшее качество текста и безопасность
- Perplexity AI – поисковый движок нового поколения
- Gemini от Google – интеграция с Workspace и четыре Flash-релиза за 106 дней
- Grok от xAI – ИИ Илона Маска с интеграцией в X
- YandexGPT – российский ИИ с экосистемой Яндекса
- DeepSeek – китайская модель с агрессивными ценами
- GigaChat от Сбера – российский ИИ для бизнеса
- Qwen от Alibaba – ценовой пол и открытые веса
- Как оценивают качество LLM – бенчмарки для менеджера
- AI для создания медиаконтента – изображения, видео, музыка
- GLM-5 от Z.ai – китайская модель с открытыми весами и мультимодальностью
Stanislav Belyaev
Engineering Leader в Microsoft18 лет в управлении инженерными командами. Основатель mysummit.school. 700+ выпускников в Яндекс Практикуме и Стратоплане.