ИИ на рабочем месте: внедрение растёт, отдача застряла
AI-модели в этой статье
За год этот блог разобрал больше десятка крупных замеров использования ИИ на рабочем месте: Gallup, Stanford, Wharton, BCG, Workday, Epoch AI, Google, Microsoft. По отдельности каждый отчёт рассказывает свою историю – и у каждого мы эту историю проверяли. Собранные в одну ленту, они показывают то, чего не видно ни в одном из них: две кривые, которые год движутся в разных направлениях.
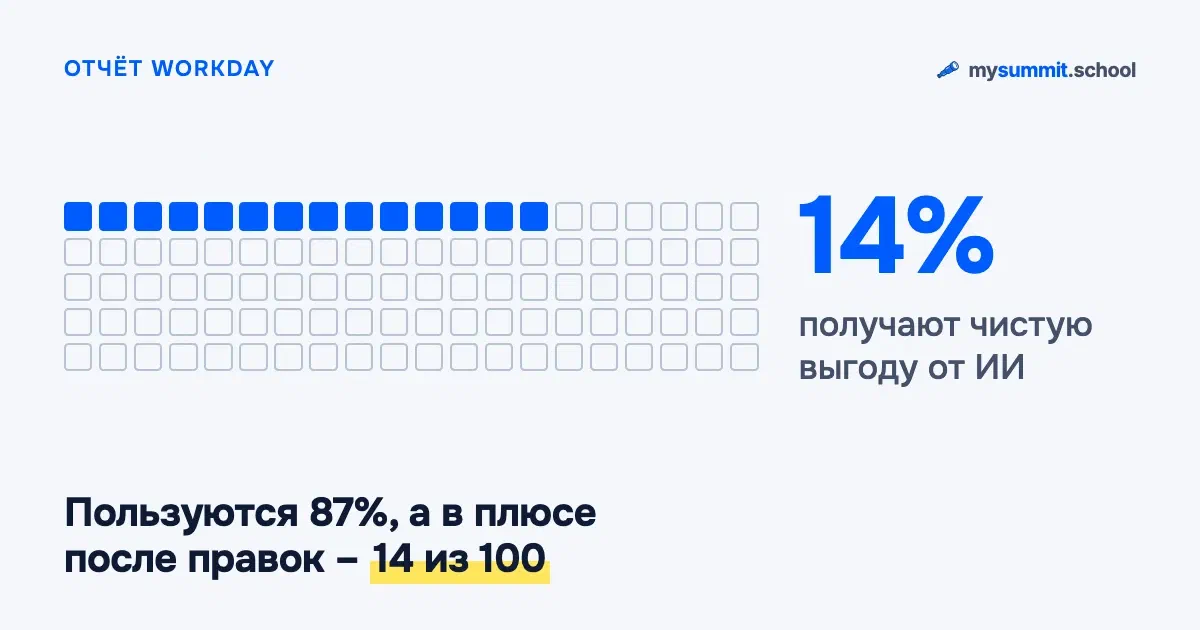
Первая кривая – внедрение. Она растёт линейно и предсказуемо: по квартальным замерам Gallup, ежедневных пользователей ИИ среди работающих американцев стало 15% против 8% годом раньше, а корпоративное внедрение по Stanford AI Index дошло до 88%. Вторая кривая – отдача. Она плоская: доля тех, кто получает от ИИ чистую выгоду за вычетом переделок, Workday оценивает в 14%, и за год наблюдений эта цифра никуда не сдвинулась.
Ниже – обе кривые по первоисточникам, которые мы отслеживали весь год, с оговорками о том, что с чем можно сравнивать. А за кривыми – четыре среза, которые видны только в сборе: смесь задач, доверие и ошибки, эффект для бизнеса и география.
Как мы считали
Сначала правила игры, потому что без них эта статья была бы манипуляцией.
Опросы в этой статье несопоставимы напрямую. Gallup опрашивает работающих взрослых в США, Stanford SWAA измеряет дни в неделю, AI Index собирает корпоративную отчётность, Workday, BCG и Wharton работают со своими панелями в других странах и с другими формулировками вопросов. Складывать их проценты в одну среднюю нельзя, и дальше я этого не делаю. Что можно сделать честно: посмотреть, куда движется каждый ряд сам по себе, и проверить, расходятся ли направления.
Единственный источник, где волны сравнимы между собой, – это квартальная серия Gallup Panel: один инструмент, одна методология, выборки больше 22 тысяч человек на волну. Поэтому каркас первой кривой построен на ней, а остальные источники работают как независимые подтверждения. Почти каждая цифра ниже ссылается на наш отдельный разбор, где есть методология и ограничения.
Кривая внедрения: скучный линейный рост
Вот серия Gallup целиком, с 2023 года. «Частые» – это те, кто использует ИИ несколько раз в неделю и чаще:
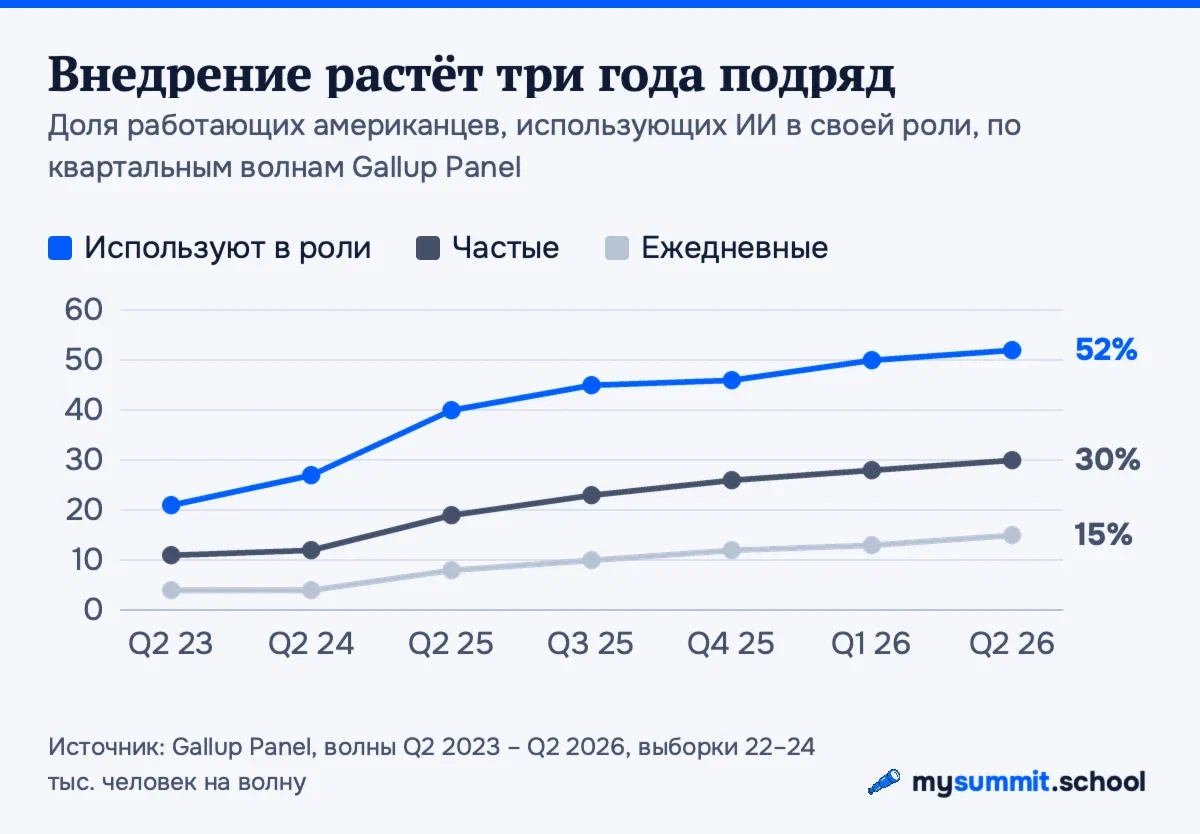
За год доля использующих выросла на 12 процентных пунктов, ежедневных пользователей стало почти вдвое больше. Никакого взрыва – плюс два-три пункта в квартал, волна за волной. Мы зафиксировали эту серию дважды: в декабрьском разборе стояли значения третьего квартала 2025, в августовском – второго квартала 2026.
Остальные источники меряют другое и другим способом, но направление у них то же. Stanford SWAA, ежемесячный опрос с более чем 200 тысячами наблюдений, насчитал рост рабочего использования с 0,4 дня в неделю в декабре 2024 до 0,5 дня в октябре 2025. Stanford AI Index зафиксировал подъём корпоративного внедрения с 78% до 88% за год. У BCG доля рядовых сотрудников, называющих себя регулярными пользователями ИИ, выросла на 23 процентных пункта за год – до 74%. Wharton в октябре 2025 насчитал 82% руководителей, работающих с ИИ еженедельно.
Повторю оговорку: эти пять рядов измеряют разные явления, и точные уровни между ними сравнивать нельзя. Показательно другое – за год ни один из них не показал плато или разворота. Вопрос «внедрять ли ИИ» на уровне статистики закрыт. Рынок ответил.
Кривая отдачи: плоская
Теперь вторая лента – замеры того, что люди и компании получают взамен.
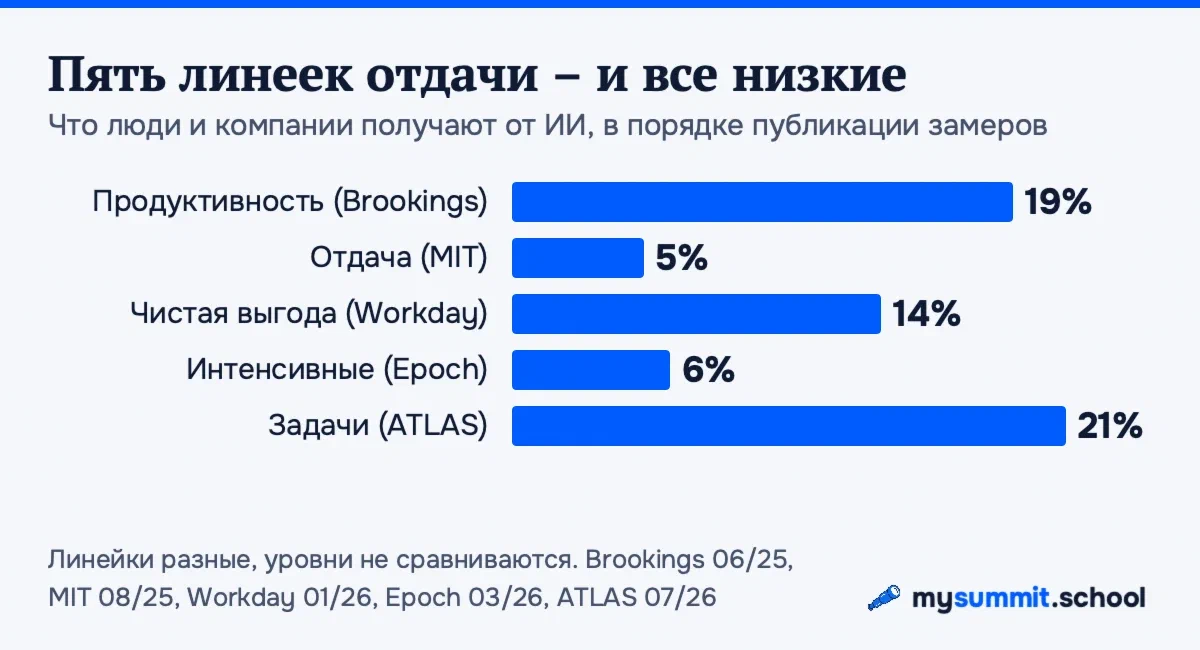
Первый сигнал прозвучал ещё в июне 2025: Brookings опросил 1 163 американца и выяснил, что при 57% использующих ИИ рост продуктивности видят только 19%. В августе 2025 MIT NANDA опубликовал разбор более трёхсот внедрений на фоне $30–40 млрд корпоративных инвестиций: измеримую отдачу получили 5% организаций, остальные 95% – ноль влияния на финансовый результат.
Дальше посыпались подтверждения с разных сторон. Workday с выборкой в 3 200 человек нашёл, что 87% сотрудников используют ИИ и 77% считают себя продуктивнее – но чистую выгоду после вычета времени на исправления получают только 14%. Почти 40% сэкономленного времени уходит на исправление ошибок самого ИИ (в точной формулировке отчёта – 37%). Epoch AI и Ipsos в марте 2026 показали, что 62% пользователей применяют ИИ к одной-двум задачам. Google в своём ATLAS разобрал 14,65 млн реальных диалогов с Gemini: ИИ присутствует в профессиях, где занято 88% работников США, но медианная профессия подключает его к 21% задач.
И наконец, восьмимесячное наблюдение за ~200 сотрудниками технологической компании, опубликованное в HBR, добавило механизм: сэкономленное время не высвобождается, а возвращается в виде большего объёма задач, меньшего числа пауз и работы, размазанной на вечера.
Оговорка та же, но здесь она важнее. Эти исследования меряют разное: самооценки, телеметрию диалогов, вскрытия проектов. Усреднять их нельзя. А вот что заметить стоит: за год ни один измерительный инструмент не зафиксировал, что отдача растёт вслед за внедрением. Кривая внедрения за год прошла от 40% до 52%. Кривая отдачи за тот же год – от 19% у Brookings до 14% у Workday, с поправкой на то, что это разные линейки.
Читатель, который дошёл досюда, уже видит обе кривые в чужих отчётах. Сложнее увидеть их в собственной команде: там нет Gallup, зато есть список сценариев, часы на проверку и освободившееся время, которое куда-то девается.
Первый замер на стороне отдачи
До этого лета замеры на стороне отдачи сходились на одном – «мало», «плоско», «не работает», но без ранжирования. В июльском отчёте Gallup впервые появилась таблица, которая раскладывает отдачу по сценариям. Мы разобрали её в отдельной статье, здесь – суть.
Среди пользователей ИИ прирост продуктивности чаще всего отмечают те, кто применяет его для помощи в кодинге и автоматизации процессов – по 77%. Дальше презентации (76%) и аналитика (75%). Самые массовые сценарии – написание текстов и поиск – замыкают таблицу с 68% и 65%. Есть и градация по широте: у тех, кто использует ИИ для одной-двух задач, прирост отмечают 45%, у работающих с семью и более сценариями – 90%.
К этим цифрам три оговорки, и Gallup осознанно делает их сам. Продуктивность здесь – самооценки, объективного замера в опросе не было. Связь широты с отдачей – корреляция: возможно, люди, которым ИИ подходит, просто находят ему больше применений. Выборка – только США. При всём этом содержательный сдвиг состоялся: вопрос «даёт ли ИИ отдачу вообще» сменился вопросом «какие сценарии её дают». А это уже управленческая постановка.
Почему кривые расходятся
Три механизма, которые повторяются в источниках независимо друг от друга.
Первый – автоматизируется только записанное. В ATLAS профессии с зарегламентированной работой подключают ИИ заметно глубже: в структурированной умственной работе на автоматизацию приходится больше четверти диалогов, в неструктурированной – меньше 10%. Массовые сценарии вроде текстов и поиска как раз относятся к работе, где процедура не записана, – и потолок у них низкий по конструкции.
Второй – налог на проверку. Workday измерил его в 37% сэкономленного времени. Dejan.AI и Anthropic ещё в декабре описали то же явление через метафору стажёра, чью работу проверяешь дольше, чем делал бы сам. Чем дальше сценарий от «напиши черновик», тем выше требования к проверке результата – и тем чаще команда обнаруживает, что навыка проверять у неё нет.
Третий – у сэкономленного времени нет адреса. BCG зафиксировала: 66% рядовых сотрудников не получают никаких указаний, куда направить освободившиеся часы, и больше половины признаются, что не вкладывают их в более важную работу. HBR показал, что происходит вместо этого: объём задач растёт до размеров освободившегося времени. Экономия без назначения превращается в интенсификацию.
Общий знаменатель у всех трёх – управление. Microsoft в Work Trend Index 2026 посчитал, что организационные факторы определяют 67% эффекта от ИИ – вдвое больше, чем личные навыки сотрудников. Выбор сценариев, стандарт проверки, судьба сэкономленных часов – всё это решения, которые принимает руководитель, а не модель.
Смесь задач меняется медленнее привычки
Кривая внедрения растёт, но растёт в основном в одних и тех же сценариях. В свежей волне Gallup верхние строки те же, что год назад: тексты (51% пользователей ИИ), поиск (49%), общая помощь (39%). Специализированные сценарии – аналитика, кодинг, автоматизация, управление проектами – сидят в диапазоне 16–18%. Разрыв между частыми и редкими пользователями концентрируется именно в них: в кодинге и автоматизации частые впереди почти втрое, в текстах – в полтора раза. Кто работает с инструментом каждый день, тот уходит в специализированные сценарии; кто заходит раз в неделю, остаётся на текстах.
Телеметрия и интервью эту картину подтверждают. Microsoft опросила 885 продакт-менеджеров и сверила ответы с телеметрией M365 (весна 2025): черновики документов используют 73%, саммари – 52%, анализ данных – 22%, прототипирование и код – 12%. Делегируют ИИ задачи с низкой ответственностью и вне профессиональной идентичности; спецификации и решения оставляют себе. Google в ATLAS разложил 14,65 млн диалогов: работа – лишь 14% всего трафика Gemini, а полная автоматизация задачи – меньше 10% диалогов даже внутри рабочего трафика. У Dejan.AI и Anthropic, проведших 1 250 глубинных интервью в декабре 2025, главный сценарий во всех группах – «старт с нуля»: первый черновик, который человек доводит сам. Креативщики проводят границу прямо: 90% отдают ИИ административную работу и не отдают ядро ремесла.
Единственное движение за год заметно в режиме делегирования. По данным Anthropic Economic Index, которые приводит AI Index, доля автоматизации в диалогах выросла с 41% в начале 2025 до 49% в августе – впервые выше доли совместной работы, – а к ноябрю совместная работа вернула себе 52%. Это колебание: люди пробуют отдавать задачи целиком и возвращаются к работе в паре. Смесь задач за год почти не сдвинулась. Это третья кривая, и она ещё более плоская, чем отдача.
Доверие не поспевает за использованием
Вторая вещь, которая за год не выросла, – доверие к результату. Workday насчитал, что 37% времени, сэкономленного с ИИ, уходит на исправление его ошибок, – у активного пользователя это полторы недели в год. В интервью Dejan.AI и Anthropic галлюцинации называют барьером номер один во всех группах респондентов, а у учёных проверка ответа иногда длится дольше, чем заняла бы сама работа. У Microsoft 47% продактов ставят главным барьером качество выдачи, и 56% говорят, что усилий меньше не стало, хотя время экономится. BCG добавляет с другой стороны: у 60% сотрудников выросла планка приемлемой работы, и половина тратит на проверку результата больше времени, чем раньше.
Объективный фон тоже не улучшается. Задокументированных ИИ-инцидентов в 2025 году стало 362 против 233 годом раньше – плюс 55%, по подсчёту AI Index.
При этом вера в технологию распределена странно. Позитивного влияния ИИ на работу ждут 73% экспертов и 23% публики. Доверие к государству как регулятору ИИ колеблется от 81% в Сингапуре до 31% в США – это минимум по опросу Ipsos. Люди массово пользуются инструментом, которому не вполне доверяют, и это нормальная картина для ранней технологии. Побочный эффект понятен менеджеру: доверие здесь зарабатывается проверкой, а проверка стоит времени, – пока команда не научилась проверять, она либо переплачивает за контроль, либо пропускает ошибки.
Что получил бизнес
На уровне компаний за год случилось то, чего не видно в индивидуальной статистике: организации начали двигаться.
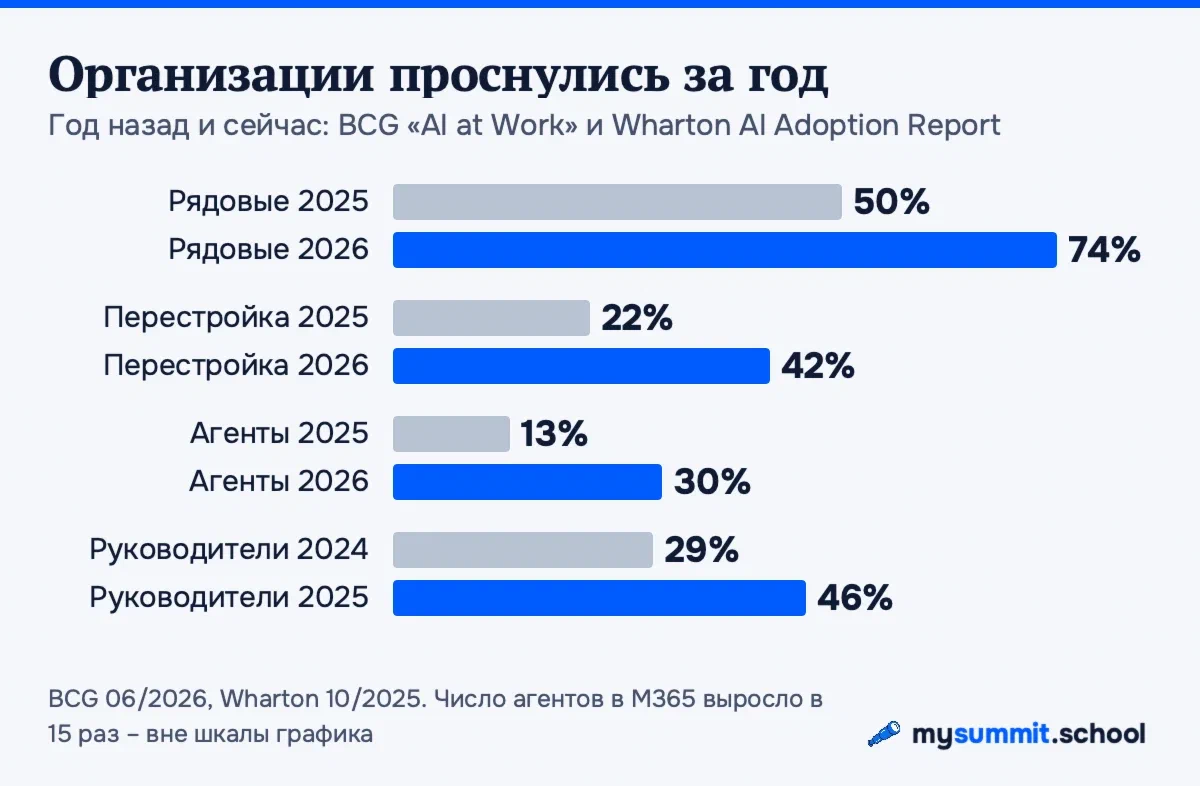
BCG в четвёртой годовой волне фиксирует три сдвига сразу: регулярных пользователей среди рядовых сотрудников стало 74% против примерно 50% годом раньше, компаний, перестраивающих процессы целиком, – 42% против 22%, организаций с агентами в процессах – 30% против 13%. Wharton насчитал 46% руководителей с ежедневным использованием против 29% годом раньше. Телеметрия Microsoft добавляет самый резкий ряд: число активных агентов в Microsoft 365 выросло за год в 15 раз.
Отдача при этом распределена крайне неравномерно. Wharton отчитывается о положительном ROI у трёх четвёртей enterprise-компаний, а MIT NANDA – о нулевой отдаче у 95% организаций на фоне $30–40 млрд инвестиций. Противоречие снимается выборками: Wharton опрашивает крупнейшие компании, где уже есть и главы по ИИ, и привычка измерять ROI, а MIT меряет рынок целиком. У тех, кто вошёл в пять процентов, эффекты конкретные: квалификация лидов быстрее на 40%, удержание клиентов выше на 10%, сокращения только в поддержке и административной обработке – 5–20% позиций. AI Index добавляет секторные оценки продуктивности – плюс 14–15% в поддержке клиентов, плюс 26% в разработке – и тёмную сторону: занятость разработчиков 22–25 лет в США упала почти на 20% с 2022 года. Потребительский излишек от ИИ за год вырос со $112 до $172 млрд.
Картина внятная: деньги и эффект концентрируются у тех, кто перестраивает процессы; покупка лицензий сама по себе их не даёт. На уровне команды это то же наблюдение, что и у Gallup, только с другим знаменателем.
География внедрения
Самый неожиданный срез года – страновой.
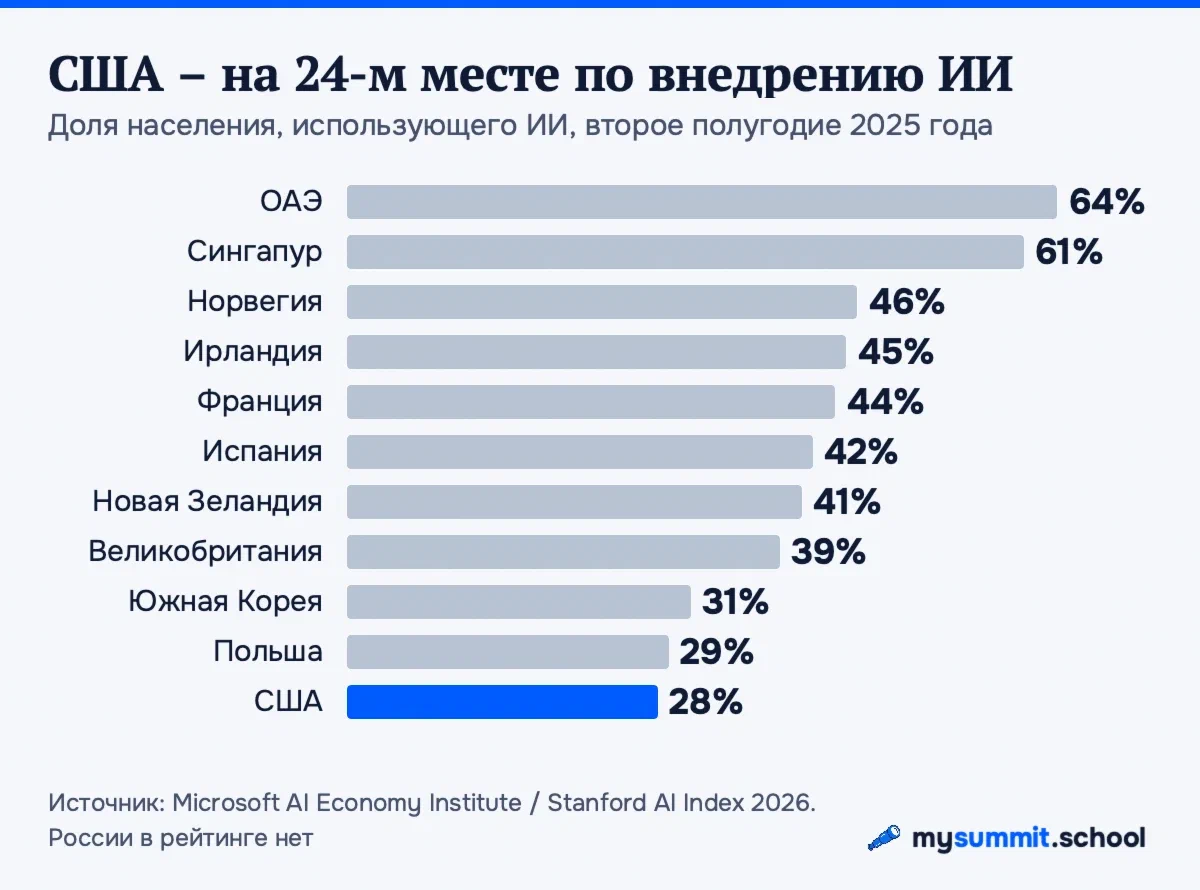
По данным Microsoft AI Economy Institute, которые приводит AI Index, лидируют ОАЭ (64% населения используют ИИ) и Сингапур (61%). США – 28,3% и 24-е место, между Польшей и Чехией. Быстрее всех за полгода росла Южная Корея – плюс 4,8 процентного пункта.
Телеметрия ATLAS добавляет два контрастных факта. Первый: Индия и Россия, несмотря на статус технологических держав, попадают в нижний квинтиль по использованию на душу населения. Второй: рабочая доля диалогов максимальна в развивающихся странах – в Нигерии 91% использования среди пользователей приходится на работу, в ОАЭ 83%, в Индии 80%, – а США и Европа сидят в нижних квинтилях. Там, где ИИ достался недавно, его используют прежде всего для работы; там, где он давно, – прежде всего для жизни.
Для читателя из России здесь слепая зона. В рейтинге AI Index России нет вовсе, Gallup и SWAA опрашивают только США, а ATLAS даёт лишь квинтиль. Собственного замера уровня Gallup за год не появилось – отдельный вывод сам по себе: все эти данные мы читаем с поправкой на чужой рынок.
Что с этим делать
Вопрос «внедрять ли ИИ» больше не стоит – статистика закрыла его. Открытый вопрос другой: где в вашей команде отдача, а где движение ради движения. Три действия под него.
Первое – провести ревизию сценариев. Выпишите, для чего команда реально использует ИИ, и разложите по таблице отдачи Gallup. Промпт ниже делает это за вас: в него уже вложены таблица и пример списка сценариев проектного офиса, запустить можно как есть, потом подставить свои пункты.
Вы
Ты – консультант по внедрению ИИ. Ниже – список сценариев, для которых команда использует ИИ, и таблица отдачи по сценариям из опроса Gallup (Q2 2026, самооценки работников США): помощь в кодинге – 77% пользователей сценария отмечают прирост продуктивности; автоматизация процессов – 77%; презентации – 76%; аналитика – 75%; помощь на встречах – 73%; управление знаниями – 72%; почта и коммуникации – 72%; управление задачами – 72%; генерация изображений – 70%; общая помощь – 70%; написание текстов – 68%; поиск – 65%.

Сделай три вещи:
1. Классифицируй каждый сценарий из моего списка: высокая отдача (75% и выше), средняя (70–74%), базовая (ниже 70%). Если сценарий не попадает в таблицу напрямую, отнеси его к ближайшему по типу работы и скажи об этом отдельно.
2. Для каждого сценария оцени цену проверки: сколько внимания требует результат, прежде чем ему можно доверять (низкая / средняя / высокая), и почему.
3. Выбери один сценарий-кандидат на перестройку: какую задачу из списка стоит перевести из постановки «составь текст» в постановку «разбери сырьё и предложи решение». Напиши готовую формулировку такой задачи для модели.

Сценарии команды (проектный офис, 6 человек):
1. Черновики писем заказчику и рассылок по проекту.
2. Саммари протоколов еженедельных статус-созвонов.
3. Поиск ответов по внутренней базе знаний (регламенты, шаблоны).
4. Подготовка слайдов для квартального отчёта руководству.
5. Разбор метрик спринта: скорость, сгорание, отклонения от плана.
6. Автоматическая сводка статусов трёх команд в один отчёт для директора.

Формат ответа: таблица по пунктам 1 и 2, затем пункт 3 текстом с готовой формулировкой задачи.
Модели подобраны по нашему бенчмарку. GPT-5.6 Sol лидирует в общем зачёте, для доступа из России понадобится обходной путь. Kimi K3 доступна из России напрямую и по профилю подходит этой задаче: её сильная сторона – анализ и решения, она переформулирует проблему и выдаёт структурированные таблицы.
Я прогнал промпт на обеих моделях по три раза. С классами отдачи они справились ожидаемо: сводка статусов, разбор метрик и слайды ушли в высокую, письма и саммари – в среднюю. С поиском по базе знаний вышло интереснее: GPT-5.6 Sol во всех прогонах отнёс его к базовой, а Kimi K3 – к средней, но каждый раз с оговоркой, что сценарий сидит на стыке «управления знаниями» и «поиска», и показывала обе трактовки. Дальше – два расхождения. Первое: цена проверки не совпала с уровнем отдачи. Поиск по базе при нижней строке таблицы отдачи получил высокую цену проверки почти во всех прогонах обеих моделей: ответ выглядит уверенно, а ошибку – устаревшая версия регламента, смесь двух документов – видно только в первоисточнике, то есть проверка равна повторному поиску.
Второе расхождение – кандидаты на перестройку. Kimi K3 чаще выбирала сводку статусов (аргумент – риск тихо потерянного блокера при сжатии), GPT-5.6 Sol – слайды квартального отчёта. Это нормальный результат: «куда расти» зависит от того, где у команды боль, и однозначного ответа у таблицы Gallup здесь нет.
На что смотреть в ответе: прежде всего на обоснование цены проверки – она съедает экономию. Показательная закономерность прогонов: самую высокую цену проверки обе модели ставили как раз трём сценариям с верхней строкой отдачи – сводке, метрикам и слайдам. Kimi K3 сформулировала вывод прямо: проценты Gallup – это самооценка прироста до вычета проверки, поэтому чистый выигрыш определяется дизайном процесса. Подставляя свои сценарии, читайте эти обоснования, а не только оценки.
Второе действие – назначить цену проверке. Заведите счётчик часов, которые команда тратит на вычитку и исправление результатов ИИ, и сравните с часами экономии. Если переделка растёт быстрее экономии, вы двигаетесь по сценариям быстрее, чем позволяет ваша планка качества. Это тот самый налог в 37% от Workday, только посчитанный на ваших данных.
Третье – дать сэкономленному времени адрес. До того как команда освободит часы, решите, на что они пойдут. По BCG, без такого решения время растворяется у двух третей сотрудников. Промпт ниже – заготовка для этого разговора с самим собой: в него вложены типовые цифры (8 сэкономленных часов в неделю на команду из шести) и две квартальные цели, подставьте свои.
Вы
Ты – операционный консультант. Команда из 6 человек экономит с помощью ИИ около 8 часов в неделю суммарно (саммари встреч, черновики документов, сводка статусов). Исследования показывают, что без явного решения такое время растворяется в том же объёме рутины.

Предложи три варианта, куда перенаправить эти 8 часов, исходя из двух квартальных целей: сокращение срока онбординга клиентов с 6 до 4 недель и запуск двух пилотов вместо одного.

Для каждого варианта укажи: что конкретно команда делает в эти часы, какой артефакт появляется к концу месяца, и как руководитель измерит, что время не растворилось. В конце отметь, какой из трёх вариантов ты считаешь слабым звеном и почему.
GPT-5.6 Sol во всех прогонах назвал слабым звеном вариант «поделить часы пополам между двумя целями»: восемь часов в неделю – это пятая часть ставки, и дробление опускает каждый трек ниже критической массы. Kimi K3 в каждом прогоне собирала свой набор вариантов, но там, где среди них оказалось деление 4+4, отвергла именно его с той же логикой и добавила формулировку, которую стоит забрать себе: время, которое «всем понемногу», растворяется первым. Полезная деталь в ответах обеих моделей – требование оформить сэкономленные часы как защищённые блоки в календаре с владельцем: если блока нет, время уже растворилось.
Что покажет следующий год замеров
Год наблюдений за этими отчётами оставляет простую картину. Кривая внедрения движется сама – лицензии куплены, привычка сформирована, плюс два-три пункта в квартал не требуют от компаний никаких решений. Кривая отдачи сама не движется: она сдвинулась ровно один раз, когда Gallup впервые измерил, какие сценарии окупаются, – и выяснилось, что массовые окупаются хуже всех.
Открытый вопрос следующего года звучит так: останется ли отдача плоской линией, когда измерять её научатся так же регулярно, как измеряют внедрение. Ответ зависит от того, сколько команд перестанут считать процент освоения и начнут считать сценарии, часы проверки и адрес сэкономленного времени. Ваш процент в этой статистике вы выбираете сами.
Читайте также
Замеры в статье: Gallup Panel, волны Q2 2023 – Q2 2026, выборки 22–24 тыс. работающих взрослых США на волну, погрешность ±0,9–1,0 п.п.; Stanford SWAA, более 200 тыс. наблюдений, последняя волна – октябрь 2025; Stanford AI Index 2026 (данные за 2025), включая Anthropic Economic Index, Microsoft AI Economy Institute и опрос Ipsos; BCG «AI at Work», 11 749 респондентов на 14 рынках, июнь 2026; Wharton-GBK, октябрь 2025; Brookings, 1 163 респондента, июнь 2025; MIT NANDA, 300+ внедрений, 2025; Workday, 3 200 респондентов; Epoch AI / Ipsos, март 2026; Google ATLAS, 14,65 млн диалогов, июль 2026; HBR, 8-месячное наблюдение за ~200 сотрудниками, февраль 2026; Microsoft Research, опрос 885 продакт-менеджеров с телеметрией M365, весна 2025; Dejan.AI / Anthropic Interviewer, 1 250 интервью, декабрь 2025; Microsoft Work Trend Index, 20 000 респондентов в 10 странах, май 2026. Методологии различаются – уровни между исследованиями напрямую не сравниваются.
Частые вопросы
Насколько выросло использование ИИ на рабочем месте за год?
Почему внедрение ИИ не даёт роста продуктивности?
Какие сценарии использования ИИ дают наибольшую отдачу?
Как менеджеру измерить отдачу от ИИ в своей команде?

18 лет в управлении инженерными командами. Основатель mysummit.school. 700+ выпускников в Яндекс Практикуме и Стратоплане.