ИИ как экзоскелет: сотрудник справился, но не научился
AI-модели в этой статье
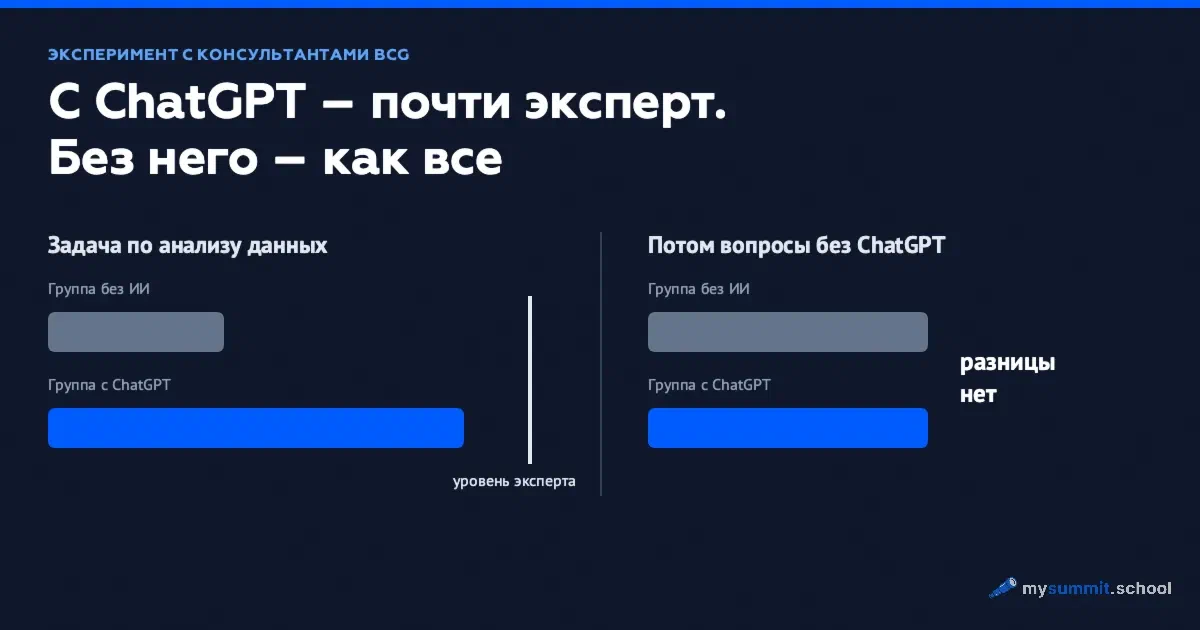
Консультант BCG, которому по работе не нужно писать код, за 90 минут с ChatGPT решает задачу на Python почти на уровне штатного дата-сайентиста. Сразу после этого, уже без ChatGPT, он отвечает на вопросы по той же теме не лучше коллеги, который весь эксперимент искал ответы на Stack Overflow. Задача решена, навык не появился.
Это результат эксперимента с 487 консультантами BCG, опубликованного в журнале Nature Human Behaviour: «Generative AI and the temporary upskilling of knowledge workers» (онлайн 26 октября 2026 года, DOI 10.1038/s41562-026-02566-6, статья прошла рецензирование; полный текст препринта в PDF). Авторы – экономист Эмма Уайлс из Бостонского университета, Лиза Крайер и коллеги из BCG Henderson Institute и Памела Мишкин из исследовательской команды OpenAI по экономическим эффектам. Исследование – рандомизированный эксперимент с заранее зарегистрированным планом анализа. Уайлс мы уже цитировали в разборе о ИИ-агенте в оргсхеме: там она изучала, как ярлык «ИИ-сотрудник» меняет готовность менеджеров перепроверять работу.
Для руководителя здесь важен вопрос, который задают на каждом втором планировании: «А давайте аналитику сделает сам продакт, у него же есть ChatGPT». По этим данным сделать он, скорее всего, сможет. Научиться при этом – вряд ли. А после удачной работы с моделью он, судя по тем же данным, начнёт больше доверять ей там, где доверять не стоит. Ниже – что именно измерили, где исследование слабее и готовый промпт, который проверяет, понимает ли сотрудник скрипт, собранный с ChatGPT.
Как устроен эксперимент
В марте–апреле 2024 года BCG пригласила своих консультантов поучаствовать в исследовании о переобучении и генеративном ИИ. В анализ вошли 487 человек – те, кто сдал обе задачи. Всего под рандомизацию попали 986 зарегистрировавшихся консультантов, начали эксперимент 573. Все с высшим образованием, Excel и инструменты вроде Alteryx знают по работе, но больше 60% никогда не программировали или знают только основы. Писать код консультант BCG по должности не обязан: для этого в проект ставят дата-сайентиста.
Сразу поправка на возраст данных. Эксперимент прошёл два с половиной года назад, участники работали с GPT-4 весны 2024 года. Сегодняшние модели заметно сильнее, поэтому круг задач вне своей специальности, с которыми сотрудник справится вместе с ИИ, сейчас шире, чем в эксперименте. Вопрос, который проверяли авторы, от этого не исчезает: остаётся ли у человека навык, когда инструмент убрали.
Половина получила доступ к GPT-4 и обучение на 15–20 минут: видео и практика по промптам для технических задач. Другая половина получила такое же по длине обучение работе с Google, Stack Overflow и Khan Academy – обычными источниками, которыми пользуются сами дата-сайентисты. Дальше каждому случайно доставались две задачи из трёх, по 90 минут на каждую:
- код: на Python очистить, объединить и отфильтровать две таблицы заказов и найти пять клиентов с самым высоким средним чеком;
- статистика: разобрать варианты советов ИИ при построении модели, которая предсказывает, возьмёт ли пара ипотеку, найти причину плохого качества модели, посчитать вероятности;
- прогноз: построить модель на истории международных футбольных матчей для инвестиционной стратегии и оценить, насколько ей можно доверять.
Задачи составили дата-сайентисты BCG вместе с командой OpenAI так, чтобы ChatGPT был полезным помощником, но сам их не решал: если отдать модели задачу целиком, ответ получался неверным. Эталон – 44 дата-сайентиста BCG, которые сделали те же задачи без ИИ. Их средний результат принят за ноль, всё остальное считается как отставание от него.
С ChatGPT – почти дата-сайентист
Группа с ChatGPT выиграла у контрольной во всех трёх задачах. В коде – на 49 процентных пунктов: контрольная группа в среднем отставала от дата-сайентистов на 63 пункта, группа с ChatGPT – на 14. Из контрольной группы задачу на 100% не решил никто, из группы с ChatGPT – пять человек. В статистике разница 20 пунктов (отставание от эталона 12 пунктов против 32), в прогнозе – 17.
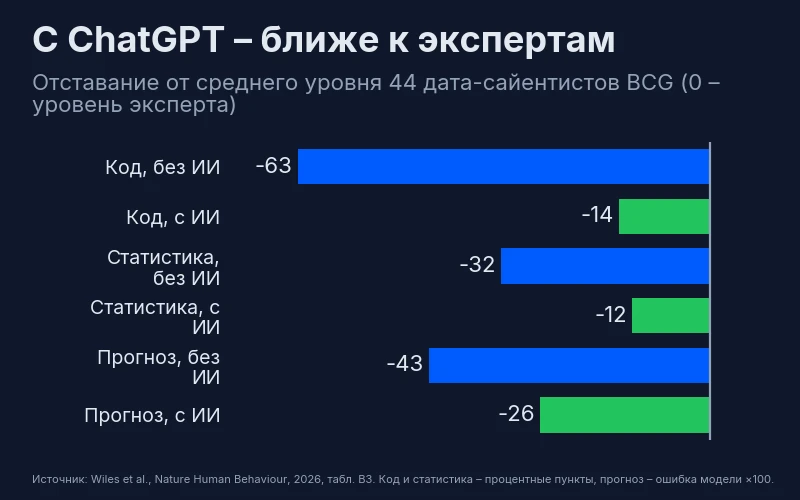
Сильнее всего выглядит результат тех, кто ещё до эксперимента оценивал себя как уверенного программиста. С ChatGPT они отставали от дата-сайентистов на 5 пунктов в коде и на 5 в статистике, и статистически эта разница от нуля не отличается. Консультант, который умеет программировать, плюс 15–20 минут обучения и GPT-4 – и на двух типах задач из трёх его результат не отличить от штатного специалиста.
На третьем типе так не получилось. В задаче на прогнозную модель даже опытные в коде участники с ChatGPT остались на 20 пунктов позади. Работающего кода здесь мало: нужно решить, какую модель строить и насколько ей можно верить. ChatGPT помог и здесь (группа с ИИ набрала в среднем −0,26 против −0,43 у контрольной, где 0 – уровень дата-сайентистов), но ни одна группа участников в среднем до этого уровня не дотянула.
Свободные ответы в задачах проверял GPT-4 Turbo по рубрике, и эту автоматическую проверку, по словам авторов, сверял дата-сайентист. Оценка частично машинная. Для сравнения двух групп, которых проверяли одинаково, это не критично, но абсолютные цифры я бы читал с этой поправкой.
Снимите экзоскелет
После задач всем участникам дали пять вопросов по тем же темам и попросили отвечать без ChatGPT. Как отфильтровать строки в Python, какова вероятность трижды подряд выбросить орла, влияет ли масштаб признаков на алгоритмы, основанные на расстоянии, как обрабатывать пропуски в категориальных признаках, к какому типу относится задача прогнозирования.
Попробуйте сами ответить на второй и третий вопросы, не открывая ChatGPT. Ответы – в конце раздела.
Разницы между группами нет. По отдельным вопросам она колеблется от −7,7 до +4,8 процентных пункта, совместный тест по всем пяти вопросам даёт p = 0,53. Авторы дополнительно посчитали байесовские факторы, и они умеренно поддерживают вывод «разницы нет». Группа, которая в коде только что отставала от экспертов на 14 пунктов, без ChatGPT знает предмет так же, как группа, отстававшая на 63.
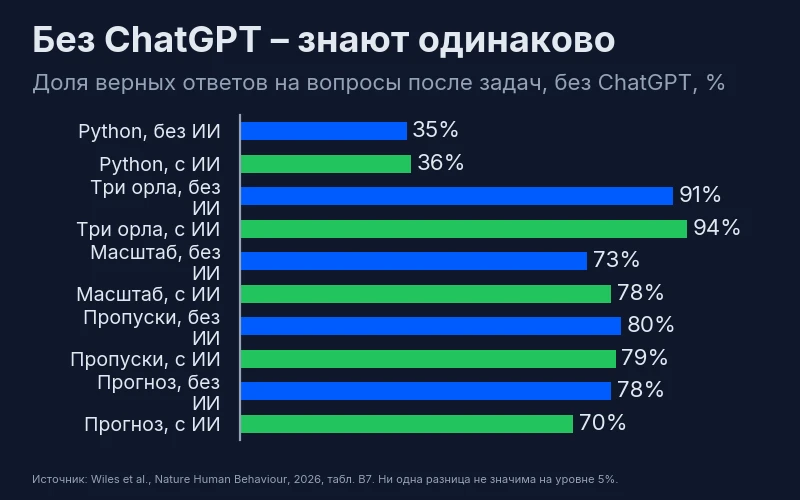
Авторы называют это экзоскелетом: пока конструкция надета, человек поднимает больше, чем позволяют его мышцы, но мышцы от этого не растут.
Вывода «ChatGPT мешает учиться» отсюда сделать нельзя. Знания до эксперимента не замеряли, поэтому сравнить можно только две группы между собой, и после задач они знали одинаково. Видно, что резкий скачок в результате работы не сопровождался скачком в знаниях. Для руководителя это два разных показателя, и первый ничего не говорит о втором.
Похожий разрыв недавно измерили на 26 811 китайских школьниках: оценки за домашку с ИИ выросли на 18%, а закрытые экзамены упали на 20%. Там – 30 месяцев наблюдения и подростки, здесь – одна сессия и консультанты с дипломами. Направление одно: результат, сделанный с ИИ, перестаёт быть сигналом о том, что человек умеет.
Если в вашей команде кто-то за месяц «научился аналитике» через ChatGPT, у вас пока нет способа отличить одно от другого. Отчёты стали лучше, сроки короче – это видно. Понимает ли человек, почему в его таблице именно эти пять клиентов, не видно, пока не спросишь без инструмента. Различать эти два случая – отдельный навык руководителя, и тренировать его проще на собственных задачах, чем на чужих примерах.
Ответы на вопросы из начала раздела: вероятность трижды подряд выбросить орла – 1/8. Масштаб на алгоритмы, основанные на расстоянии, влияет: признак с большими значениями перевешивает в расстоянии остальные, поэтому признаки сначала приводят к одному масштабу.
Проверьте, где ИИ решает задачу за вас, а где вы понимаете ответ сами: 9 реальных задач менеджера в открытом модуле – бесплатно.
Доступ сразу после регистрации
Работа с ChatGPT ухудшила оценку ChatGPT
Третий результат авторы не планировали заранее и честно называют поисковым. Но для руководителя он, пожалуй, самый неприятный.
До и после эксперимента участникам показывали короткие задачи и спрашивали, с какой вероятностью GPT-4 решит каждую правильно. Часть задач модель решала: нарисовать на HTML-странице вращающийся флаг, помочь с кроссвордом. Часть – нет: выбрать из таблицы города с чётным населением, поделить счёт на 10 долларов по позициям с разными ценами, нарисовать слово «hello» символами # и _, найти лучший ход в крестиках-ноликах.
Оптимистами были все и с самого начала: средняя уверенность в успехе модели держалась на уровне 65–78%, а 80% участников ещё до эксперимента считали, что GPT-4 решит хотя бы три из пяти задач, которые она не решала. До эксперимента группы не отличались. После него участники из группы с ChatGPT стали заметно увереннее, что модель справится, на всех четырёх задачах, которые она решить не могла. Из трёх задач, которые модель решала, на двух разницы между группами не было, а на кроссворде группа с ChatGPT тоже стала увереннее. Сильнее всего уверенность выросла там, где модель ошибается.
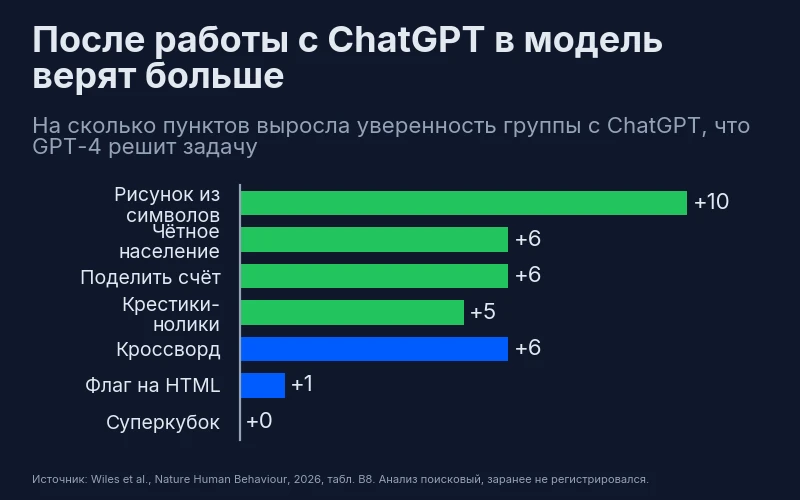
Три часа удачной работы с моделью сделали людей хуже в предсказании того, где она ошибётся. Удачный опыт переносится на задачи другого типа. Тот же механизм мы разбирали в статье о зубчатом крае ИИ: модель берёт олимпиадные задачи и путается в аналоговых часах, и по сильной стороне слабую не угадать.
Есть и утешительная деталь. У тех, кто ещё до эксперимента сильно переоценивал модель, выигрыш от ChatGPT в задачах оказался лишь немного меньше, чем у остальных, и всё равно большим. В этом эксперименте задачи были учебные и ничего не стоили. Авторы прямо пишут, что там, где ошибка дорого обходится, работу сотрудников с ИИ за пределами их компетенции нужно проверять отдельно.
Что из этого следует для руководителя
Авторы исследования дают одну организационную рекомендацию: если нетехнические сотрудники берут технические задачи с ИИ, в команде должен быть человек с глубоким пониманием предмета, который их работу проверяет. Остальное я вывел сам, опираясь на их данные и на работы, на которые они ссылаются.
Делить задачи на рабочие и учебные
Задача, которую нужно сделать к пятнице, и задача, на которой человек должен вырасти, требуют разных правил. В первой ИИ используется как угодно, оценивается результат. Во второй – первая попытка без инструмента, потом сравнение с ответом модели, и проверка через неделю-две снова без ИИ. Если этого разделения нет, команда по умолчанию делает все задачи как рабочие, и через полгода у вас много сделанного и мало выученного.
Повторение с усложнением
Авторы ссылаются на исследования, по которым прочный навык дают практика и повторение. Разовая интенсивная работа даёт быстрый прирост, который без закрепления уходит. В эксперименте была как раз одна интенсивная сессия. Для плана развития это значит: одна задача с ChatGPT «на вырост» почти ничего не даёт. Нужна серия однотипных задач, где каждую следующую человек делает с меньшей подсказкой, и где-то в середине – попытка совсем без неё. Как это устроить на практике, мы разбирали в статье о симуляциях вместо обучения по наблюдению.
Учить пределам модели отдельно
Сам по себе опыт работы с ИИ пределам не учит, судя по этим данным, – скорее наоборот. Значит, задачи, на которых модель ошибается, нужно показывать специально: собрать из своей практики несколько случаев, где ответ выглядел правильным и был неверным, и разбирать их так же, как разбирают инциденты. Как такие ошибки выглядят в отчётах, есть в разборе уверенного, правдоподобного и неправильного отчёта ИИ.
Специалиста, который проверяет, убирать рано
Продакт, который с ChatGPT собрал скрипт для выгрузки, на одном классе задач действительно может выдавать результат специалиста. На задачах, где нужно выбрать подход и оценить надёжность, по этим данным, не может. Для штатного расписания вывод простой: расширять круг задач сотрудника с помощью ИИ можно, убирать из процесса специалиста, который этот результат проверяет, – рано.
Попробуйте: проверка понимания вместо проверки результата
Ниже – ситуация, похожая на задачу из эксперимента. Продакт-менеджер без опыта программирования собрала с ChatGPT скрипт на Python: топ-5 клиентов по среднему чеку. Скрипт работает, таблица выглядит правдоподобно. Промпт просит модель сыграть две роли: опытного аналитика, который ищет ошибки, и наставника, который составляет вопросы для проверки без ИИ.
Запустить можно на двух моделях из нашего бенчмарка: GPT-5.6 Sol и Kimi K3, доступ из России и цены видны в карточке при наведении. В описаниях наших замеров обе отмечены за готовый к работе код, у GPT-5.6 Sol отдельно – за честность о пределах данных.
Что получилось в наших прогонах (по два запуска на модель). Обе модели во всех четырёх запусках нашли четыре ошибки, которые не видны по таблице. Скрипт усредняет строки заказа вместо самих заказов, поэтому «средний чек» им не является. Заказ «2026-09-30 18:42» при сравнении строк выпадает из квартала, и последний день сентября пропадает целиком. fillna(0) превращает товары с неизвестной ценой в бесплатные. drop_duplicates() может удалить две настоящие одинаковые позиции. Вердикт во всех четырёх ответах один: клиенту отдавать нельзя. GPT-5.6 Sol отвечала за 30–45 секунд и оба раза приложила исправленный скрипт. Kimi K3 думала около шести минут, так что в окне выше придётся подождать.
Вопросы для Ольги у обеих моделей получились про её собственный код и её данные. Например: «у клиента заказ из позиций 600 и 400 рублей и заказ на 500 – что покажет твой скрипт и какой средний чек на самом деле?» Правильный ответ – 500 против 750, и без понимания кода его не дать. Заученный ответ модели тоже предсказали точно: «groupby группирует по клиенту, а mean считает среднее».
Одна деталь в тему статьи. В одном из запусков Kimi K3 привела пример, где клиент со средним чеком 10 000 рублей против 6 000 якобы «вдвое» выше. Вывод при этом верный, арифметика – нет. В наших замерах точные цифры – слабое место этой модели, и проверить такой пример может только тот, кто сам понимает расчёт. Это и есть позиция специалиста, которого авторы исследования советуют держать рядом.
Хороший результат узнаётся так: каждая проблема привязана к строке кода и показана на числах, проблемы, которые зависят от невидимых данных, помечены отдельно, вопросы нельзя закрыть общей фразой из учебника. Тот же промпт можно взять как шаблон для своих случаев: замените скрипт на отчёт, модель или сводную таблицу, которую сотрудник собрал с ИИ.
Скрипт работает, таблица правдоподобная, а цифры неверные – так выглядит большая часть ошибок ИИ в работе менеджера. Разберите их на 9 задачах открытого модуля – бесплатно.
Доступ сразу после регистрации
Где исследование слабее
Знания проверяли пятью вопросами сразу после двух 90-минутных задач. Это очень короткая и очень ранняя проверка. Она ничего не говорит о том, что будет через месяц ежедневной работы с ИИ. Авторы сами пишут, что долгосрочный эффект при постоянной практике может быть другим, и это за рамками их работы. На отдельных вопросах отвечали от 151 до 323 человек, так что маленький эффект эксперимент мог и не заметить.
Про возраст модели я писал в начале: GPT-4 весны 2024 года заметно слабее сегодняшних, и часть задач, которые тогда требовали участия человека, сегодня модель, возможно, решила бы сама. Это моё предположение, его никто не проверял. Если оно верно, разрыв между тем, что сотрудник сдаёт, и тем, что он понимает, со временем может стать шире.
Участники – консультанты одной компании с высшим образованием и сильной аналитической подготовкой. Авторы отдельно предупреждают, что на людей без высшего образования результаты переносить нужно с осторожностью. Задачи – отдельные куски работы дата-сайентиста, полный проект от данных до решения не проверяли. Перейти в новую профессию с помощью ChatGPT эксперимент тоже не проверял.
И последнее: анализ переоценки модели не был заранее зарегистрирован. К нему стоит относиться как к сильной гипотезе, подтверждённой одним экспериментом. Если хочется разобрать работу целиком, пригодится наш чек-лист вопросов к ИИ-исследованию.
Отчёт BCG, который мы разбирали летом, считал, сколько времени ИИ экономит сотрудникам. Эта работа той же компании задаёт следующий вопрос: что остаётся у человека, когда инструмент выключен. Ответ после одной сессии: не больше, чем у тех, кто работал без ChatGPT. Что останется после года работы с ИИ, пока никто не измерил, и ответ во многом зависит от того, как вы эту работу устроите.
Сделать с ИИ – полдела. Понять результат – навык
В программе mysummit.school ИИ используют на практических задачах, а понимание проверяют контрольными вопросами в уроках и заданиями, которые ИИ оценивает по критериям. Отдельная глава – о том, где модель надёжна, а где уверенно ошибается.
Часто задаваемые вопросы
Учит ли работа с ChatGPT новым навыкам?
Может ли менеджер с ChatGPT заменить дата-сайентиста?
Почему после работы с ChatGPT люди переоценивают модель?
Как учить команду работе с ИИ, чтобы навык остался?
Stanislav Belyaev
Engineering Leader в Microsoft18 лет в управлении инженерными командами. Основатель mysummit.school. 700+ выпускников в Яндекс Практикуме и Стратоплане.