Как читать ИИ-исследования: разбор статьи T-Tech о LIMe
AI-модели в этой статье
У статьи, которую в феврале 2025 года выложили исследователи из T-Tech, вызывающее название: «You Do Not Fully Utilize Transformer’s Representation Capacity», то есть «Вы не до конца используете возможности трансформера». В августе 2026 вышла третья версия, и работу приняли на основную программу EMNLP 2026, одной из главных конференций по обработке языка.
Если пересказать её в одну строку, получится обещание из рекламы: модели учатся быстрее, лучше решают математику и не требуют дополнительной памяти. Под каждым из этих слов в статье есть цифра. Но если сложить цифры вместе, картина выходит гораздо скромнее, и именно поэтому на этой работе удобно учиться читать ИИ-исследования.
Менеджеру архитектура нейросетей обычно ни к чему. А вот пересказы исследований попадают к нему постоянно: в рабочем чате, в презентации поставщика, в аргументах коллеги, который хочет «срочно переходить на новое». Ниже я разберу, что сделали авторы, что они измерили, какие вопросы к таким работам стоит задавать до того, как принимать по ним решения, – и, отдельно, почему при всём скепсисе эту работу стоит заметить.
Что придумали авторы
Современная языковая модель состоит из десятков слоёв. Каждый слой берёт результат предыдущего, что-то добавляет и передаёт дальше. Устроено это немного похоже на компанию, где каждый уровень видит только отчёт уровня ниже: директор не читает исходные заметки инженера, он получает их пересказ через три руководителя.
Авторы считают, что из-за этого в глубоких слоях модели наступает «коллапс представлений»: разные слова и признаки становятся всё более похожими друг на друга, и тонкие различия, заметные на первых слоях, теряются. Предложенный ими метод LIMe (Layer-Integrated Memory) даёт каждой голове внимания прямой доступ к данным всех предыдущих слоёв. Сколько брать из какого слоя, модель решает сама: этому учится отдельный небольшой «маршрутизатор».
Модель устроена как конвейер из десятков слоёв, и все они пишут в одну общую «записку» – остаточный поток. Каждый слой читает, что там уже есть, добавляет своё и передаёт дальше. Поэтому двенадцатый слой видит не то, что посчитал первый, а то, что от первого осталось после одиннадцати дописываний.
Записка не становится длиннее от того, что в неё дописывают. Места в ней ровно столько же, сколько было, поэтому ранние заметки приходится теснить. Авторы называют это коллапсом представлений: к глубоким слоям тонкие различия, заметные в начале, стираются. Пропорции на схеме условные – статья описывает эффект словами и таких долей не публикует.
LIMe даёт позднему слою право прочитать ранний напрямую, в обход записки. На схеме это пунктирная дуга: она выходит из первого слоя, минует всю стопку и входит в двенадцатый. Размер модели при этом не меняется – меняется только то, кого слой имеет право читать.
Источников у позднего слоя несколько, и выбирает между ними не инженер. Небольшой обученный маршрутизатор сам решает, сколько брать из какого слоя. Это важно для следующего раздела: веса маршрутизатора можно открыть и посмотреть, куда модель в итоге смотрит.
Схема по описанию статьи, не воспроизведение её рисунков. Источник: arXiv 2502.09245
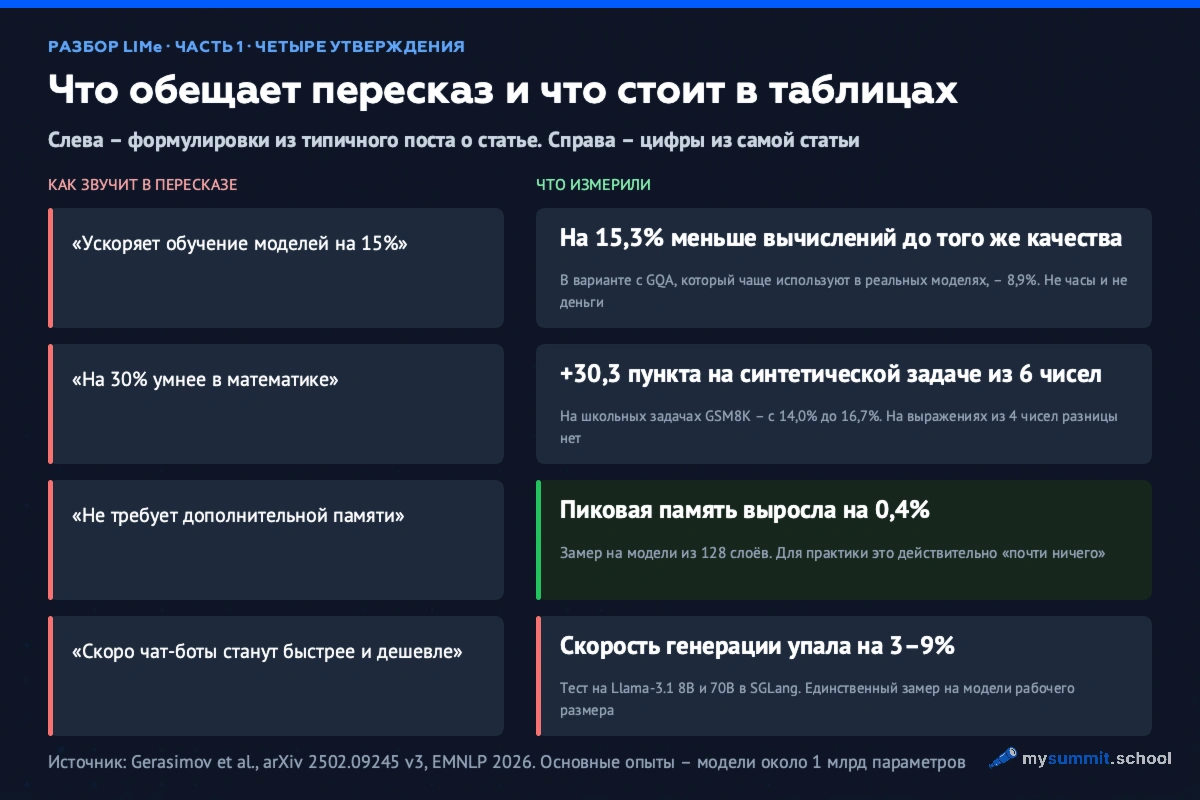
Важная инженерная деталь: нужные данные модель и так хранит в памяти во время работы, поэтому новой памяти почти не требуется. На модели из 128 слоёв пиковое потребление памяти выросло на 0,4%.
Посмотрев, что выучил маршрутизатор, авторы увидели то, на что рассчитывали: поздние слои действительно регулярно обращаются к самым ранним, вплоть до исходного представления слов. То есть модель, получив доступ к «исходным заметкам», ими пользуется.
Аналогия с компанией, конечно, хромает. Но главное она передаёт: идея в том, чтобы не терять по дороге то, что уже было посчитано.
Что измерили и что получилось
Здесь начинается самое интересное. Основные опыты поставлены на моделях около 1 млрд параметров, обученных с нуля на 50 млрд токенов из набора FineWeb Edu. Коммерческие модели, с которыми вы работаете, больше в десятки и сотни раз и обучены на триллионах токенов. Это не упрёк авторам: обучить с нуля несколько вариантов модели на миллиард параметров уже стоит серьёзных денег. Но это граница, за которую выводы статьи пока не выходят.
Теперь цифры, по одной, с тем, что каждая значит.
Скорость обучения
Чтобы достичь того же качества предсказания следующего слова, модели с LIMe нужно на 15,3% меньше вычислений, чем обычной модели архитектуры LLaMA. В варианте с GQA, способом экономии памяти, который используют многие реальные модели, выигрыш меньше – 8,9%. Итоговая перплексия (насколько модель «удивляется» правильному тексту, чем меньше, тем лучше) ниже примерно на 1%.
Тесты на понимание текста
Средний балл по набору тестов LM Eval Harness вырос с 50,29 до 54,21 у модели на 1 млрд параметров. Самый большой скачок на отдельных тестах, например на MultiRC: с 43,24 до 56,15.
Но есть и контрольный опыт, который стоит прочитать внимательнее. Авторы обучили модели на 360 млн параметров на 200 млрд токенов, в равных условиях с другими похожими методами. Средний балл по девяти задачам: обычная модель – 44,19, лучший конкурирующий метод – 44,56, LIMe – 45,09. Разница меньше одного балла. А публичная модель SmolLM2-360M того же размера, обученная другой командой по своему рецепту и на большем объёме данных, набирает 48,05. Рецепт обучения и данные здесь дали больше, чем архитектура.
Математика
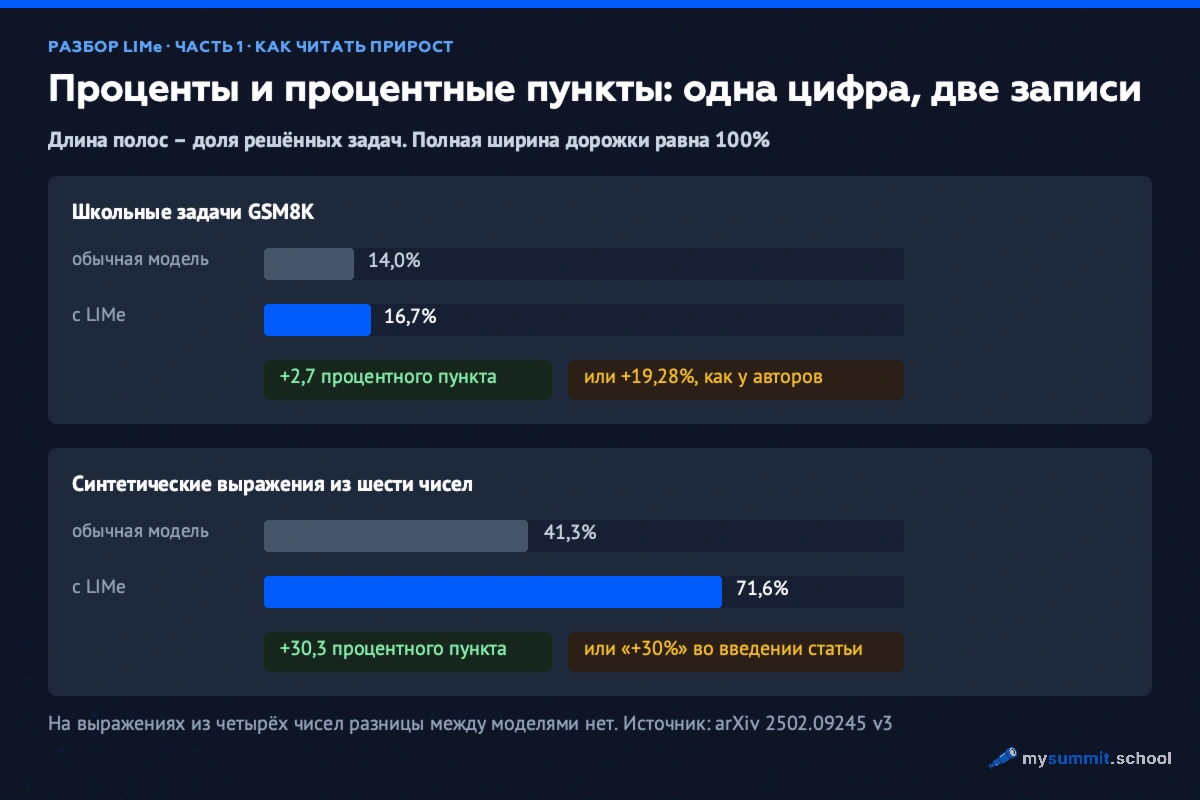
На школьных задачах GSM8K точность выросла с 14,0% до 16,7%. Авторы пишут о «приросте на 19,28%», и это правда в относительном выражении. В абсолютном – 2,7 процентного пункта, и обе модели по-прежнему ошибаются примерно в пяти задачах из шести. На синтетической задаче с арифметическими выражениями из шести чисел LIMe даёт 71,6% против 41,3%. Во введении статьи это записано как «+30%», хотя речь о процентных пунктах. А на выражениях из четырёх чисел разницы нет вообще.
Глубокие модели
Самый сильный результат – у очень глубоких и узких моделей. На 128 слоях перплексия снижается с 23,73 до 20,72, а модель из 64 слоёв с LIMe обходит обычную модель из 128 слоёв. Время шага обучения при этом растёт на 15%, но облегчённые варианты метода дают почти тот же выигрыш при росте времени на 2–3,5%.
Обслуживание пользователей
Эту часть в пересказах обычно опускают. Авторы встроили облегчённый вариант метода в Llama-3.1 на 8 и 70 млрд параметров и измерили скорость генерации в системе SGLang. Она упала на 3–9% в зависимости от длины запроса и размера модели. Для того, кто платит за обслуживание модели, это минус, пусть и небольшой.
Сами авторы честно пишут в разделе об ограничениях: сильнее всего результаты в условиях ограниченной ёмкости модели, на синтетических задачах и в очень глубоких моделях, а масштабирование на более широкие модели остаётся открытым вопросом. Это та строка, которую почти никогда не цитируют.
Разобрать одну статью так, как выше, несложно, если есть час и желание читать таблицы. Трудно делать это быстро и каждый раз: когда коллега пересылает пост в пятницу вечером, поставщик показывает слайд с «+40% к производительности», а модель уверенно пересказывает отчёт, которого вы не читали. Привычка задавать нужные вопросы к любому утверждению об ИИ вырабатывается практикой, и начать её удобнее на задачах, где правильный ответ известен заранее.
Отличить измеренное от пересказанного – навык, которому учат на практике. Попробуйте ИИ на 9 реальных задачах менеджера и посмотрите, где он ошибается уверенно – бесплатно.
Доступ сразу после регистрации
Шесть вопросов к любому ИИ-исследованию
Разбор выше можно свернуть в короткий список. Я задаю эти вопросы почти к каждой работе, которая попадает в дайджест, и к каждому слайду поставщика с процентами.
Какого размера модель и сколько данных?
Результат на модели в 1 млрд параметров для больших моделей остаётся гипотезой. Идеи, которые хорошо работали на маленьких моделях, на больших нередко давали меньше или не давали ничего. Бывает и наоборот, но проверить это может только опыт на большой модели.
В каких единицах измерили выигрыш?
«Обучение быстрее на 15%» в этой статье значит «на 15% меньше вычислений до того же качества». Время на часах и деньги на счёте здесь не измеряли. Вычисления, время, стоимость обучения и стоимость обслуживания – четыре разные величины, и выигрыш в одной может сопровождаться проигрышем в другой. Здесь так и вышло: обучение дешевле, обслуживание немного медленнее.
На каких задачах?
Синтетическая арифметика удобна для исследования, потому что в ней точно известен правильный ответ. Но выигрыш в 30 пунктов на ней и 2,7 пункта на школьных задачах – это разные истории, и пересказ почти всегда берёт первую.
Проценты или процентные пункты?
Рост с 41,3% до 71,6% – это 30,3 пункта или 73% в относительном выражении. Рост с 14,0% до 16,7% – 2,7 пункта или 19%. Для внушительности выбирают ту запись, которая больше. Пересчитать самому занимает полминуты.
С кем сравнивали?
Обычная модель, против которой показан выигрыш, обучена по тому же рецепту, что и новая. Это корректно для проверки идеи. Но рядом в той же статье есть публичная модель, обученная лучше, и она обходит обе. Если поставщик сравнивает свой продукт с «базовой моделью», спросите, с какой и насколько хорошо её настроили.
Что сами авторы написали в ограничениях?
В хорошей статье этот раздел есть, и в нём обычно ответ на вопрос «можно ли это применять у нас». В этой статье ответ прямой: на широких моделях пока не проверено.
Список не делает из вас исследователя, и не должен. Его задача скромнее: за пять минут отделить то, что измерили, от того, что дописал пересказ. Тот же подход работает и с отчётами, которые пишет вам ИИ-агент: мы разбирали его в статье о том, как проверять уверенные, правдоподобные и неверные выводы. И с утверждениями сотрудников о том, что с ИИ работа идёт быстрее или медленнее: об этом отдельный разбор.
Шесть вопросов работают и с отчётами ИИ, и с презентациями поставщиков. В открытом модуле – 9 практических задач менеджера, на которых видно, где модели нельзя верить на слово. Бесплатно.
Доступ сразу после регистрации
Почему работу всё-таки стоит заметить
Разбор выше был скептическим, и это не весь разговор. Если применить к этой статье её же шестой вопрос – «а что говорит остальная литература», – картина меняется. Та же слабость трансформера независимо найдена несколькими группами, и у работы T-Tech есть две сильные стороны, которых обычно нет.
С соперниками, а не только с базой
Победить слабую базовую модель легко, и большинство статей этим и ограничивается. Здесь авторы обучили в одинаковых условиях сразу несколько методов из того же направления.
Точка отсчёта. Слои общаются только через остаточный поток: каждый читает, что в нём накопилось, и дописывает своё. Прямых связей между слоями нет. Именно эту схему все четыре метода ниже и переделывают – каждый по-своему.
EPFL, 2024. Самый прямолинейный ответ: пусть блок получает не только текущее состояние потока, а взвешенное среднее всех прошлых. Веса модель подбирает сама. Цена – несколько тысяч дополнительных параметров даже у очень больших моделей.
Zhou et al., 2024. Более экономный вариант: один источник, много получателей. Значения первого слоя подмешиваются во все следующие. Если потеря начинается с самого начала сети, то и чинить достаточно начало.
ByteDance, ICLR 2025. Другой угол: проблема не в том, кто кого читает, а в том, что поток один. Значит, потоков должно быть несколько, а модель пусть учится их смешивать. Именно из этой идеи выросло то, что DeepSeek встроила в V4.
T-Tech, EMNLP 2026. Схема не фиксируется заранее: каждая голова внимания может взять данные из любого более раннего слоя, а что именно брать, решает обученный маршрутизатор.
Схемы наши, по описанию механизмов в самих работах. Переключайте вкладки: меняется только проводка, рисунок тот же
Результат на моделях в 1 млрд параметров: обычная модель – 50,29, DenseFormer – 50,62, Hyper-Connections – 52,22, LIMe – 54,21. Все три метода обходят базу, и это само по себе довод в пользу того, что проблема настоящая.
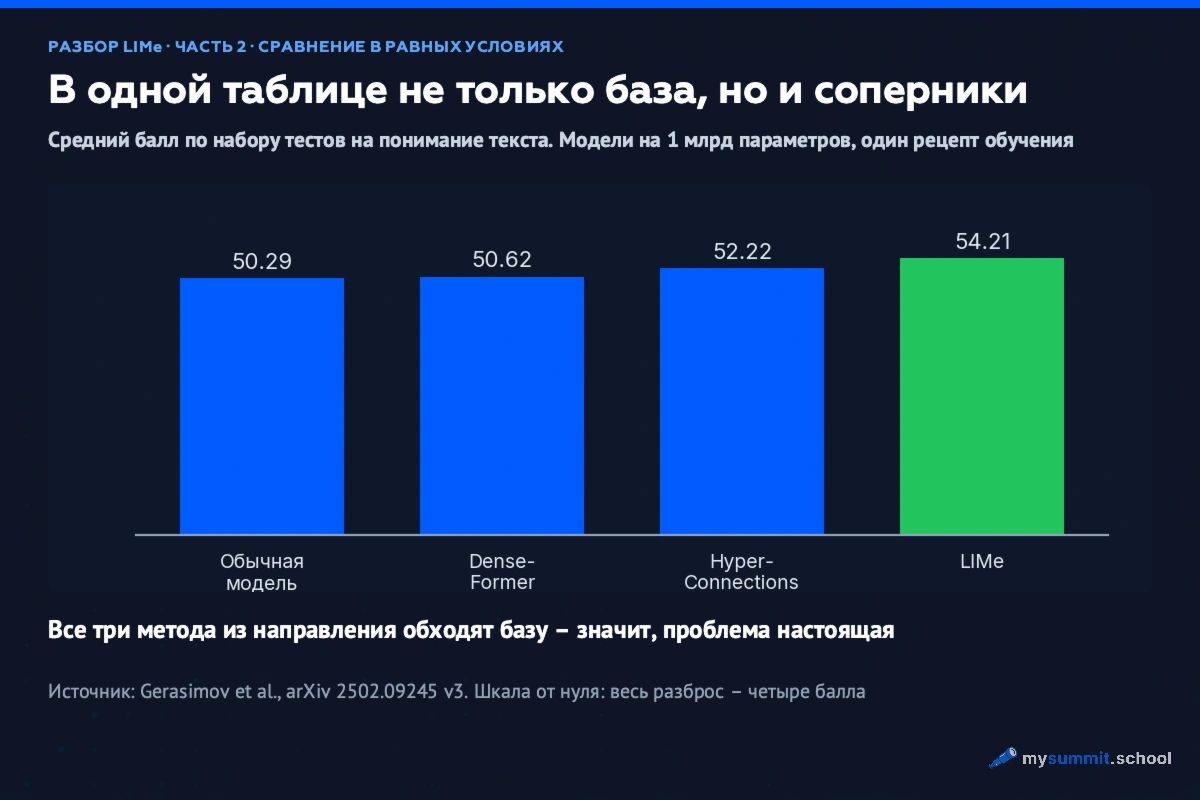
Заметьте, что это тот же приём, который в шести вопросах я советовал требовать от поставщика. Здесь авторы применили его к себе сами.
Модель показывает, откуда берёт данные
Маршрутизатор – обычные обученные веса, их можно открыть и посмотреть. Авторы так и сделали.
Слои со второго по четвёртый активно обращаются к исходным представлениям слов – то есть к тому, с чего всё началось, а не к пересказу через поток. Проще всего прочитать это так: модели действительно не хватало доступа к началу, иначе она бы им не пользовалась.
Последние слои тоже заметно обращаются к двум самым первым: перед тем как предсказать следующее слово, модель возвращается к исходному тексту. Рядом есть и прямой замер – точность определения грамматичности по шестнадцатому слою выросла с 0,864 до 0,918.
Качественная схема двух закономерностей, названных в статье. Числовых весов маршрутизатора авторы не публикуют, поэтому никаких чисел на схеме нет
Цифры качества говорят «стало лучше», а карта маршрутизатора объясняет почему. Если бы гипотеза о потере данных была неверной, маршрутизатор научился бы читать только соседний слой.
Похожую идею уже встроили в рабочую модель
В апреле 2026 года вышла DeepSeek-V4, и в техническом отчёте среди ключевых изменений назван метод mHC – доработка тех самых Hyper-Connections. Это другой механизм, чем LIMe, но меняет он ту же часть архитектуры. Сколько качества дал mHC, отчёт не говорит. Показателен сам факт: компания, которая славится экономией на обучении, потратила инженерное время и до 6,7% времени одного из этапов обучения на то, чтобы перестроить связи между слоями во флагманской модели.
Статья на конференции – это мнение рецензентов. Встраивание в модель, которую обслуживают миллионы запросов, – решение компании, которая платит за ошибку. Это и есть разница между «одна эффектная работа» и «направление»: к проблеме независимо пришли разные группы, методы сравнили между собой в равных условиях, а родственную идею уже возят в продакшене.
Проверьте пересказ сами
Чтобы проверить список в деле, я составил пост в типичном для телеграм-каналов стиле о той же статье и положил рядом выписку фактов из неё. Пост выдуман, цифры в выписке взяты из статьи. Промпт просит модель разобрать каждое утверждение поста и ответить коллеге, который предлагает «переходить на новую архитектуру».
Запрос можно отправить двум моделям, которые в нашем бенчмарке лучше всего справляются с анализом и принятием решений. Kimi K3 в этой категории на первом месте и доступна из России напрямую; в описании модели отмечено, что она хорошо переформулирует задачу и строит сценарии, а цифры и источники у неё стоит перепроверять. GPT-5.6 Sol на втором месте, в её описании отмечена честность о пределах данных; из России она официально недоступна.
В наших прогонах обе модели во всех шести попытках заметили главное: «30% умнее» – это процентные пункты на одной синтетической задаче, «15%» – экономия вычислений, которая в варианте с GQA сжимается до 8,9%, а обещание быстрых и дешёвых чат-ботов противоречит замеру скорости генерации. Обе ответили коллеге, что менять инструменты команды из-за этой работы не стоит.
Интереснее, где модели разошлись. Утверждение «не требует дополнительной памяти» GPT-5.6 Sol каждый раз признавала противоречащим данным: память выросла на 0,4%, значит, не ноль. Kimi K3 в трёх попытках дала три разных вердикта, от «противоречит» до «подтверждается с оговоркой». По-моему, ближе к правде второе: для менеджера 0,4% – это «практически не требует». Но спор о формулировке здесь честный, и решать его приходится вам, модель только показывает, где он есть. Учтите и время: Kimi K3 в режиме рассуждений отвечала нам около двенадцати минут, GPT-5.6 Sol – меньше половины минуты.
Когда разберётесь с примером, подставьте в промпт свой пост, слайд поставщика или абзац из отчёта, а в выписку – то, что написано в первоисточнике. Если первоисточника под рукой нет, это уже ответ: проверять нечего, верить пока рано.
Что это меняет для вас
В ближайший год – почти ничего, и это нормальный итог для хорошей исследовательской работы. Инструменты, которыми пользуется ваша команда, от этой статьи не изменятся. Если идея подтвердится на больших моделях, вы, скорее всего, заметите это по тому, что очередная модель станет дешевле или лучше справится с длинными цепочками рассуждений. Ссылку на статью при этом вряд ли кто-то покажет.
Полезнее другое наблюдение. Даже в аккуратной статье, принятой на сильную конференцию, есть место, где «+30%» означает процентные пункты, а «+19%» – 2,7 пункта. Авторы при этом ничего не скрывают: все цифры лежат в таблицах, ограничения названы. Искажение появляется на следующем шаге, когда работу пересказывают в одну строку. Чем дальше пересказ от таблиц, тем больше в нём обещаний.
Есть и практический вывод, который переживёт эту конкретную статью. Модель из 64 слоёв, не уступающая модели из 128, – лабораторный пример, но логика в коммерческих моделях та же: устройство, данные и рецепт обучения дают столько же, сколько удвоение параметров. Сравнивать модели по числу параметров или по громкости бренда поэтому ненадёжно – в нашем бенчмарке они заметно меняют места в зависимости от категории задач. И если идеи вроде LIMe и mHC продолжат приживаться, ощутимая часть выигрыша достанется не самым большим моделям. Это повод раз в полгода пересматривать, не закроет ли модель подешевле задачи, для которых вы когда-то выбрали самую дорогую.
Чего мы при этом не знаем, стоит назвать прямо. Основные опыты поставлены на моделях около 1 млрд параметров, на широких моделях метод не проверен, при обслуживании пользователей он замедляет генерацию на 3–9%, а DeepSeek не сообщает, сколько качества дал mHC. Направление настоящее, решения работают на небольших моделях, одно из них уже в промышленной модели. Сколько это даст вашей команде в деньгах, пока не измерил никто.
Проверять утверждения об ИИ – рабочий навык
В Фундаменте курса есть глава о критическом мышлении и ограничениях ИИ: быстрая проверка любого ответа модели, разбор типичных ошибок и практика на задачах, где правильный ответ знаете вы, а модель уверенно ошибается.
Источники
- Gerasimov G., Aksenov Y., Balagansky N., Sinii V., Gavrilov D. You Do Not Fully Utilize Transformer’s Representation Capacity. arXiv:2502.09245, v3, август 2026. Принята на EMNLP 2026 (Main). HTML-версия, код.
- Pagliardini M., Mohtashami A., Fleuret F., Jaggi M. DenseFormer: Enhancing Information Flow in Transformers via Depth Weighted Averaging. NeurIPS 2024.
- Zhou Z. et al. Value Residual Learning. arXiv:2410.17897.
- Zhu D. et al. Hyper-Connections. ICLR 2025.
- Xie Z. et al. (DeepSeek-AI). mHC: Manifold-Constrained Hyper-Connections. arXiv:2512.24880.
- DeepSeek-AI. DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. arXiv:2606.19348, апрель 2026.
- Skean O. et al. Layer by Layer: Uncovering Hidden Representations in Language Models. ICML 2025.
- Бенчмарк ИИ-моделей для менеджеров MySummit.school – категория «Анализ и решения».
Часто задаваемые вопросы
Что такое LIMe простыми словами?
Станут ли ChatGPT или GigaChat лучше благодаря LIMe?
Какие вопросы задать к новости об ИИ-исследовании?
Использует ли DeepSeek метод LIMe?
Как понять, что исследование – часть направления, а не разовая удача?
Чем процентные пункты отличаются от процентов?
Stanislav Belyaev
Engineering Leader в Microsoft18 лет в управлении инженерными командами. Основатель mysummit.school. 700+ выпускников в Яндекс Практикуме и Стратоплане.