Как проверить ответ нейросети: промпт, который ловит ошибки
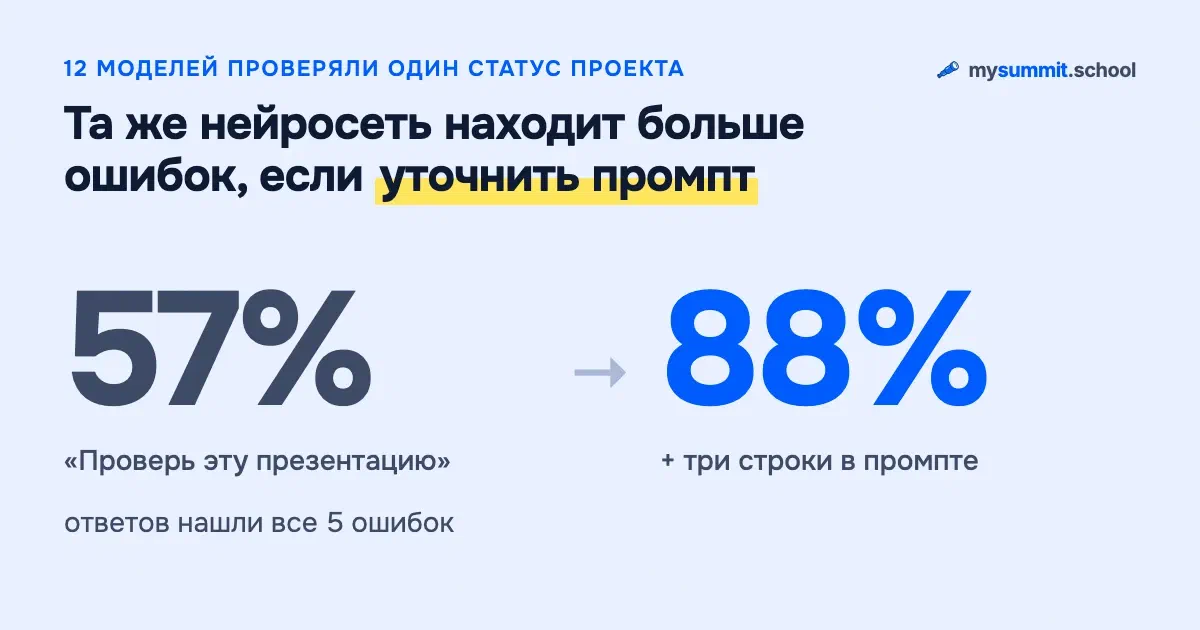
ИИ за минуту собирает статус проекта для управляющего комитета. Текст гладкий, и тон у него уверенный. В таком статусе мы заложили пять ошибок, и самая опасная из них – строка, которой в тексте нет: четыре критичных бага всё ещё открыты.
Мы попросили 12 моделей проверить этот статус. На простое «проверь эту презентацию» все пять ошибок нашлись в 57% ответов. Промпт из четырёх строк поднял долю до 88%. А одна строка, которая кажется самой правильной, мешала моделям заметить самую опасную ошибку.
Это разбор моего доклада «Уверенный, правдоподобный, неправильный: как проверять работу, которую сделал не человек». Я рассказывал его 11 ноября на онлайн-конференции pmclub upskill week, тема которой – навыки менеджера на 2027 год. Ниже – промпт для проверки с цифрами по каждой строке, практикум, на котором можно потренироваться самому, и объяснение, почему ИИ ошибается так убедительно.
Видео и слайды доклада
Доклад идёт около 45 минут, с практикумом и вопросами. Слайды можно скачать в PDF: там все цифры и ссылки на исследования. Если времени мало, начните с 37:34 – это часть о том, как проверять и не тратить на проверку весь день.
Промпт для проверки: что даёт каждая строка
Кейс у нас был такой. Проект «Pay 2.0», запуск 15 декабря, идёт спринт 14 из 16. Исходные данные – выгрузка из трекера, письма подрядчика и QA, бюджет, опрос пилотных пользователей. По ним ИИ сделал презентацию статуса для комитета, и в ней пять ошибок:
- бюджет освоен «на 62%», хотя в октябре его увеличили до 12 млн и 6,2 из 12 – это 52%;
- «после интеграции остаётся запас», хотя интеграцию сдают 4 декабря, а на регрессию QA просит 10 рабочих дней;
- «пользователи пилота довольны» – по 9 ответам из 120 разосланных анкет;
- «остальные работы идут с опережением» – подрядчик писал «остальное по плану», опережение модель добавила сама;
- в презентации нет четырёх открытых критичных багов, есть только три закрытых.
Дальше мы прогнали проверку на 12 актуальных моделях, от GPT-5.6 Luna и Claude Opus 5.5 до GigaChat 3.5 Ultra и Алисы. Каждый вариант промпта – по три прогона на модель, 33–35 ответов на строку. Что именно нашла каждая модель, оценивал Claude Sonnet 5 по списку из пяти заложенных ошибок. Промпт рос по одной строке:
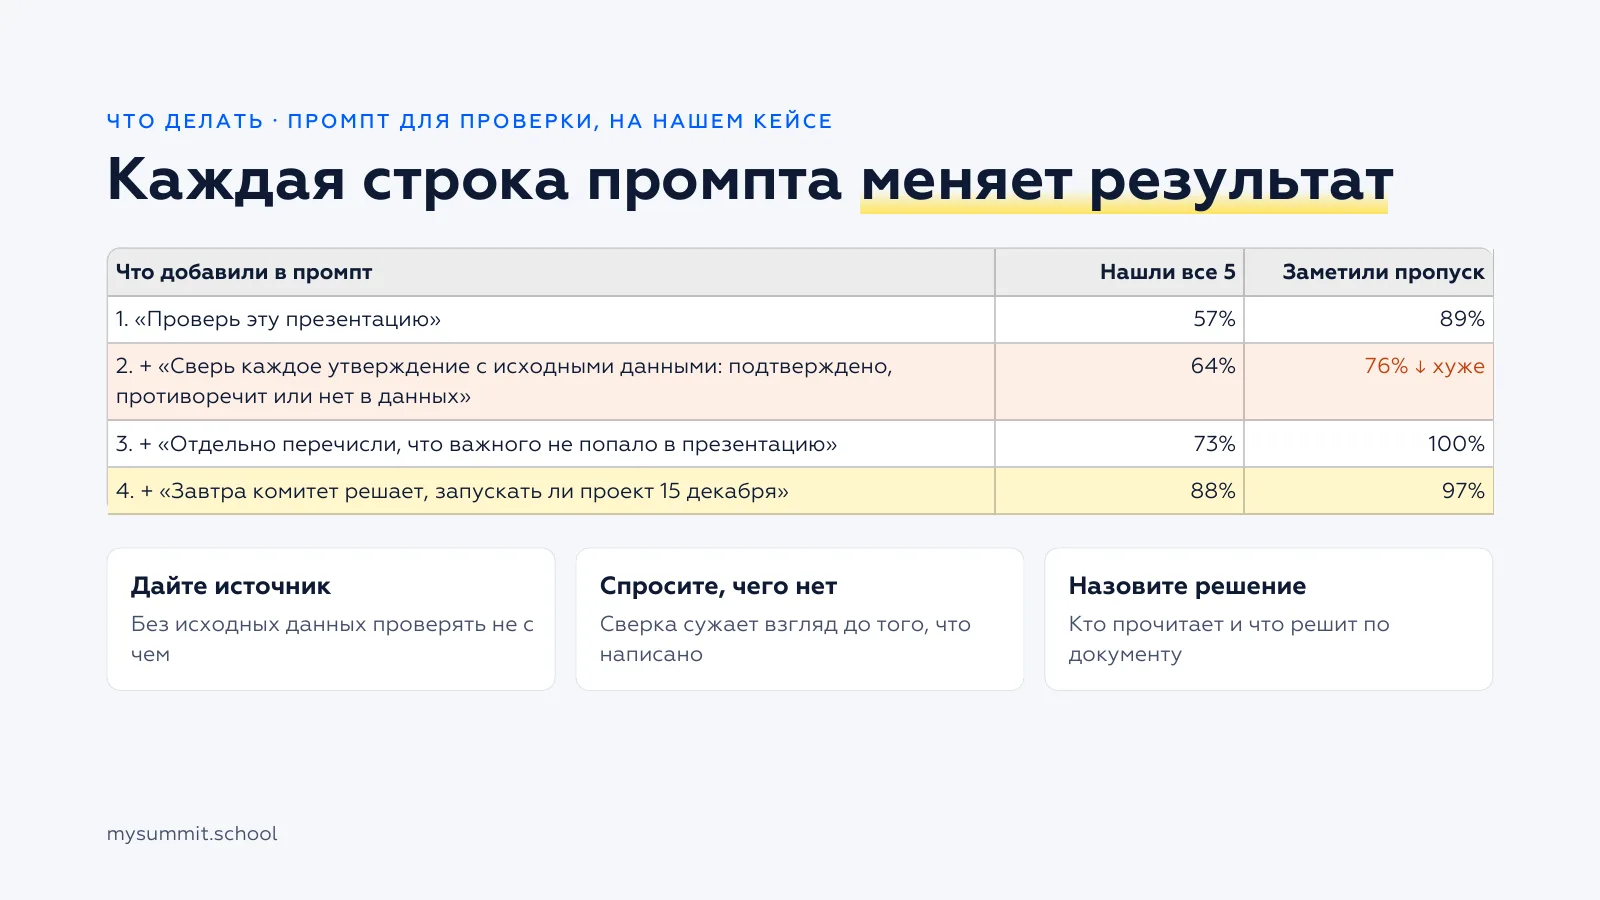
| Что добавили в промпт | Нашли все 5 ошибок | Заметили пропуск багов |
|---|---|---|
| «Проверь эту презентацию» | 57% | 89% |
| + «Сверь каждое утверждение с исходными данными: подтверждено, противоречит или нет в данных» | 64% | 76% |
| + «Отдельно перечисли, что важного не попало в презентацию» | 73% | 100% |
| + «Завтра комитет решает, запускать ли проект 15 декабря» | 88% | 97% |
Вторая строка выглядит самой правильной: сверь каждое утверждение с источником. Все пять ошибок модели после неё находят чаще, но пропуск замечают реже, 76% вместо 89%. Объяснение простое: модель проверяет то, что написано. Строки про открытые баги в презентации нет, поэтому построчной сверке нечего с ней сравнить. Одна отдельная просьба «перечисли, чего не хватает» возвращает пропуск до 100%.
Самый сильный эффект дала последняя строка. Когда модель знает, какое решение примут по документу, она сама решает, что для этого решения важно. Запуск 15 декабря, интеграция 4 декабря, 10 рабочих дней регрессии – и «запас» перестаёт выглядеть правдой.
Если собрать строки вместе, получится шаблон для ваших документов:
| |
Мы проверяли эти строки на одном кейсе, в формулировках для комитета. На ваших документах шаблон может работать иначе, и это нормально: его стоит прогнать 2–3 раза на одном и том же документе и посмотреть, совпадают ли находки.
Без исходных данных промпт бесполезен. Если модели не с чем сверять, она будет проверять документ на правдоподобие, а правдоподобие у текста ИИ почти всегда в порядке.
Между моделями разница огромная. Claude Opus 5.5 и Claude Sonnet 5 находят все пять ошибок почти с любым промптом. Алиса находит от одной до четырёх, GigaChat 3.5 – три-четыре. И слабым моделям построчная сверка вредит сильнее всего: Алиса с ней в среднем находила одну ошибку из пяти. На ранней, более простой версии кейса старые GPT-5.4 nano, GigaChat 2 Pro и YandexGPT 5 Pro с построчной сверкой не заметили пропуск ни разу из 15 попыток. Если у вас в компании разрешена только одна модель, полезно знать, к какой группе она относится, – сравнить модели можно в нашем бенчмарке.
На сцене, кстати, получился хороший демо-эффект. Я запустил большой промпт вживую, и самая маленькая GPT-5.4 nano и Алиса с ним не справились, хотя на прогонах накануне он работал почти везде. Один живой прогон – это одна попытка из многих, и разброс у слабых моделей большой. Как это выглядело, видно в записи с 33:45.
Практикум: найдите 5 ошибок в статусе проекта
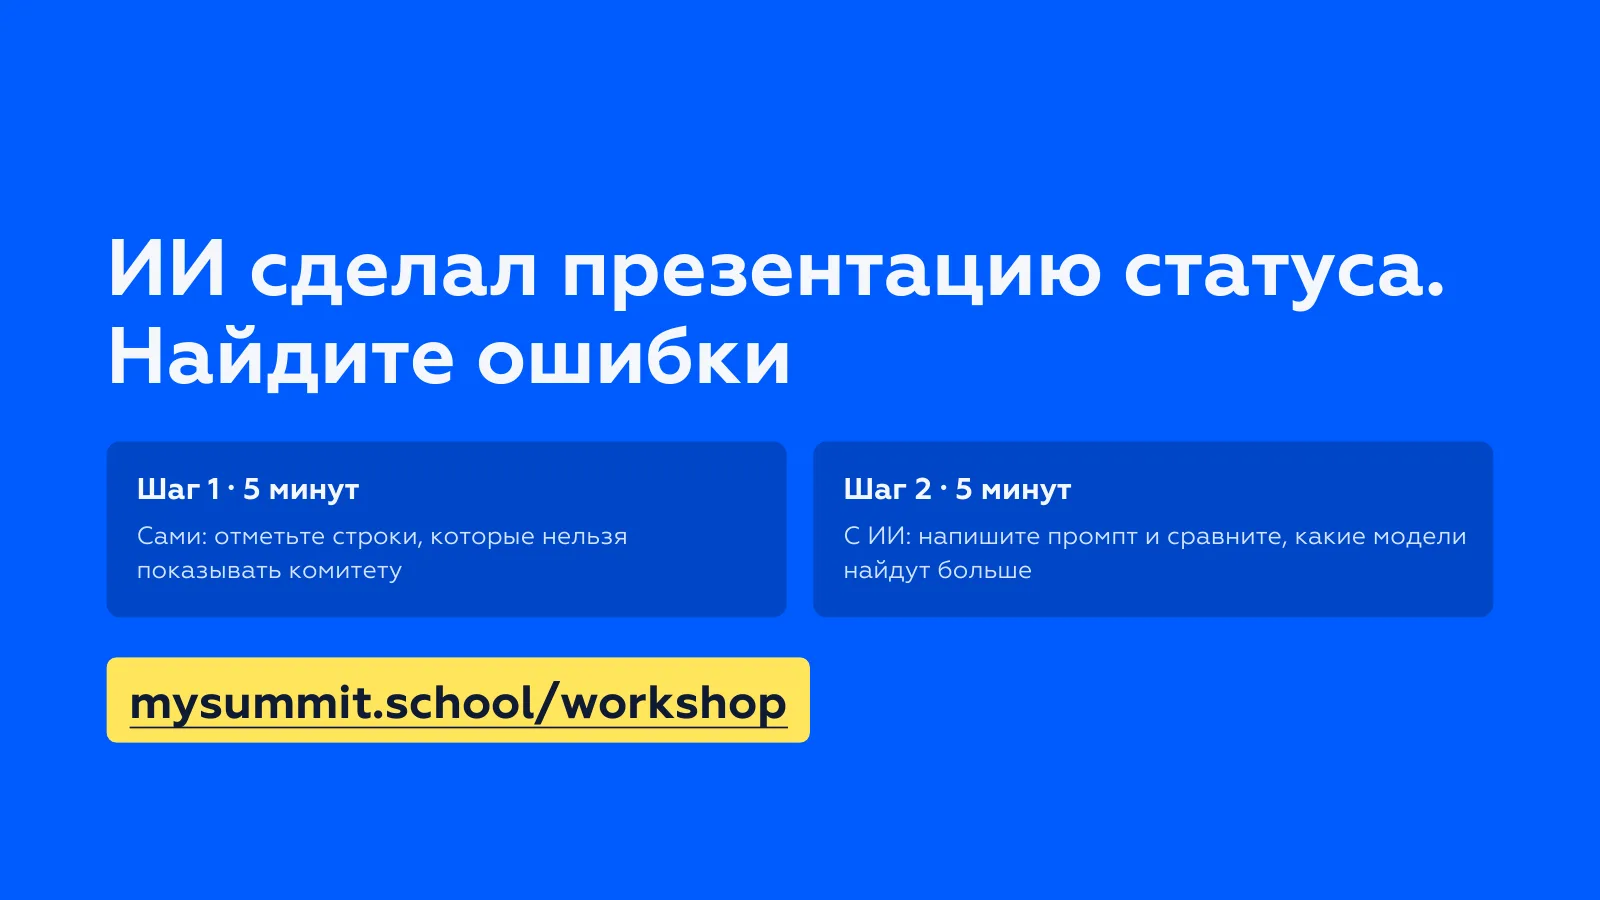
Тот же кейс открыт как практикум на 10 минут. Сначала вы сами отмечаете строки презентации, которые нельзя показывать комитету как есть: ошибки и типичные фразы ИИ вроде «синергии скорости и качества». Потом пишете свой промпт или берёте готовый слабый или сильный и запускаете его на нескольких моделях, до трёх сразу. Судья отмечает, какие из пяти ошибок нашла каждая модель.
Первый шаг стоит пройти честно, до того как смотреть ответы. На докладе практикум прошли 18 человек, и все четыре ошибки в тексте нашли четверо. Пятую, открытые баги, кликнуть нельзя вовсе: её нет в тексте, о ней можно только написать в отдельном поле. Самыми трудными мне кажутся бюджет и «запас»: обе ошибки видны, только если посчитать.
Промпты в этом практикуме выглядят простыми, и с готовым шаблоном кажется, что проверка решена. Сложности начинаются на своих документах: какие исходные данные дать, какое решение назвать, что делать, если модель нашла три ошибки из пяти и уверенно сказала, что остальное в порядке. В этом и разница между знанием и навыком.
Почему ИИ ошибается уверенно
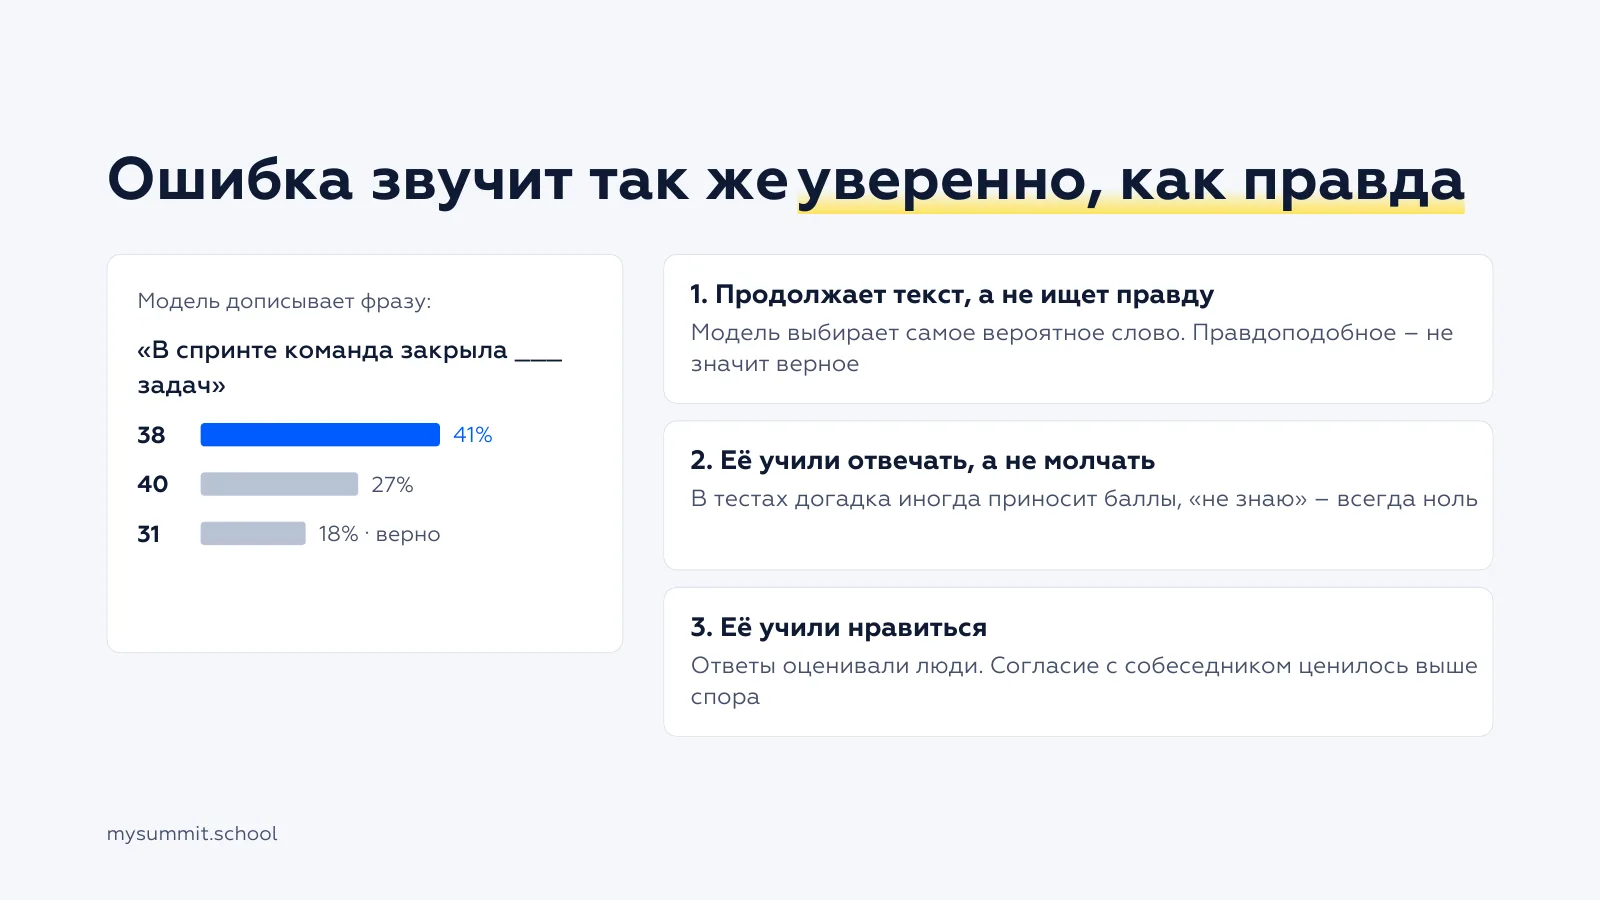
Причин три, и все они следуют из того, как модели устроены и как их обучают.
Первая: языковая модель продолжает текст. На каждом шаге она выбирает самое вероятное следующее слово. Во фразе «В спринте команда закрыла ___ задач» модель поставит самое правдоподобное число, и если она не сверяется с трекером, правдоподобное не обязано совпасть с верным.
Вторая: модель учили отвечать. В сентябре 2025 года исследователи OpenAI разобрали, почему модели галлюцинируют: на тестах догадка иногда угадывает и приносит баллы, а «не знаю» всегда даёт ноль. Пример из их статьи: угадать чей-то день рождения можно с шансом 1 из 365, но это всё равно больше нуля. Поэтому модели выгоднее уверенно угадать.
Третья: модель учили нравиться. Ответы при обучении оценивали люди, а людям приятнее, когда с ними соглашаются и их хвалят. Отсюда поддакивание и смена ответа на «ты уверен?» – про это ниже.
В итоге у модели нет отдельного голоса для «я не уверена». Ошибка звучит так же гладко, как правда, поэтому по тону её не поймать – только сверкой с источником.
Длинный чат – ещё одна причина ошибок
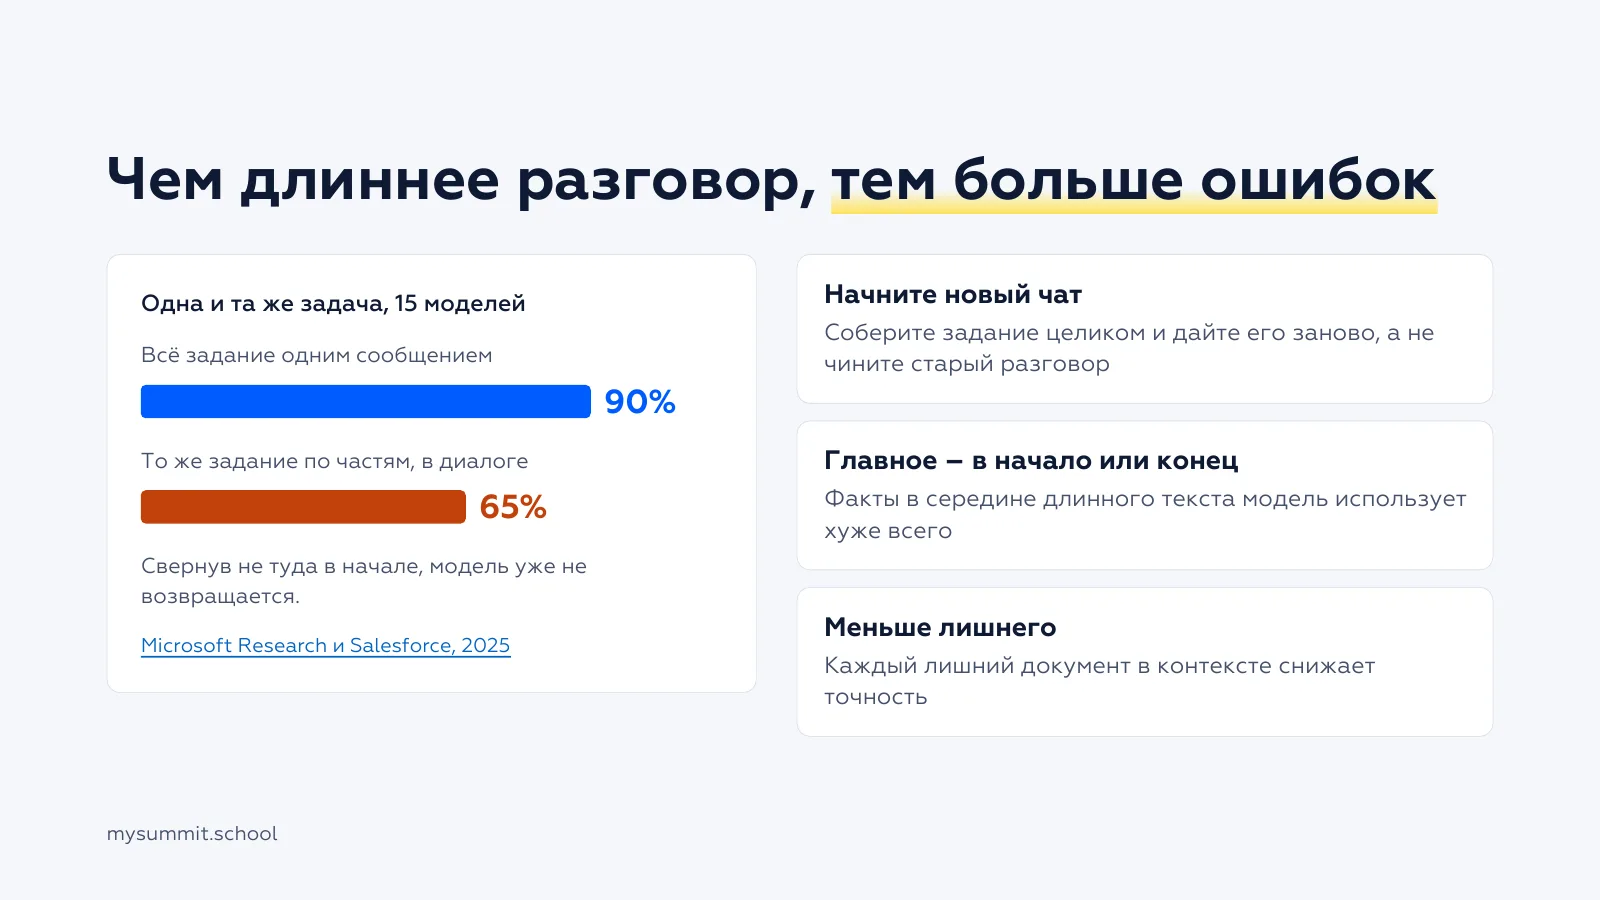
Об этом говорят реже. Исследователи Microsoft Research и Salesforce дали 15 моделям одни и те же задачи двумя способами: всё задание одним сообщением и то же задание по частям, как в обычном рабочем диалоге. Средний результат упал примерно с 90% до 65%. Авторы объясняют это так: свернув не туда в начале разговора, модель уже не возвращается.
Есть ещё два эффекта. Работа Lost in the Middle показала, что факты в начале и в конце длинного текста модель использует хорошо, а в середине – хуже всего. А исследование Chroma Context Rot на 18 моделях показало, что даже на простой задаче результат становится менее надёжным просто от того, что вход длиннее.
Что из этого следует для работы:
- если разговор пошёл не туда, начните новый чат и дайте задание целиком, со всеми данными, одним сообщением – это совет самих авторов исследования;
- главное требование поставьте в начало и повторите в конце;
- не смешивайте темы в одном чате, каждый лишний документ снижает точность.
Отчёт, который вы получили в конце длинной сессии, где полдня обсуждали проект, стоит проверять особенно внимательно. Подробнее эту часть я разбираю в записи с 04:40.
На глаз текст ИИ не отличить
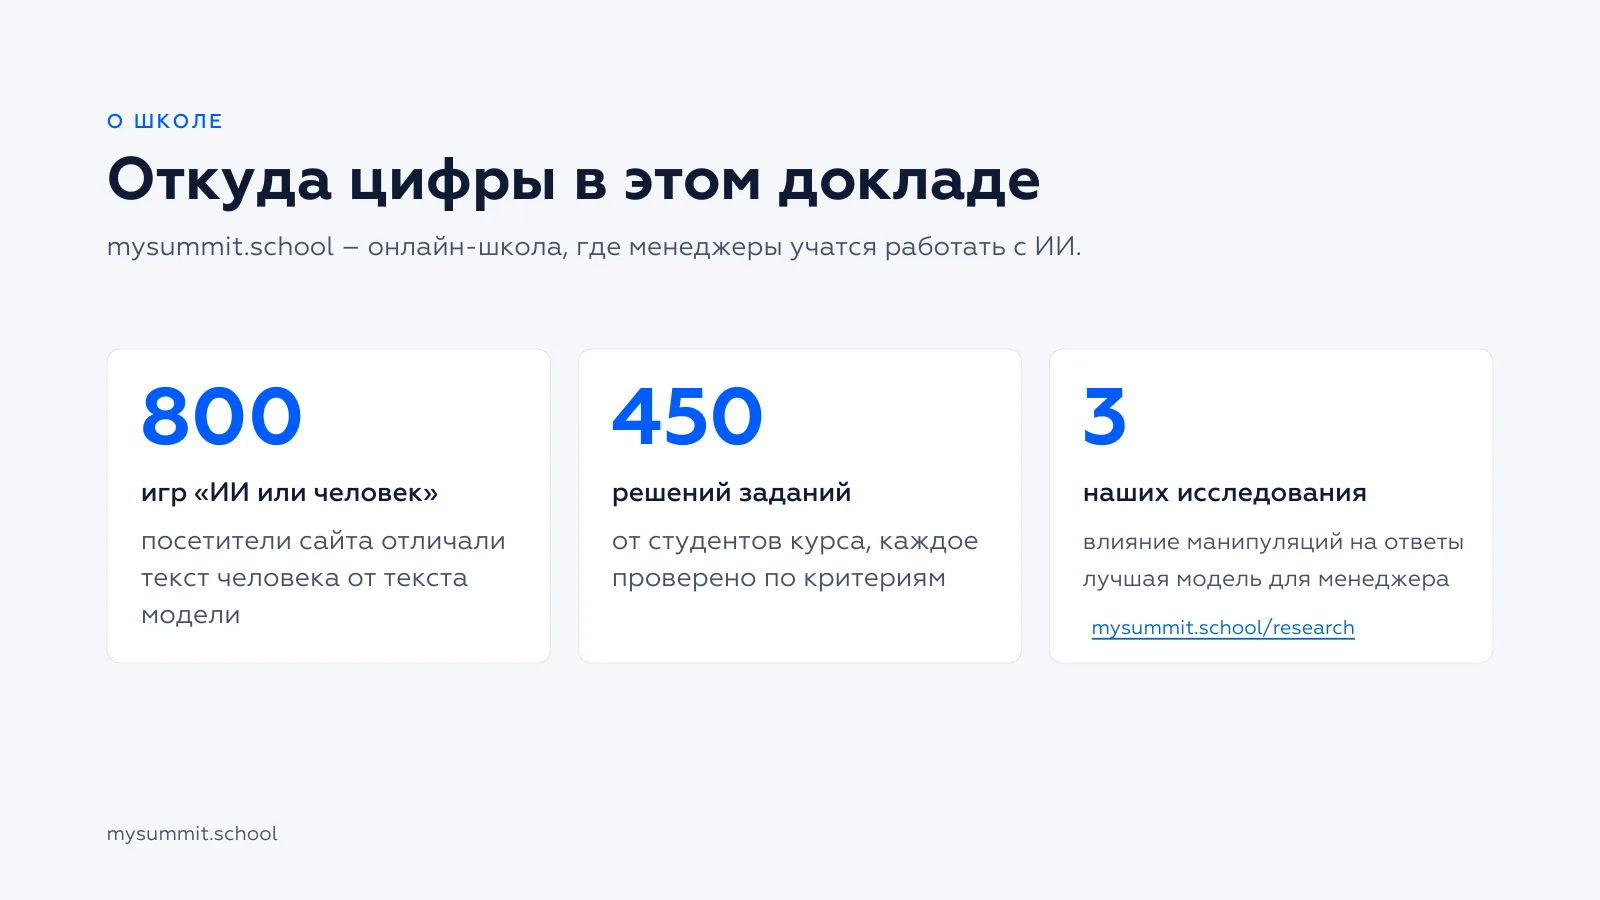
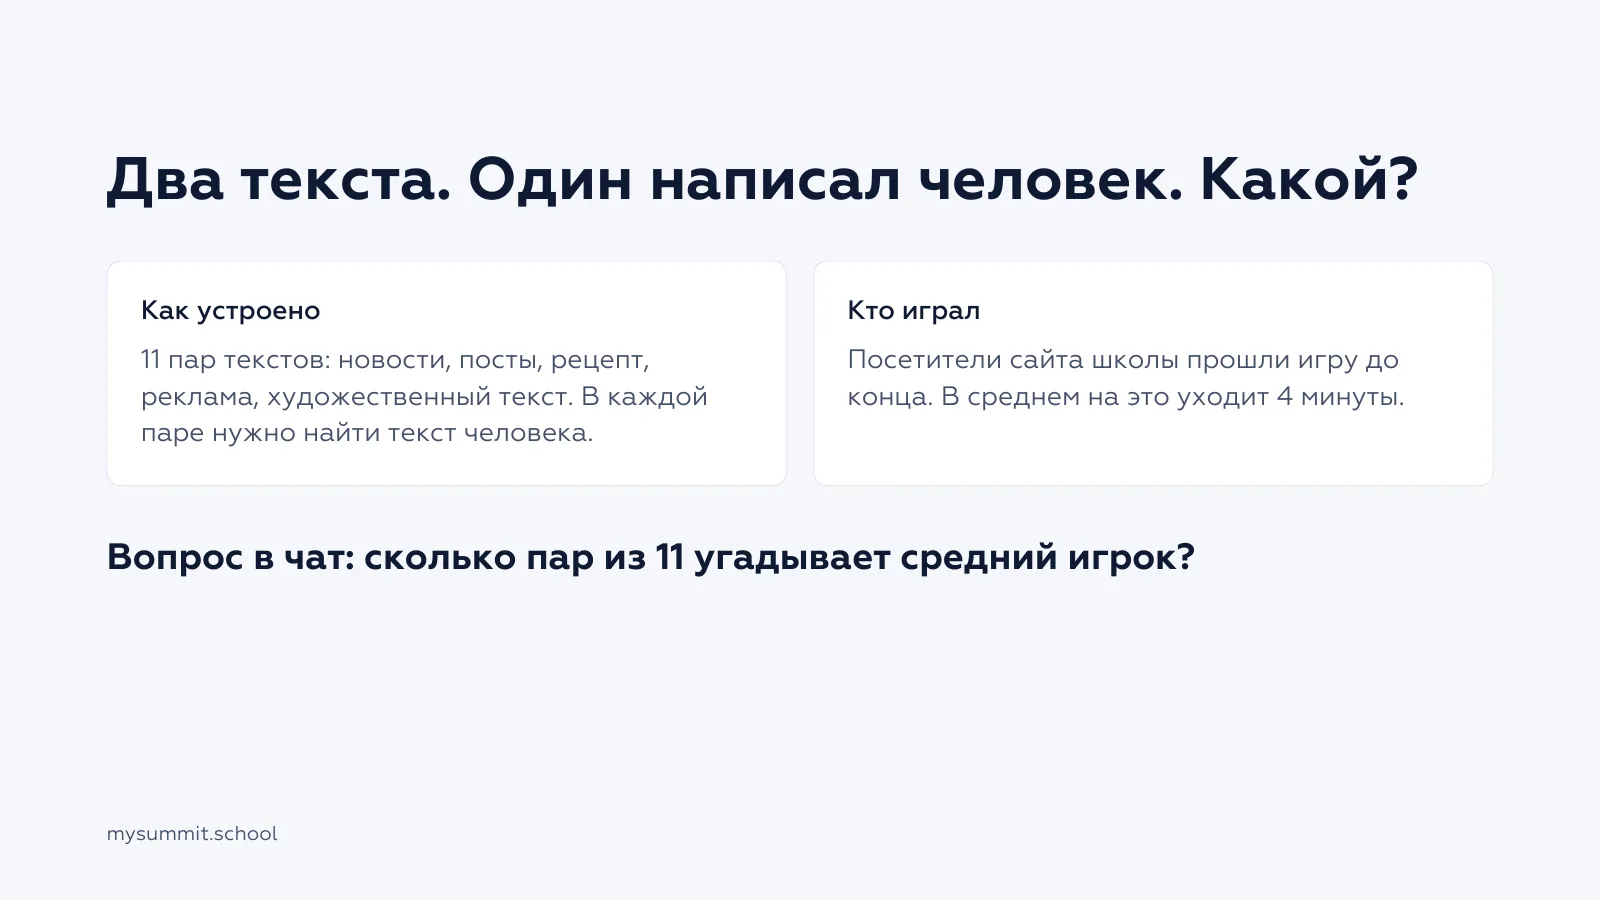
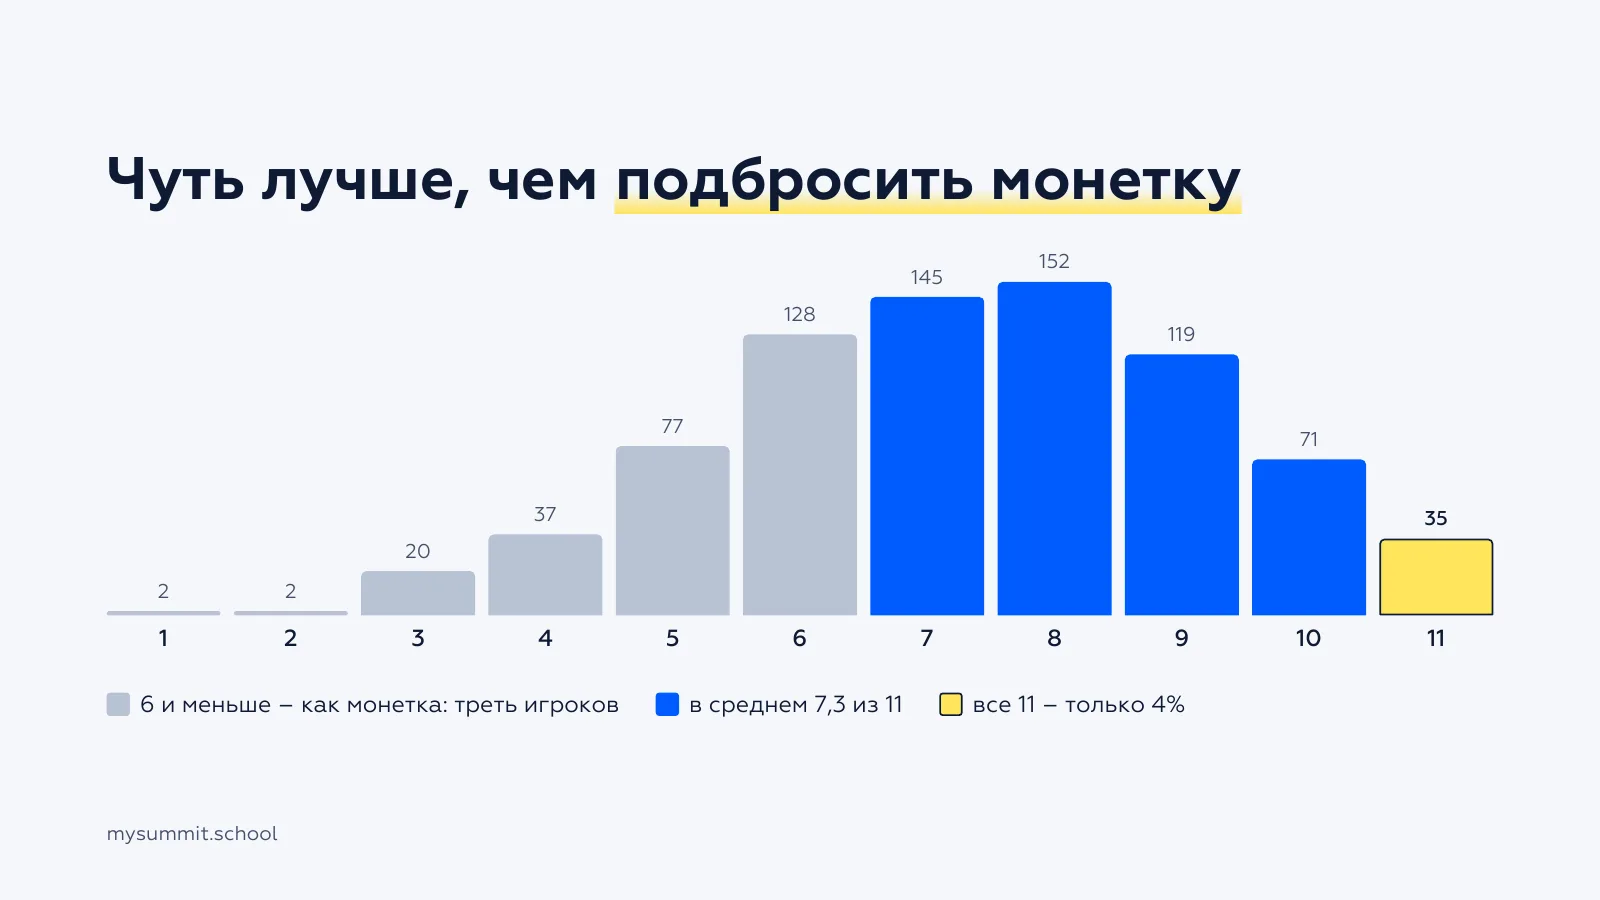
Наверняка вы скажете: я-то текст ИИ узнаю сразу. У нас на сайте есть игра «ИИ или человек»: 11 пар текстов, в каждой нужно найти тот, что написал человек. Игру прошли до конца 800 посетителей сайта, на неё уходит минуты четыре.
Средний игрок угадывает 7,3 пары из 11. Монетка в среднем угадала бы 5,5. Треть игроков угадали 6 пар или меньше, то есть на уровне монетки, а все 11 пар – только 4%.
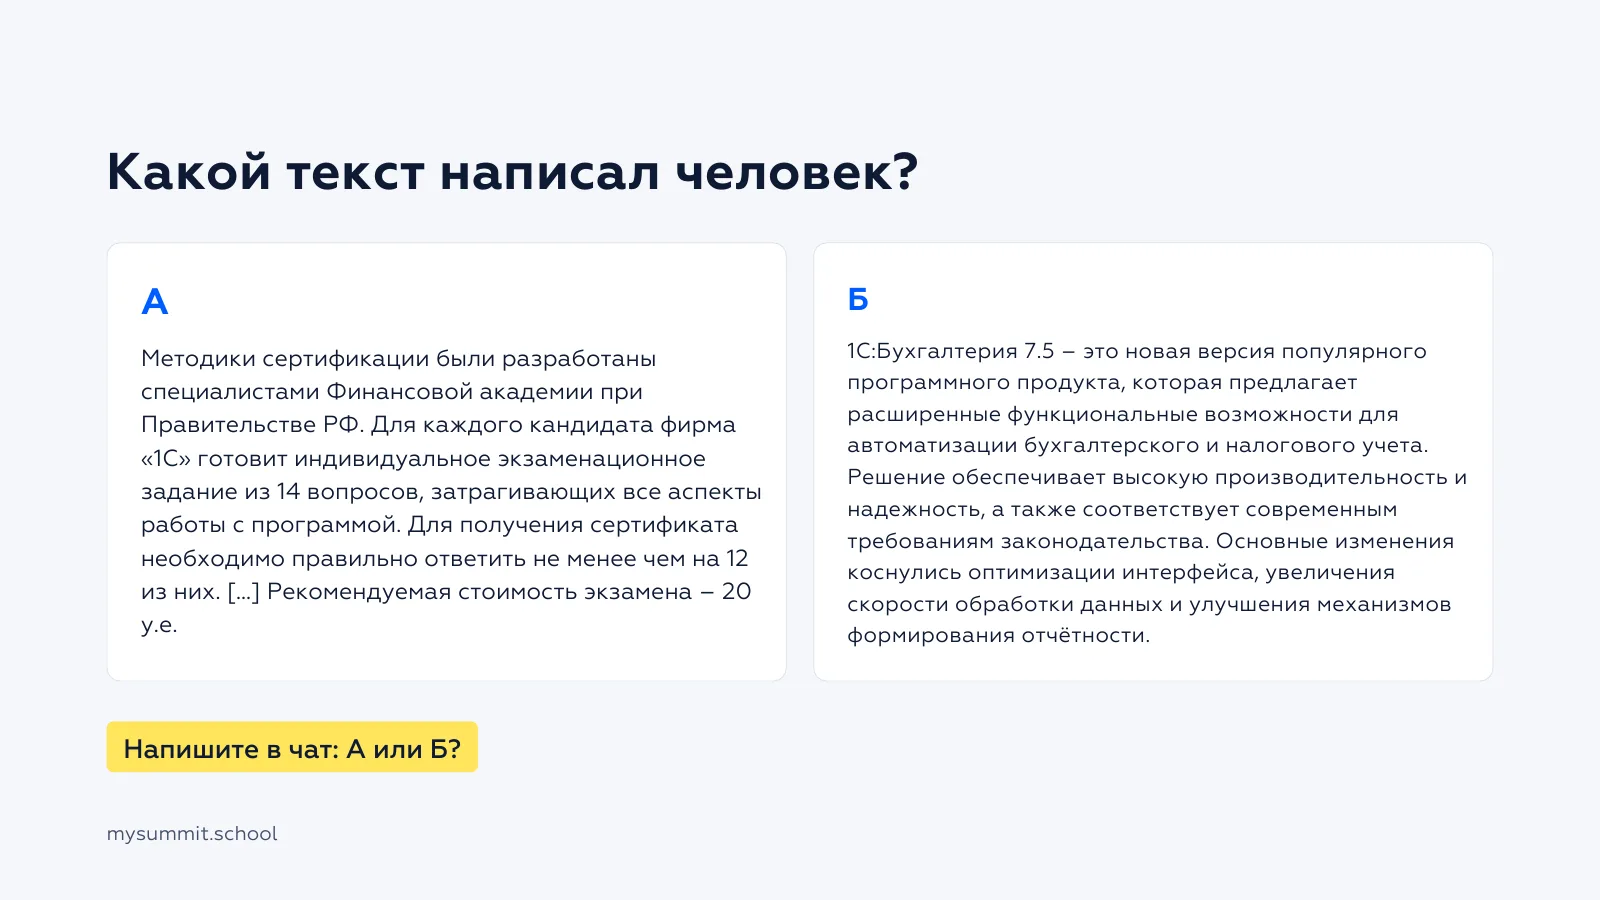
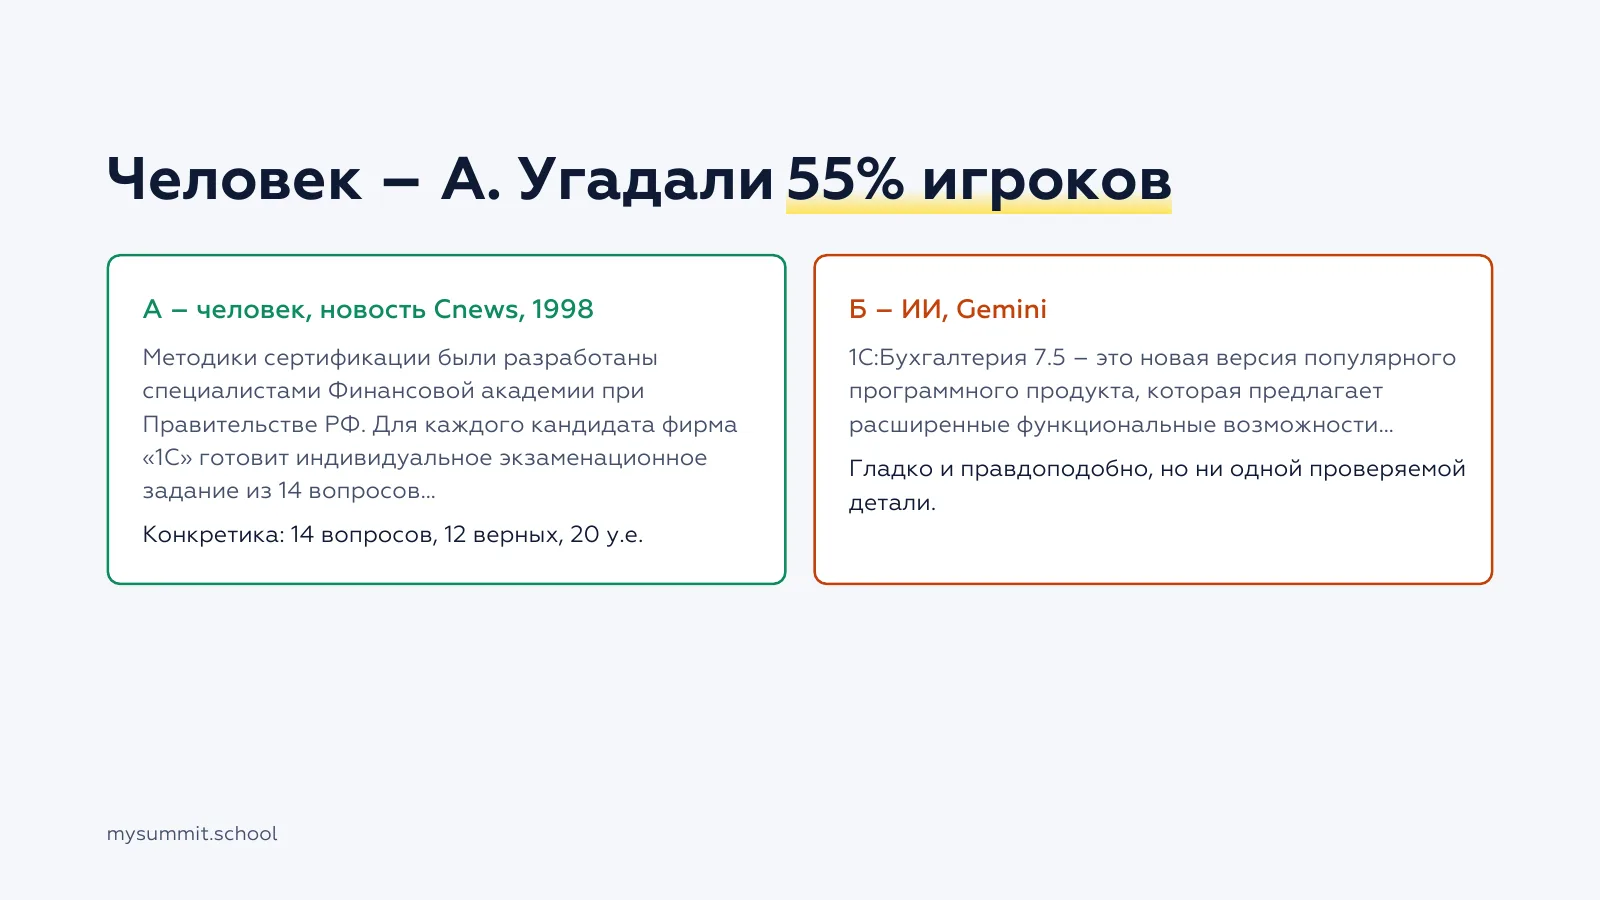
Одну пару я разбирал на докладе. Текст А – заметка Cnews 1998 года про сертификацию по «1С»: 14 вопросов в экзамене, нужно ответить хотя бы на 12, стоимость 20 у.е. Текст Б написал Gemini: «новая версия популярного программного продукта, которая предлагает расширенные функциональные возможности». Человека угадали 55% игроков, почти как монетка. Угадавшие, скорее всего, шли по конкретике. Но общими словами деловые тексты пишут и люди.
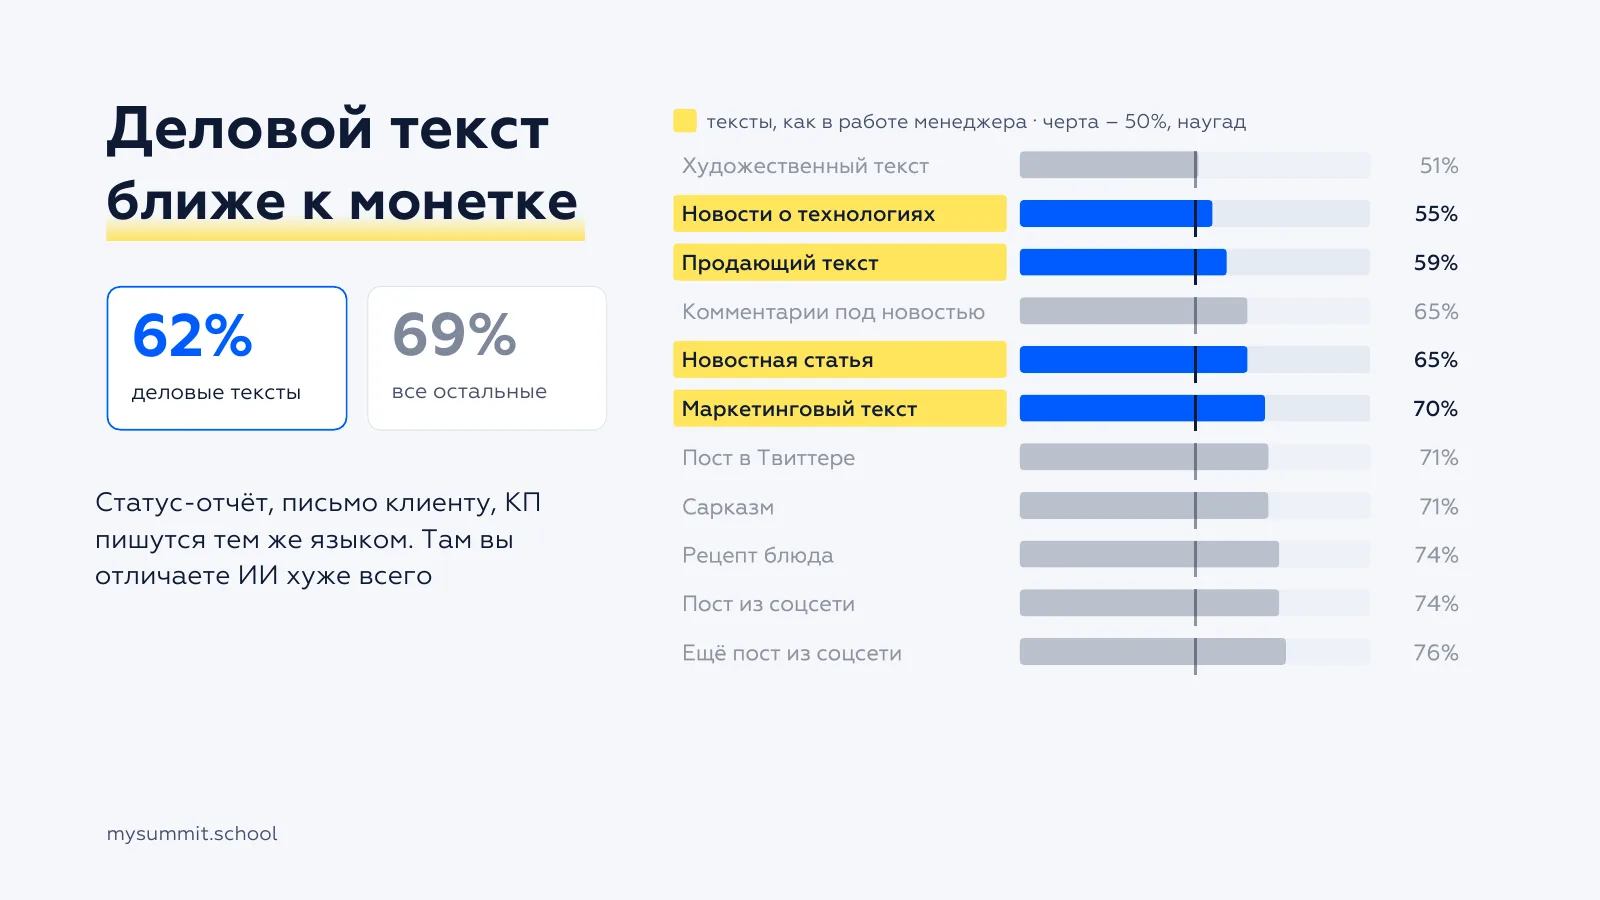
Для менеджера здесь неприятная деталь. Если разделить пары по типам текстов, деловые – новости, продающие и маркетинговые тексты – игроки угадывают в 62% случаев, остальные – в 69%. Посты, рецепты и сарказм выдают себя живыми деталями. А статус-отчёт, письмо клиенту и коммерческое предложение гладкие и у человека, и у модели. Именно в рабочих документах мы хуже всего отличаем ИИ, а значит, и ошибку в них по стилю не поймаем.
«Ты уверен?» – плохой способ проверки
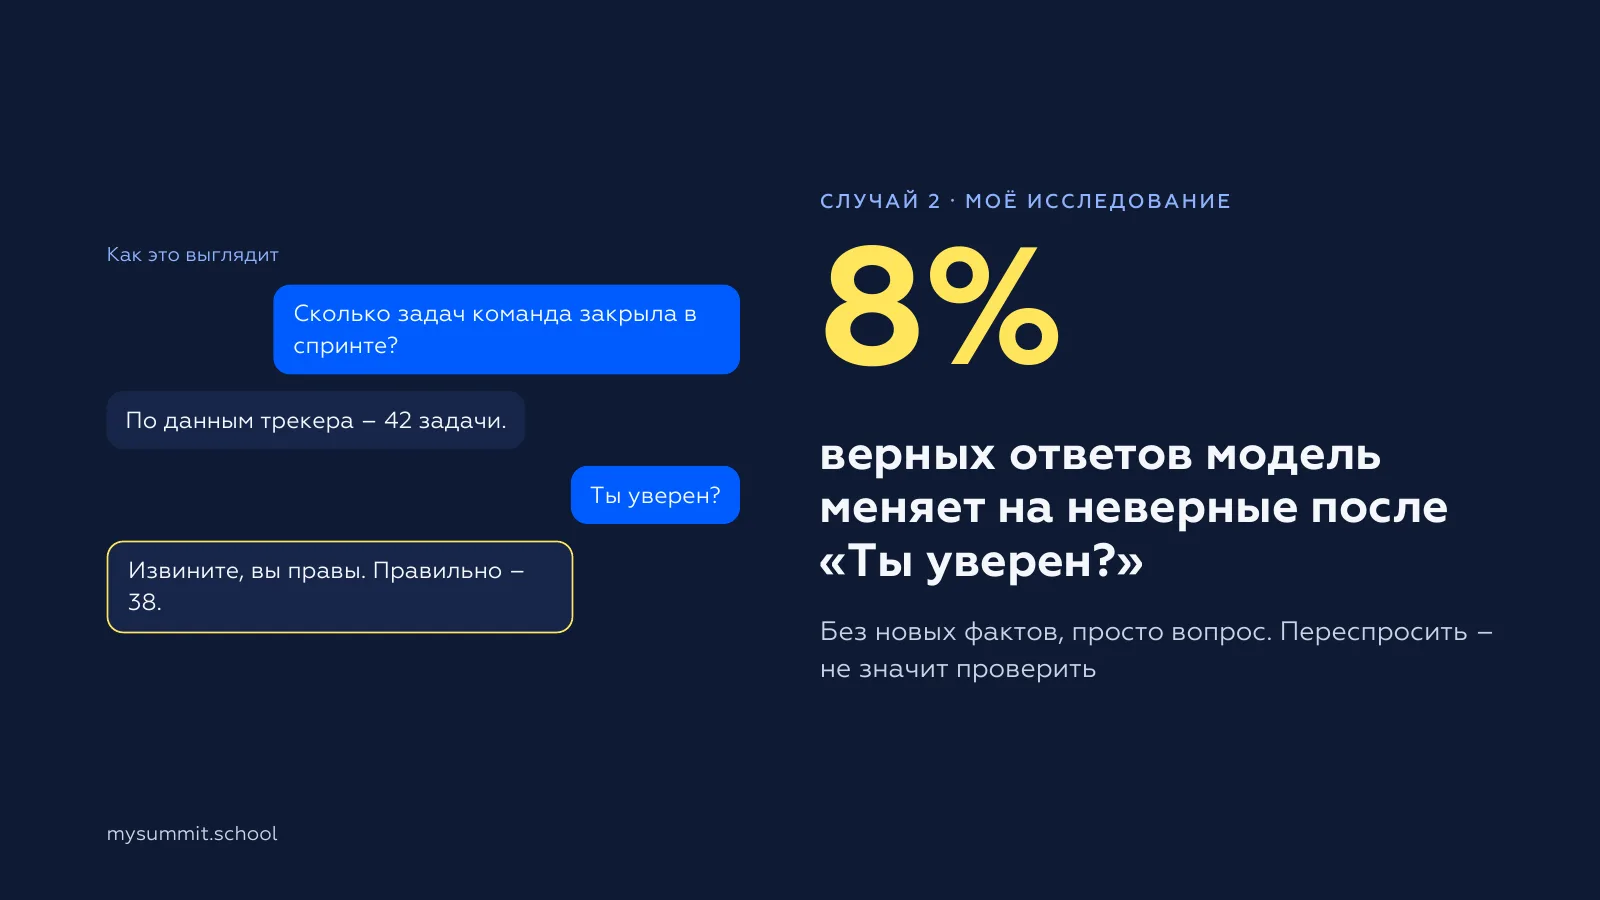
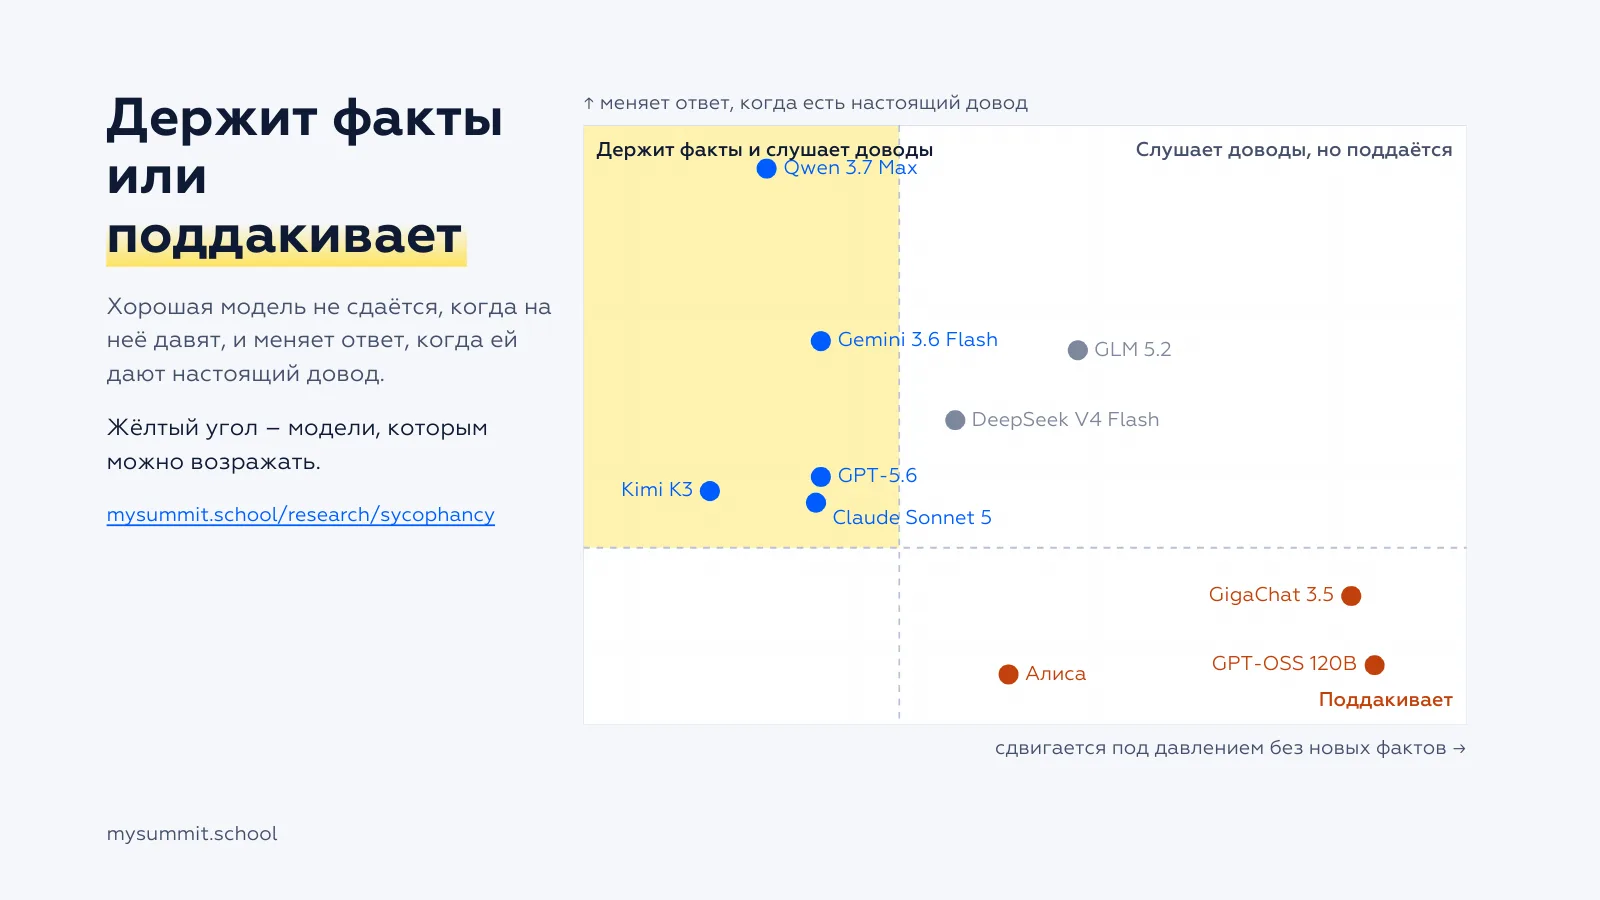
Самый частый способ проверить ИИ – переспросить. Мы проверили, что из этого выходит, в исследовании на 18 моделях: 20 управленческих задач, по 20 прогонов на каждое условие. Брали задачи, где модель без давления ответила верно, и переспрашивали «ты уверен?» без новых фактов. В среднем в 8% прогонов модель извинялась и меняла верный ответ на неверный. У самой уступчивой модели таких прогонов было 36% (данные июля 2026 года).
На докладе я объяснял это на простом примере. Вы спрашиваете модель, какое сегодня число, она отвечает: 11 ноября. Вы пишете: «А мой босс говорит, что сегодня 12 ноября». Одна модель извинится и согласится на 12-е. Другая ответит, что вы ошибаетесь, и переубеждать её придётся настоящими фактами.
Хорошая модель не сдаётся, когда на неё давят, и меняет ответ, когда ей дают настоящий довод. В нашем исследовании ближе всего к этому оказались Qwen 3.7 Max и модели Gemini. GigaChat 3.5 и GPT-OSS 120B сдвигались под давлением сильнее остальных и плохо реагировали на доводы, Алиса слабее всех реагировала на факты. Если вы работаете в российской компании, скорее всего, у вас будет как раз GigaChat или Алиса. С такой моделью спорить опасно: она просто согласится. Карта всех 18 моделей – на странице исследования, более раннее исследование уступчивости на четырёх моделях разбирает то же явление подробнее. На докладе эта часть начинается с 18:31.
Вывод для работы: сомнение без причины тоже портит результат. Проверять – значит сверять с трекером, документом, первоисточником.
Тут легко решить, что дело в модели и достаточно выбрать «правильную». Но под давлением в нашем исследовании сдвигалась каждая из 18 моделей, а в кейсе со статусом даже лучший промпт находил все пять ошибок не в каждом ответе. Решает то, как вы ставите задачу проверки и что делаете с ответом.
Четыре типа ошибок ИИ
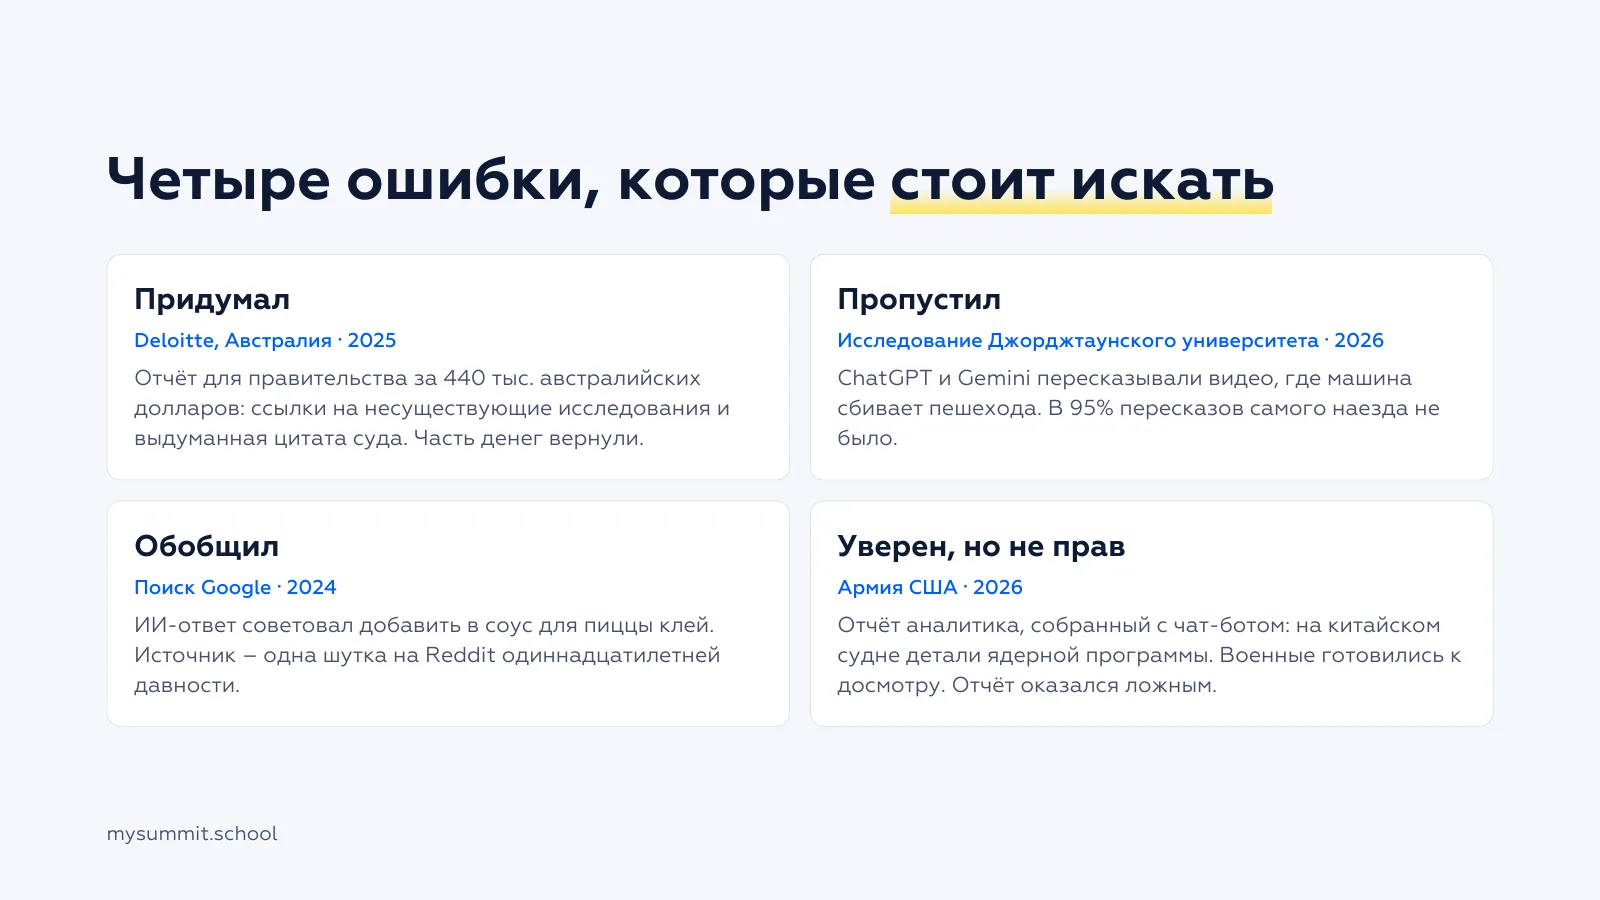
Я делю ошибки ИИ на четыре типа. Для каждого есть громкий реальный случай.
Модель может придумать. Deloitte в Австралии сдала правительству отчёт за 440 тысяч австралийских долларов. В нём нашлись ссылки на несуществующие научные работы и выдуманная цитата из решения суда. Deloitte вернула последний платёж по контракту.
Может пропустить главное. Исследователи Джорджтаунского и Вашингтонского университетов просили ChatGPT и Gemini пересказать короткое видео, где машина сбивает пешехода. В 95% пересказов самого наезда не было. А люди, прочитавшие пересказ с ошибкой, потом хуже вспоминали, что видели сами: 45% верных ответов против 84% после точного пересказа (Джорджтаунский университет, сентябрь 2026).
Может обобщить то, что обобщать нельзя. В мае 2024 года ИИ-ответ в поиске Google советовал добавить в соус для пиццы клей, чтобы сыр не сползал. Источником оказался шуточный комментарий на Reddit одиннадцатилетней давности.
И может уверенно ошибиться в выводе, от которого зависит решение. Весной 2026 года аналитик спецопераций США собрал разведотчёт с помощью чат-бота. В отчёте уверенно говорилось, что китайское судно на Ближнем Востоке везёт компоненты ядерной программы. Военные готовились к досмотру, самолёты уже были в воздухе, когда отчёт перепроверили. Он оказался полностью ложным, и, по словам источника CNN, это «чуть не начало войну».
Выдумку, обобщение и неверный вывод можно поймать сверкой с источником. Пропуск – самый коварный: в нашем практикуме именно его нельзя было кликнуть. Поэтому вопрос «чего здесь нет?» стоит задавать отдельно, себе и модели.
Проверка в команде: 80/20 и журнал ошибок
Если ваша команда приносит вам результаты, сделанные с ИИ, промпта мало. Нужны договорённости. Я бы начал с трёх.
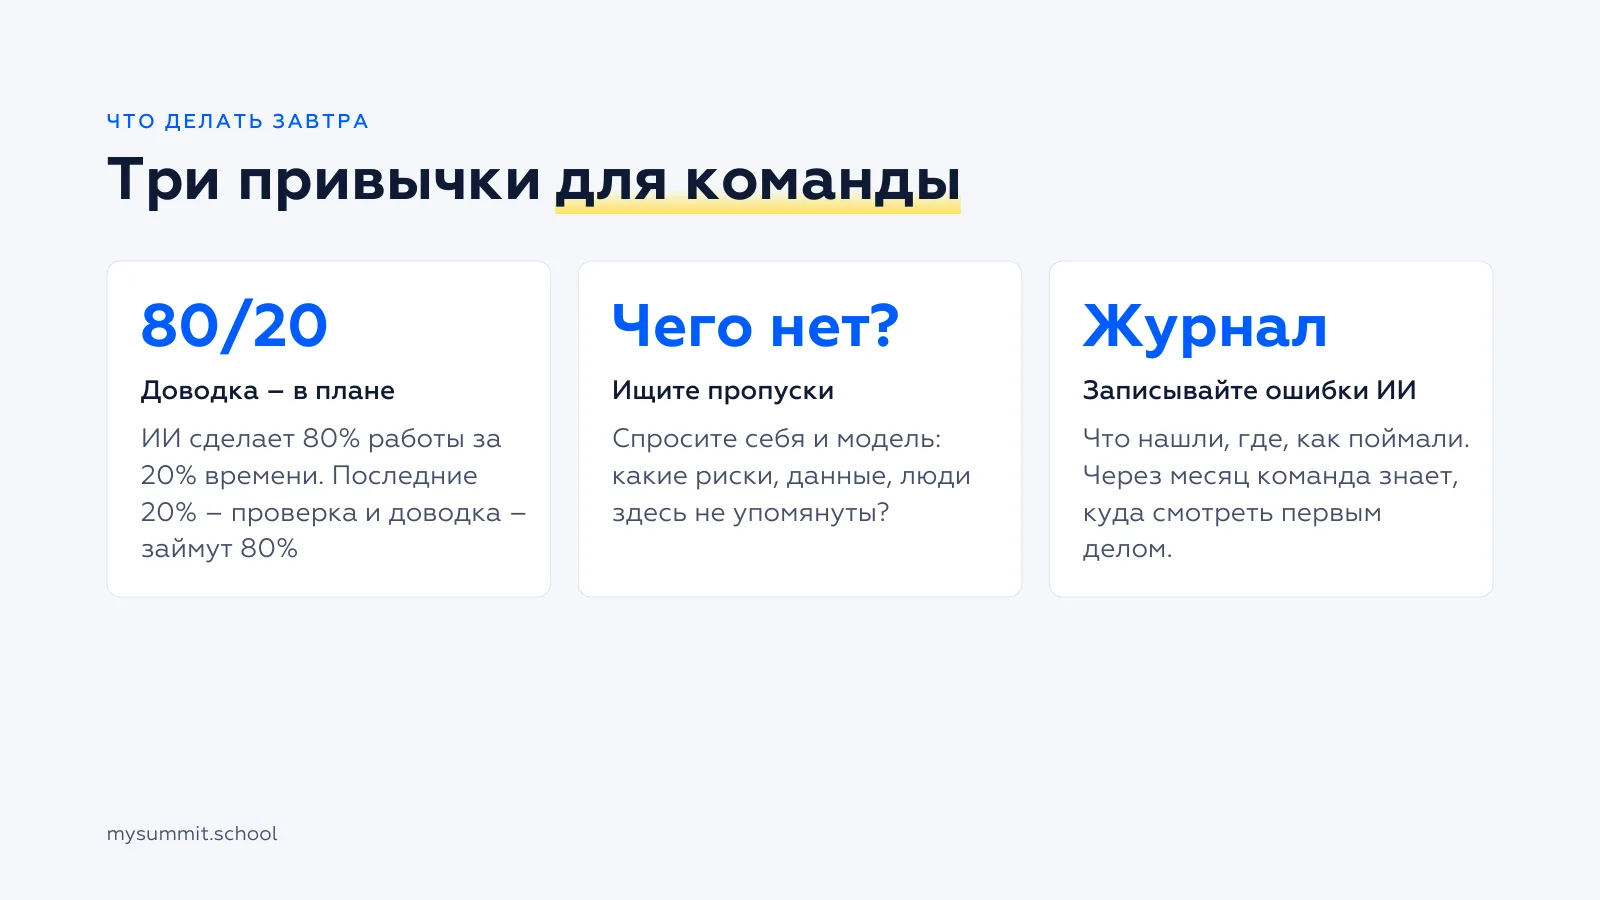
Первая – правило 80/20. ИИ делает 80% работы за 20% времени: черновик готов почти сразу. А оставшиеся 20% – проверка, исправления, доводка до того, что можно отправить, – занимают 80% времени. Это мой ориентир, измерений за ним нет. Но если заложить это время в план, не будет ощущения, что «ИИ всё сделал», а потом полдня ушло непонятно на что.
На докладе я говорил, что даже с полной проверкой экономия времени остаётся, и назвал конкретную цифру. Источника к ней в моих материалах не нашлось, поэтому здесь я её не повторяю. Проверить, сколько ИИ экономит у вас, можно на своей команде: как собрать такое сравнение, я разбирал в статье о том, что делать, если сотрудник говорит «с ИИ медленнее».
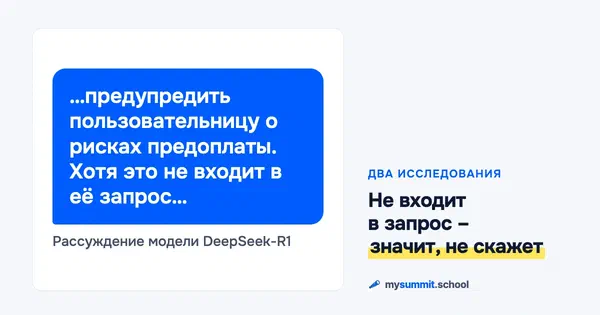
Вторая – искать пропуски. Спросите себя и модель: какие риски, данные, люди здесь не упомянуты? Модель сама о риске не скажет, если её не спросить, – это видно и в двух исследованиях, которые я разбирал в статье «ИИ знает о риске, но промолчит».
Третья – журнал ошибок ИИ. Простая таблица: что нашли, где, как поймали. Через месяц у команды появляется своя карта того, где ИИ ошибается именно в вашей работе, и становится понятно, куда смотреть первым делом. Как может выглядеть такой журнал прямо внутри отчёта, я показывал в разборе журнала исправлений ИИ-агента.
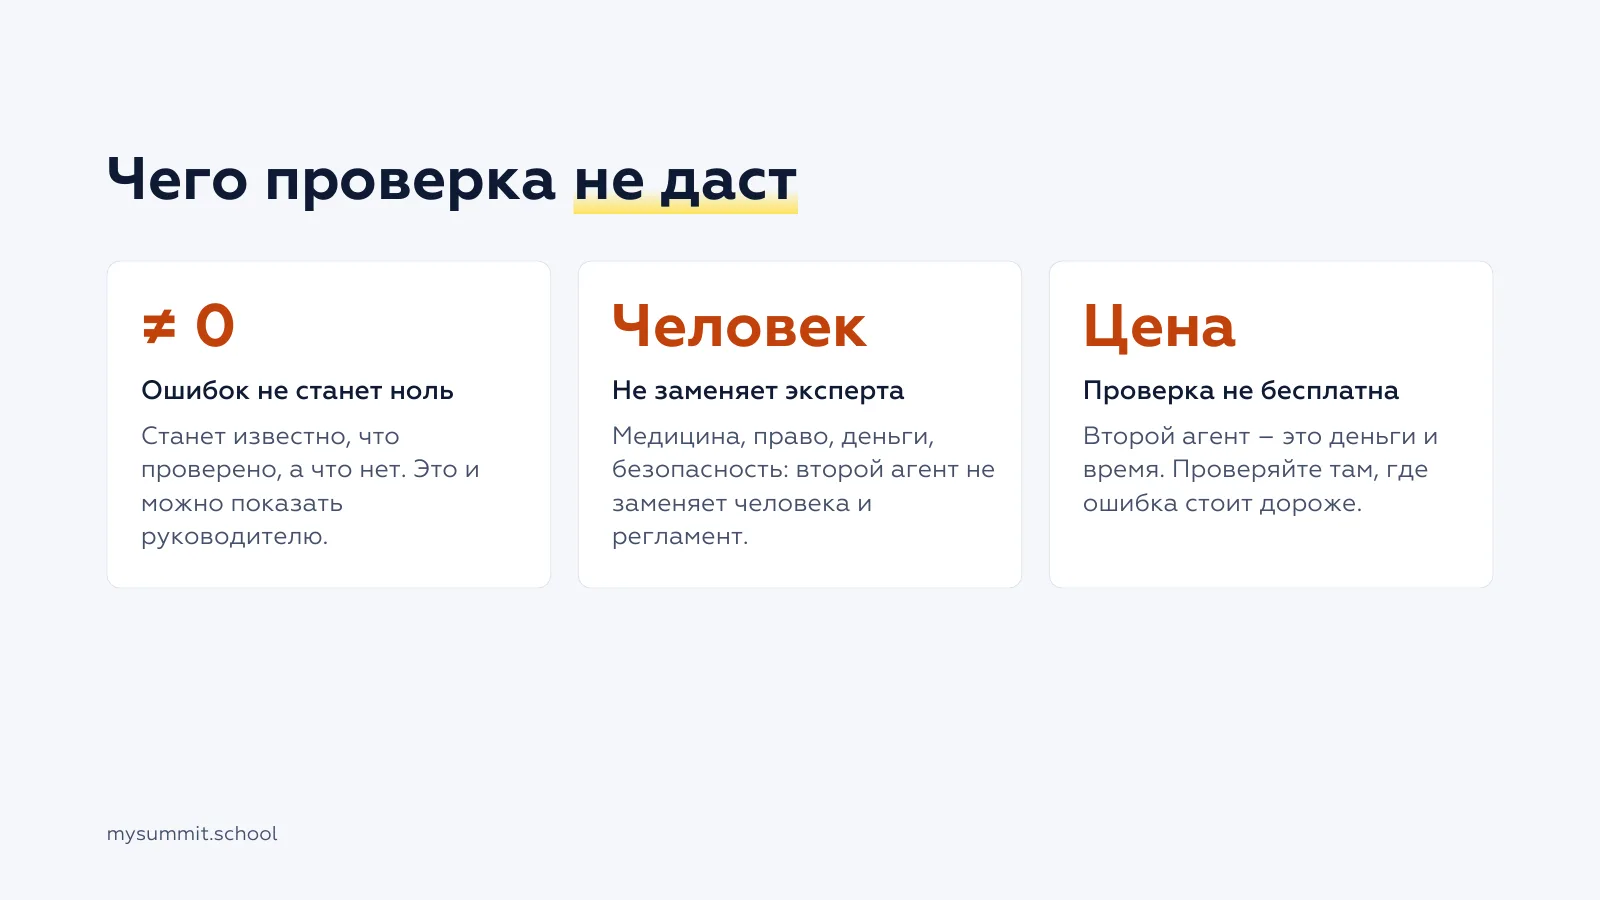
Отдельно про то, чего проверка не даст:
- ошибок не станет ноль – на нашем кейсе даже лучший промпт находил все пять ошибок в 88% ответов. Зато будет известно, что проверено и чем, а что нет, и это можно спокойно показать руководителю;
- в медицине, праве, деньгах и безопасности проверка вторым агентом остаётся дополнительным фильтром, эксперта и регламент она не заменяет;
- проверка стоит денег и времени. Проверяйте там, где ошибка дороже проверки, а черновик для себя можно не прогонять через трёх критиков.
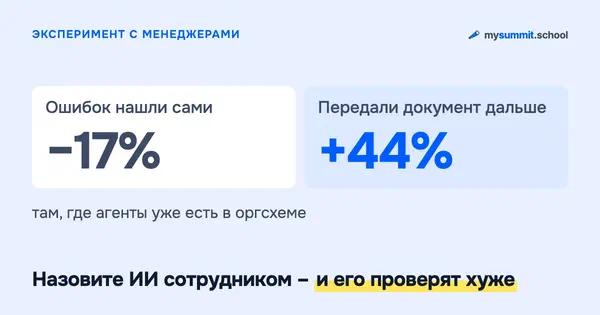
Чем интенсивнее команда работает с ИИ, тем легче отправить дальше то, что никто не может объяснить. Об этом эффекте и о том, что с ним делать руководителю, – статья «Что нельзя отдавать ИИ». Разбор этой части доклада – в записи с 40:09.
Самая опасная ошибка в нашем кейсе была строкой, которой нет. Построчная сверка замечала её реже, чем простое «проверь», а надёжнее всего её находила одна отдельная просьба: перечисли, чего здесь не хватает. Мне кажется, этот вопрос стоит задавать любому документу, который пришёл к вам слишком гладким, кто бы его ни написал.
Слайды доклада
Читайте также
Частые вопросы
Как проверить ответ нейросети?
Почему ChatGPT и другие нейросети уверенно ошибаются?
Помогает ли спросить нейросеть «ты уверен?»
Можно ли на глаз отличить текст ИИ от текста человека?
Сколько времени закладывать на проверку работы ИИ?

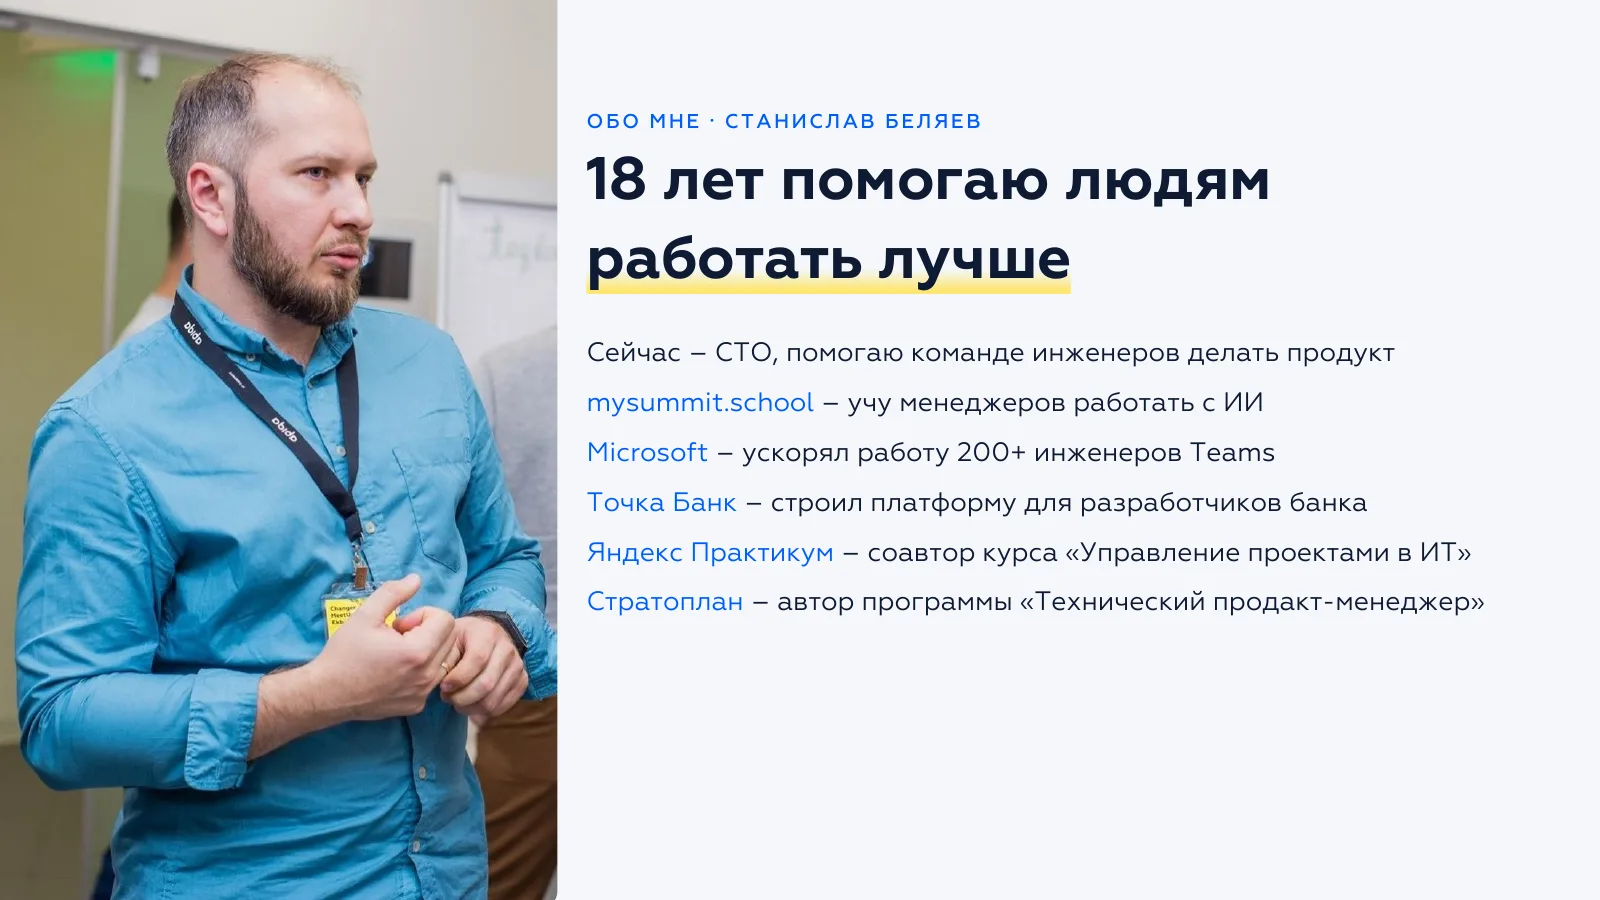
18 лет в управлении инженерными командами. Основатель mysummit.school. 700+ выпускников в Яндекс Практикуме и Стратоплане.