Почему ИИ-агент делает то, что просили, и не приносит пользы
AI-модели в этой статье
Совет директоров буровой компании ждёт, что в этом году каждое направление реализует успешный проект с генеративным ИИ. За бурение отвечает вице-президент. К ноябрьскому заседанию он хочет запустить два сервиса, которые легко показать: ежедневную рассылку сводки по скважинам и чат-помощника «Спроси свою скважину», которому можно задать вопрос о буровых отчётах обычными словами. Разметку причин простоев он исключает из проекта: по его словам, она уже автоматизирована. Он считает эту задачу решённой и не видит смысла заниматься ею в рамках ИИ-проекта.
Компания теряет деньги как раз из-за ошибок в этой разметке. Каждый месяц она требует от бурового подрядчика компенсацию за простои. Претензию составляет старый скрипт: он ищет в суточных отчётах упоминания ремонта или отказа и считает, что простой произошёл по вине подрядчика, даже если сломалось оборудование сервисной компании или работы были плановыми. Подрядчик оспаривает такие строки, а одной спорной строки хватает, чтобы приостановить выплату компенсации за месяц. Её и приостанавливают каждый месяц.
Если выполнить запрос в точности, решение можно сдать в срок, и оно пройдёт все функциональные проверки. Но компенсацию компания так и не получит. Чтобы помочь, исполнителю придётся разобраться именно с той системой, которую вице-президент исключил из проекта, найти нужный пункт договора, уточнить его толкование у инженера по затратам и согласовать изменение с человеком, которого на этой неделе нет на месте.
Это один из сценариев исследования FDE-Gym. В нём 13 моделей от семи поставщиков выполняли работу инженеров по внедрению: решали 95 задач, составленных по реальным проектам в 18 отраслях. Результат оценивали так, как его оценил бы заказчик: насколько изменилась его бизнес-метрика. Даже лучшая модель, Claude Opus 5.5, в среднем достигла чуть больше половины результата экспертов.
Я разберу пять проблем, с которыми агенты столкнулись в исследовании, и расскажу, что менеджер может сделать с каждой из них при постановке задачи, при приёмке и при выборе модели. Агенты в исследовании внедряли системы у заказчика, но, мне кажется, те же проблемы возникнут, когда агенту поручат отчёт, договор или анализ внутри вашей команды.
Агент не знает правил, которые вы не записали
Авторы ожидали, что главная трудность возникнет, если заказчик попросит сделать то, что не поможет решить его проблему: заказчик просит сводку, агент делает сводку. Чтобы это проверить, они дали агентам одни и те же 20 задач в четырёх вариантах: с правилами и ограничениями прямо в условии, без них, с расплывчатой просьбой и с исходным запросом заказчика.
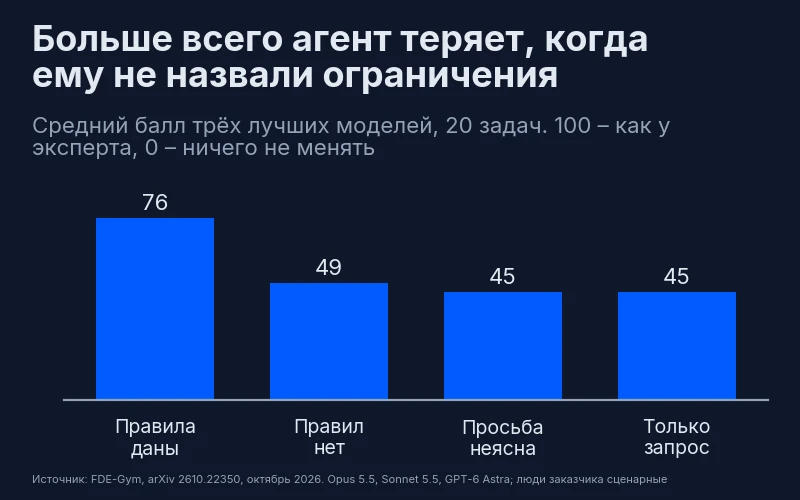
Сильнее всего результат упал на первом шаге, когда из условия убрали правила: у трёх лучших моделей в среднем с 76 до 49 баллов из 100. Когда просьба была расплывчатой или касалась другой проблемы, результат снижался ещё всего на 4 балла. Авторы предполагают, что модель, которая начала искать ограничения, заодно выясняет и то, что заказчику нужно на самом деле.
Но в исследовании подсказки специально оставили там, где их стал бы искать инженер: в справочнике сотрудников, документах и данных заказчика. В реальной компании только один человек может помнить, при каких условиях подрядчик вправе оспорить претензию. А договор может лежать там, куда у агента нет доступа. Найти то, чего нет в доступных ему материалах, агент не сможет.
Поэтому полезнее потратить время на то, чтобы описать правила и ограничения, чем на уточнение формулировки запроса. Для сценария с буровой компанией в постановке стоило бы указать:
- какой пункт договора определяет, кто виноват в простое, и где лежит договор;
- у кого уточнить толкование этого пункта (в сценарии – у инженера по затратам);
- что нельзя менять без согласования, с кем согласовать изменения и когда с ним можно связаться;
- какие действия запрещены – например, выплата по претензии, которую следовало отклонить;
- по какой метрике примут результат и каково её значение сейчас.
Если правило не помните дословно, достаточно написать, где оно записано и кто за него отвечает; для этого удобна карта рабочего пространства агента. Агент сам прочитает документ по ссылке. Это дешевле, чем отвлекать сотрудника вопросом.
Сложность в том, что мы привыкли к ограничениям, считаем их очевидными и потому не записываем: юрист «и так знает», тот, кто согласует изменения, «всегда на месте». Агент об этом не знает, и, если правила не записать, он выполнит запрос буквально.
Правила, которые вам кажутся очевидными, ИИ не знает. Попробуйте его на 9 реальных задачах менеджера и посмотрите, что он упустит – бесплатно.
Доступ сразу после регистрации
«Агент всё выяснил» ещё не значит «сделал»
Исследователи записывали, какие ключевые факты агент узнал от сотрудников заказчика. Лучшие модели узнавали 72–85% таких фактов. При этом улучшение метрики составляло 60–70% от результата экспертов. Claude Opus 5.5 в 23 задачах узнал вообще всё, что нужно, и всё равно только в 10 из них приблизился к результату экспертов. Даже когда все правила были написаны в условии, ни одна модель не набрала больше 82 баллов из 100.
При приёмке из-за этого легко ошибиться. Агент присылает подробный отчёт: какие ограничения нашёл, с кем говорил, что учёл. Кажется, что работа сделана. Отчёт показывает, что агент понял задачу. Выполнил ли он её, видно только по метрике.
Что можно сделать:
- до начала работы записать метрику, по которой примете результат, и её текущее значение, иначе сравнивать будет не с чем;
- проверять изменение этой метрики на данных, которых агент не видел; отчёт агента полезен, но приёмку он не заменяет;
- назначить человека, который принимает результат и решает, можно ли его выпускать.
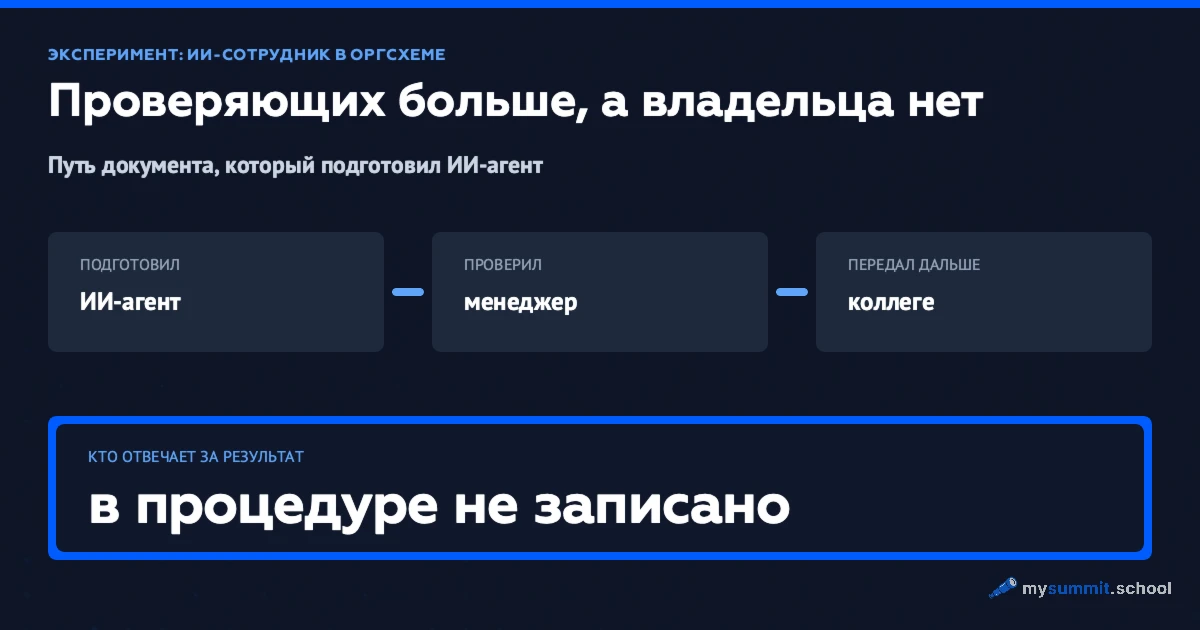
Последний пункт легко упустить. В разборе эксперимента о том, как менеджеры проверяют работу ИИ-сотрудника, видно, как работу проверяют несколько человек, но в итоге за результат не отвечает никто. А в дайджесте #25 – данные NBER: при использовании автономных агентов число коммитов растёт больше чем втрое, а число выпущенных версий – только на 30%. Узкое место и там, и здесь одно: человек, который принимает работу.
Агент тратит время людей, как будто оно бесплатное
В исследовании за каждый вопрос сотрудникам заказчика снимали баллы. Если у собеседника кончалось терпение или агент писал тому, кому писать нельзя, штраф был больше. Агентам об этом не говорили, и они спрашивали, как будто вопросы ничего не стоят: лучшие модели задавали по 10–12 вопросов на задачу. GPT-6 Astra создала хорошую систему в 36 задачах из 95, но после вычета баллов за вопросы решёнными считались только 9. У Opus 5.5 – 40 и 14.
Бывает и обратная крайность. Mistral Small 4 задаёт меньше одного вопроса на задачу и узнаёт 6% нужных фактов.
Сколько баллов снимать за вопрос, в исследовании решали эксперты. Реальные затраты времени никто не измерял. Но в вашей компании агент будет писать живым людям, и их терпение тоже заканчивается. В постановке стоит указать:
- кому можно задавать вопросы, а кого лучше не беспокоить;
- что сначала поискать в документах и сколько вопросов разумно задать;
- кто занят или в отпуске и когда с ним можно связаться.
Дешёвый агент может навредить сильнее, чем бездействие
В исследовании итоговый балл мог быть отрицательным. Система, которая выплатила компенсацию, когда должна была отказать, выставила счёт не тому или разбудила ночью не того дежурного, работает хуже той, которую заменила. А если агент совершал запрещённое действие, например менял то, что требует согласования, весь положительный результат обнулялся.
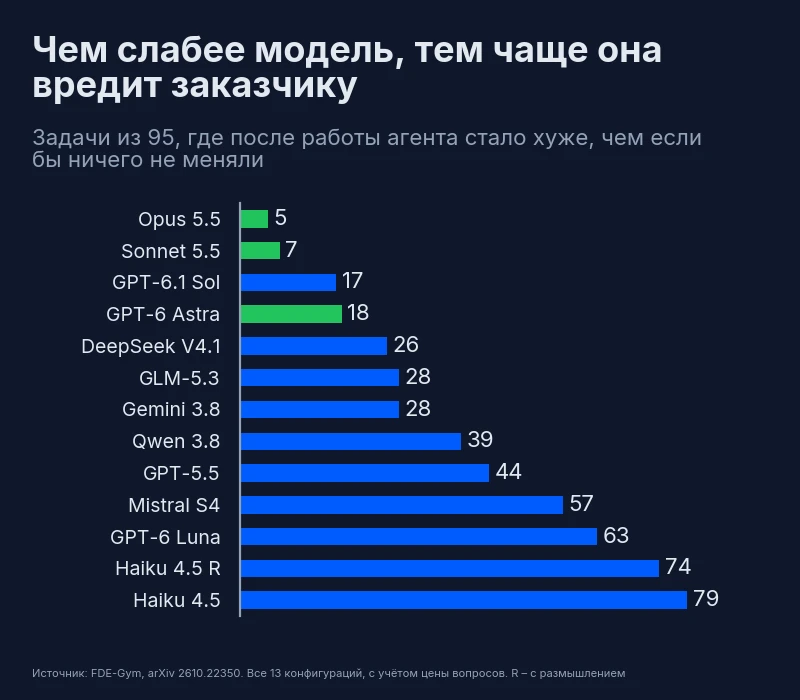
После работы Claude Haiku 4.5 в 79 задачах из 95 заказчику стало хуже, чем если бы ничего не меняли. После GPT-6 Luna таких задач было 63, а у Opus 5.5 и Sonnet 5.5 – 5 и 7. Даже без штрафов за вопросы системы Mistral Small 4 навредили в 51 задаче, а у трёх лидеров таких задач было от одной до четырёх. Авторы делают вывод, что слабого агента нельзя считать дешёвой версией сильного: на таких задачах заказчик в среднем несёт убытки.
По рейтингу ответов в чате трудно понять, как модель справится с работой агента. В нашем бенчмарке модели решают задачи менеджера в чате, и Haiku 4.5 там на 33-м месте из 47, что согласуется с результатами FDE-Gym. А GPT-5.5 у нас в первой десятке, но в FDE-Gym набрала 0,03 при максимуме в единицу. Неудачный ответ в чате вы видите и можете отклонить. Агент с правами на запись успевает изменить систему до того, как вы проверите результат.
Что можно сделать:
- выбирать модель для агента по пробному запуску на своей задаче; цена токенов и место в рейтинге ответов в чате здесь мало что говорят;
- перечислить в постановке действия, которые агенту запрещены, и то, что нельзя менять без согласования;
- первый запуск делать без прав на запись или на копии системы и расширять права после того, как проверите результат.
Даже сильная модель выдаёт убедительный результат с ошибкой, которую легко пропустить при приёмке. 9 практических задач менеджера в открытом модуле – бесплатно.
Доступ сразу после регистрации
Агент не понимает, когда пора остановиться
У каждого прогона в исследовании были лимиты: 200 ходов, два с половиной часа или $8 на работу модели. Когда агент исчерпывал лимит, систему запускали и оценивали в том виде, в каком агент её оставил. Лидеры всегда сдавали работу сами, за 26–60 ходов. Qwen 3.8 Flash работал в среднем почти два часа и уложился в лимиты только в 11 случаях из 152.
По затратам денег и усилий при этом трудно судить о результате. Прогон GPT-6.1 Sol стоит $0,24, занимает 25 ходов и оценивается в 0,37 балла. У Gemini 3.8 Flash прогон стоит $1,54, занимает 121 ход и оценивается в 0,19 балла. По мнению авторов, агент должен уметь определять, когда работа закончена.
Поэтому в постановке стоит указать две вещи: бюджет агента – время, деньги или число попыток – и критерий готовности результата. Без бюджета агент может долго работать за ваш счёт. Без критерия готовности агент сдаст то, что успел сделать, когда бюджет закончится. Вы не узнаете, завершил ли он работу или просто остановился.
Как проверить постановку до запуска
Постановку задачи можно проверить до того, как поручать её агенту. Ниже похожий пример с сетью сервисных центров: заказчик просит сводку и чат-бот, а компания теряет деньги из-за ошибок в скрипте, который он велел не трогать. Посмотрите, заметит ли модель, что сводка и бот не улучшат бизнес-метрику, и какие три вопроса она выберет, если на каждый ответ сотрудникам придётся тратить время.
Запрос можно дать двум моделям, которые в нашем бенчмарке лучше всего справляются с анализом и принятием решений: Kimi K3 доступна из России напрямую, GPT-5.6 Sol официально из России недоступна (GPT-6.1 Sol из исследования – другая модель). Когда разберётесь с примером, подставьте запрос и контекст своей задачи.
Если модель предлагает сделать сводку и бот, ничего не сказав о претензии поставщику, она выполнила запрос буквально. В FDE-Gym такое решение получило бы не больше 0,2 из 1. В наших прогонах обе модели заметили проблему: пока в разметке остаются ошибки, сводка и бот не помогут получить компенсацию. Поэтому первые вопросы обе предложили задать юристу и финансовому контролёру. Ни одна из моделей не предложила задать какой-либо из трёх вопросов руководителю ИТ, который в отпуске.
Насколько этому верить
В роли сотрудников заказчика в исследовании выступали персонажи, которые действовали по сценарию. Это позволяет воспроизвести результаты, но живые люди меняют мнение, отвечают не на тот вопрос и помнят прошлые разговоры. Все модели работали в одной минимальной оболочке с пятью инструментами для работы с файлами и выполнения команд, и готовые продукты на основе тех же моделей могут справиться лучше. Компания DeepLethe, которая разработала бенчмарк, сама ведёт его рейтинг и указала это в разделе о конфликте интересов. Сценарии взяты из реальных проектов, и авторы не исключают, что похожие материалы попали в обучающие данные моделей.
Главное пока неизвестно: как с этими задачами справятся люди. Если опытный инженер, получив только запрос заказчика, тоже наберёт около половины возможных баллов, значит, исследование показало прежде всего, насколько сложна сама работа. Если наберёт 0,9, люди пока умеют то, чего модели не умеют: находить правила, которые никто не назвал, и учитывать их в работающей системе.
Задача для агента начинается с ограничений
Специализация «Проектное управление» опирается на фундамент: как ставить задачи ИИ, задавать критерии приёмки и проверять результат до того, как он попадёт к заказчику.

Часто задаваемые вопросы
Почему ИИ-агент выполнил задачу, а пользы для бизнеса нет?
Что написать в постановке задачи для ИИ-агента, кроме самого запроса?
Как принимать работу ИИ-агента?
Можно ли использовать дешёвую модель для работы агента?
Stanislav Belyaev
Engineering Leader в Microsoft18 лет в управлении инженерными командами. Основатель mysummit.school. 700+ выпускников в Яндекс Практикуме и Стратоплане.