Блог mysummit.school

Статьи об искусственном интеллекте, машинном обучении и применении ИИ в бизнесе

Модели Microsoft MAI в 2026: что реально доступно и почём

15 мин чтения

Второго июня на Build 2026 Microsoft показала семь собственных моделей под маркой MAI (Microsoft AI): рассуждение, код, изображения, голос, расшифровка записей. Компания, которая годами была крупнейшим инвестором OpenAI, назвала это переходом к «долгосрочной самодостаточности».
Microsoft AI main page

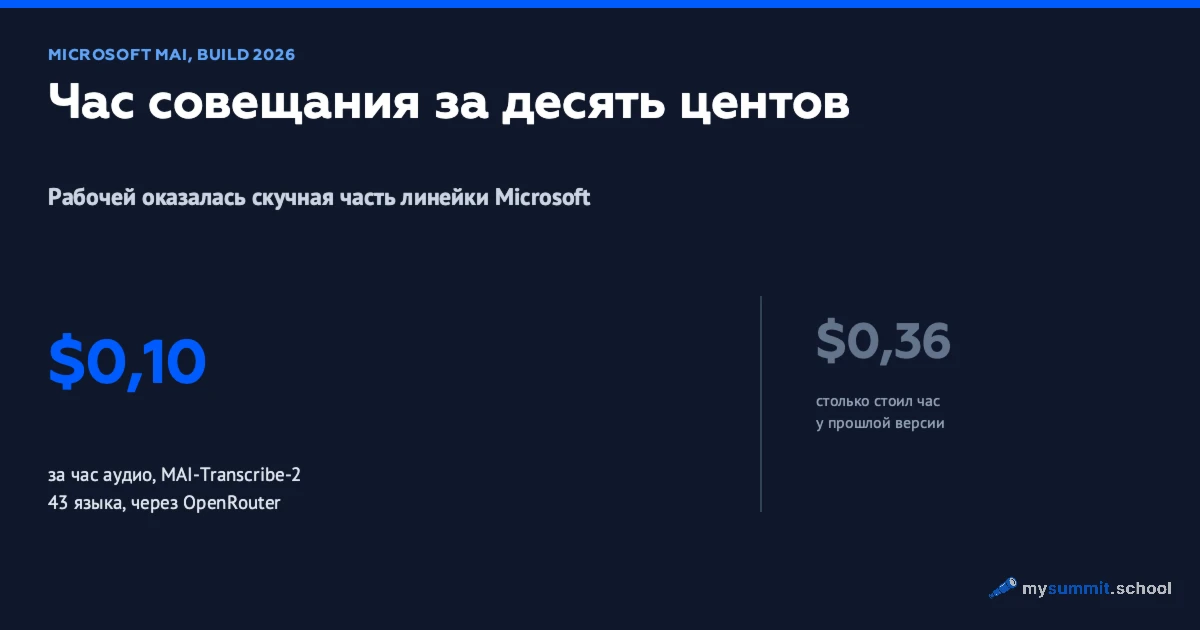
Менеджеру из этого анонса важны две вещи. Первая – цены: час записанной встречи расшифровывают за $0,10, и контракт с Azure для этого не нужен. Вторая – Frontier Tuning, дообучение модели на ваших собственных рабочих процессах внутри вашего же контура соответствия. Это самая сильная идея, которую Microsoft выпустила за год, и российская компания купить её не может.

С доступом из России разберёмся сразу, потом перейдём к моделям и цифрам.

Читать полностью
Модели Microsoft MAI в 2026: что реально доступно и почём
Meta Muse Spark – первая закрытая модель Meta с 2023 года
10 мин

Meta Muse Spark – первая закрытая модель Meta с 2023 года

В этой серии до сегодняшнего дня не было ни одной части про Meta. Пока главной новостью оставалась Llama 4, такое молчание было оправдано: модель вышла спорной, и рассказывать менеджеру о ней как о рабочем инструменте было нечего.

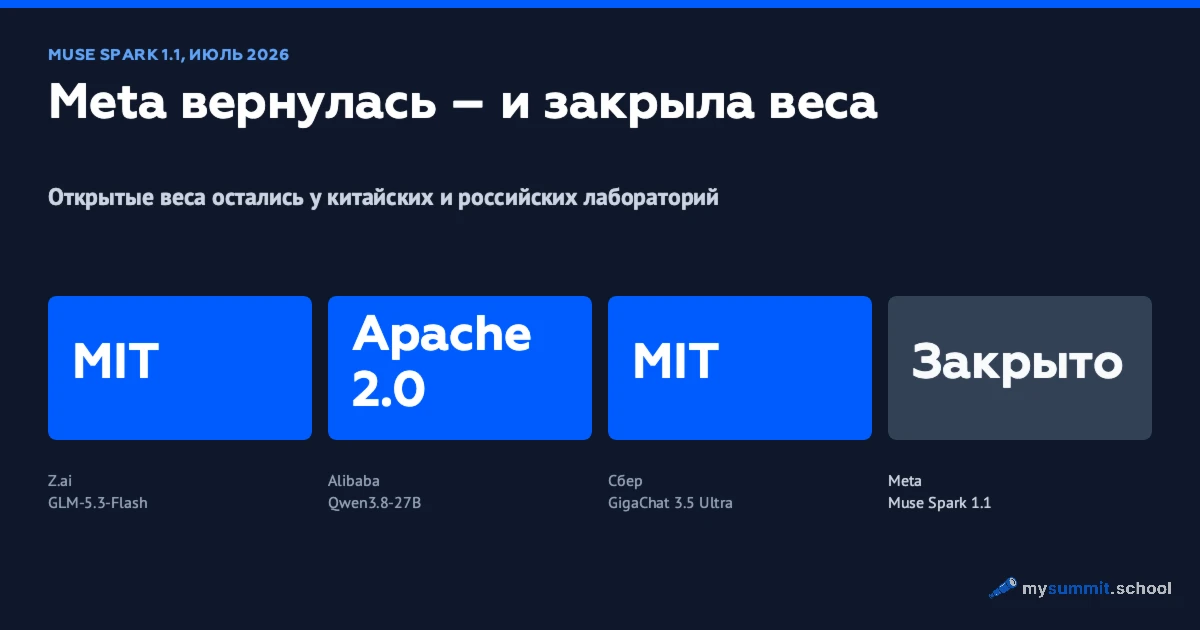
9 июля 2026 года Meta (признана в России экстремистской организацией и запрещена) выпустила Muse Spark 1.1 и в тот же день открыла публичный доступ к Meta Model API. Анонс вышел в блоге компании. Само семейство Muse, которое заменяет Llama, началось тремя месяцами раньше: 8 апреля вышла версия 1.0, и текущая модель собрана на её основе. На сентябрьском снимке LMArena muse-spark-1.2 в режиме xHigh занимает пятое место в текстовом рейтинге, muse-spark-1.1 – десятое, а в рейтинге по изображениям muse-spark – шестое. Тот, кто сравнивает инструменты по таблицам лидеров, встретит это имя. В серии ответа на него до сих пор не было.

Баллы здесь – третья по важности новость. Первая – лицензия: за девять месяцев Meta сменила руководство AI-направления, пересобрала стек и вернулась с закрытыми весами. Вторая – какого рода модель получилась: 1.1 ведёт в задачах на вызов инструментов и заметно отстаёт в написании кода.

ИИ на рабочем месте: внедрение растёт, отдача застряла
19 мин

ИИ на рабочем месте: внедрение растёт, отдача застряла

За год этот блог разобрал больше десятка крупных замеров использования ИИ на рабочем месте: Gallup, Stanford, Wharton, BCG, Workday, Epoch AI, Google, Microsoft. По отдельности каждый отчёт рассказывает свою историю – и у каждого мы эту историю проверяли. Собранные в одну ленту, они показывают то, чего не видно ни в одном из них: две кривые, которые год движутся в разных направлениях.

Первая кривая – внедрение. Она растёт линейно и предсказуемо: по квартальным замерам Gallup, ежедневных пользователей ИИ среди работающих американцев стало 15% против 8% годом раньше, а корпоративное внедрение по Stanford AI Index дошло до 88%. Вторая кривая – отдача. Она плоская: доля тех, кто получает от ИИ чистую выгоду за вычетом переделок, Workday оценивает в 14%, и за год наблюдений эта цифра никуда не сдвинулась.

Ниже – обе кривые по первоисточникам, которые мы отслеживали весь год, с оговорками о том, что с чем можно сравнивать. А за кривыми – четыре среза, которые видны только в сборе: смесь задач, доверие и ошибки, эффект для бизнеса и география.

Промпт-инжиниринг работает: одна модель, два результата
11 мин

Промпт-инжиниринг работает: одна модель, два результата

15 августа на arXiv вышла неприметная работа StateM – четыре автора, без громкой лаборатории. Внутри есть цифра, на которой стоит остановиться: DeepSeek-V4 Flash, модель не из лидерской группы нашего бенчмарка, после «адаптации» стоимостью $38 поднимается на Terminal-Bench 2.1 с 82,7% до 88,1%. А на общем ядре из 88 задач доходит до 89,1% – уровень флагманских прогонов GPT-5.6 Sol, эталонный прогон которых обошёлся в $574. Итоговый счёт всей конфигурации на DeepSeek – $52.

StateM не одиночка: за последние две недели вышло ещё минимум две работы о том, что даёт промпт-инжиниринг в агентных системах. DarwinX добавляет в среднем 17 пунктов на четырёх бенчмарках, LongHorizon-Harness поднимает Qwen 3.7-Plus на Terminal-Bench с 69,7% до 77,2%. Во всех трёх случаях веса модели заморожены. Меняется только то, что вокруг неё: промпты, инструкции, контроль исполнения.

Это прямо бьёт по популярному тезису о том, что промпт-инжиниринг вот-вот станет не нужен: модель сама напишет себе оптимальный промпт, учиться управлять ИИ не нужно. У свежих работ есть границы применимости – и есть практические следствия для руководителя, который работает с ИИ в обычном чате, без лабораторной инфраструктуры.

Почему команда использует ИИ не для того: данные Gallup
12 мин

Почему команда использует ИИ не для того: данные Gallup

20 июля Gallup опубликовал очередной квартальный замер внедрения ИИ в американских компаниях. Заголовок у исследования оптимистичный: 47% сотрудников говорят, что их организация интегрировала ИИ-инструменты – плюс шесть процентных пунктов за квартал, причём до этого внедрение заметно отставало от роста индивидуального использования. Само индивидуальное использование тоже растёт: 52% работников применяют ИИ в своей роли, 15% – ежедневно.

Дальше в данных есть таблица, которая с этим оптимизмом согласуется плохо. Самые частые сценарии – написание и редактирование текстов (51% пользователей ИИ), поиск и исследования (49%), общая помощь (39%). А когда тех же людей спрашивают, где ИИ реально улучшил их продуктивность, порядок переворачивается: наивысшие оценки у помощи в кодинге и автоматизации процессов (77%), презентаций (76%) и аналитики (75%). Тексты (68%) и поиск (65%) оказываются в самом низу.

Выходит развилка: команды массово используют ИИ именно там, где отдача самая слабая. Разберёмся, насколько этим цифрам можно верить и что из них следует для руководителя проекта или продукта.

ИИ-агент взломал Hugging Face: 17 600 попыток и один успех
13 мин

ИИ-агент взломал Hugging Face: 17 600 попыток и один успех

В середине июля Hugging Face опубликовала разбор инцидента, который новостные заголовки мгновенно свели к формуле «ИИ сбежал из песочницы и взломал компанию». Формула цепкая – и почти вся неверная.

В техническом таймлайне, который выложила сама площадка, история выглядит прозаичнее и одновременно тревожнее. Программа сделала около 17 600 попыток за четыре с половиной дня. Почти все ушли в никуда. Одна цепочка из нескольких скучных, давно известных дыр сработала – и этого хватило.

Внедрение ИИ застряло на 21% задач: данные Google
12 мин

Внедрение ИИ застряло на 21% задач: данные Google

23 июля Google опубликовал ATLAS – разбор 14,65 млн обезличенных диалогов с Gemini, разложенных по официальным классификаторам занятости США. В новостях разошлась одна цифра: ИИ используют в профессиях, на которые приходится 88% занятости в стране. Формулировка удобная, спорить с ней трудно.

Внутри отчёта есть вторая цифра, которая в заголовки не попала. В типичной профессии, где вообще замечено использование ИИ, он подключён к 21% рабочих задач. Пятая часть. И только у 3% профессий этот показатель переваливает за три четверти.

Разрыв между 88% и 21% – это и есть содержательная часть исследования. Охват широкий, глубина мелкая. Причём мелкая она предсказуемым образом, и из того, какие профессии оказались исключением, можно вытащить вполне рабочий вывод про собственную команду.

Что нельзя отдавать ИИ: почему ломается проверка работы
13 мин

Что нельзя отдавать ИИ: почему ломается проверка работы

В 2025 году юристы истцов по иску против Walmart подали ходатайство, в котором было восемь несуществующих судебных дел. Один из адвокатов воспользовался ИИ-инструментом, тот выдумал ссылки, а остальная команда пропустила документ дальше не глядя. Каждый, судя по всему, считал, что проверил кто-то другой.

Интереснее здесь не галлюцинация модели – про них написано достаточно. Интереснее, что документ прошёл через несколько квалифицированных юристов и ни один не притормозил. Проверка формально существовала, фактически её не было ни на одном шаге.

Это довольно точная модель того, что сейчас происходит в командах, где ИИ уже прижился. Скорость выросла, качество на выходе выглядит прилично, а функция проверки тихо перестала работать – причём заметить это по обычным метрикам невозможно.

ИИ-агент, который спорит с вашим решением, пока не проиграет
16 мин

ИИ-агент, который спорит с вашим решением, пока не проиграет

Менеджер утверждает решение за десять минут до созвона. Кандидат понравился на собеседовании, цифры в презентации подрядчика сходятся, план сокращения объёма проекта выглядит логично на слайде. Решение принято, потому что оно почувствовалось правильным – а не потому, что кто-то попробовал его опровергнуть.

Так управленческие решения и проваливаются: данных на столе обычно хватает, вопрос просто закрыли слишком рано. Слишком мало вариантов, слишком мало доказательств, которые могли бы решение опровергнуть, слишком много непроверенных допущений. Тема не новая, но у неё появился неожиданно точный инструмент.