Промпта оказалось недостаточно: что Гарвард добавил к GPT-4, чтобы он начал учить
В 2023 году студенты вводного курса физики в Гарварде прошли одно из двух занятий с ИИ-репетитором на базе GPT-4. Медиана их результата в тесте после занятия составила 4,5 балла. После аудиторного занятия с активным обучением медиана была 3,5 балла, при общей исходной медиане 2,75 балла.
Различие статистически значимое: z = -5,6, p < 10⁻⁸. По квантильной регрессии, которая лучше справлялась с особенностью этих данных, размер эффекта находился в диапазоне от 0,73 до 1,3 стандартного отклонения. Заголовок почти пишет себя сам: ИИ обошёл занятие в Гарварде. Работа Кестина и коллег вышла в Scientific Reports, а данные и код анализа авторы выложили целиком – проверить расчёты можно самостоятельно.
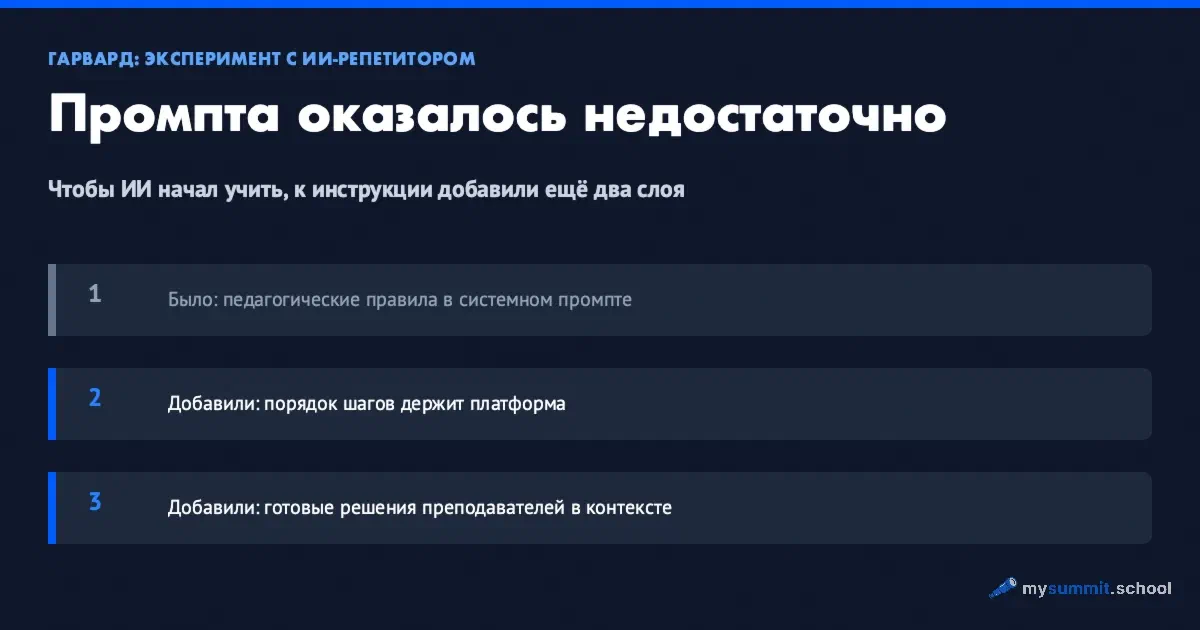
Только полезный для менеджера вывод начинается на один уровень глубже. Студенты работали со специально собранной системой, где GPT-4 отвечал внутри жёсткой последовательности, видел заранее написанные решения и следовал педагогическим правилам. Системный промпт был лишь одним компонентом. Причём один важный компонент пришлось из него вынести.
С чем на самом деле сравнивали ИИ
Контролем служила не пассивная лекция. В аудитории студенты разбирали задания небольшими группами, задавали вопросы и получали точечную обратную связь от сотрудников курса. Два занятия вели разные преподаватели, и студенческие оценки обоих были выше средних по кафедре и по факультету.
Соперник был сильным.
Авторы дополнительно спросили студентов, насколько часто на этом курсе применялось активное обучение по сравнению с другими естественно-научными курсами Гарварда. По ответам самих студентов, 89% видели здесь больше активного обучения. Такой контроль трудно назвать удобным слабым соперником.
Эксперимент был перекрёстным: две группы поменялись форматами на следующей неделе, поэтому каждый студент попробовал и аудиторию, и ИИ. Темы, материалы и рабочие листы совпадали. Менялся способ взаимодействия – группа с преподавателем либо индивидуальный разговор с репетитором PS2 Pal.
Для управленческого чтения это важнее университетского статуса. Если сравнить новый процесс с плохо проведённой встречей, победить может любая аккуратная инструкция; здесь цифровой формат поставили рядом с практикой, которую авторы курса годами улучшали и которая уже превосходила обычные лекции. Поэтому искать причину преимущества приходится в тех свойствах системы, которые аудитория с одним общим темпом воспроизводит с трудом: индивидуальная последовательность, ответ в момент вопроса и возможность задержаться на непонятном месте.
Здесь легко произнести фразу «ChatGPT обошёл преподавателя» и потерять устройство эксперимента. В пересказе Harvard Gazette контрольную группу называют «активной лекцией», и именно в таком виде сравнение разошлось дальше. Ранее это исследование уже мельком появлялось в разборе выступления Синид Бовелл, где формулировку про лекцию пришлось уточнить. В исходной работе проверяли целую учебную систему рядом с одной из сильных форм очного обучения.
Есть ещё статистическая деталь, без которой эффект выглядит точнее, чем был. Многие результаты упёрлись в верхнюю границу пост-теста – возник эффект потолка. Поэтому авторы опираются на медианы и квантильную регрессию, а оценку 0,63 стандартного отклонения из обычной линейной регрессии сами называют заниженной. Даже формулировка «прирост более чем вдвое» у них обозначает нижнюю границу, поскольку тест уже перестал различать сильнейшие результаты.
Далеко ли этот эффект перенесётся за пределы двух занятий по физике? Авторы такой гарантии не дают.
Системный промпт не удержал порядок
В системный промпт заложили три педагогических принципа: поддерживать активное участие, управлять умственной нагрузкой и поощрять установку на развитие способностей. Модель должна была задавать вопросы, выдавать материал небольшими порциями и помогать студенту продолжать после ошибки. Это серьёзная работа над инструкцией.
На заданиях из нескольких частей инструкция давала сбой. По наблюдению авторов, репетитор временами обсуждал части задачи вне последовательности или затрагивал то, что в текущий момент ещё не относилось к делу. Модель знала правило и всё же нарушала его. Знакомая картина для любого менеджера, который просил ассистента сначала проверить данные, затем найти расхождения и лишь потом написать вывод, а получил бодрый вывод в первой строке.
Промпт не справился.
Последовательность перенесли в платформу. Интерфейс проводил студента через каждую часть каждой задачи по очереди, воспроизводя ход аудиторного разбора. У GPT-4 больше не было свободы выбирать следующий этап разговора.
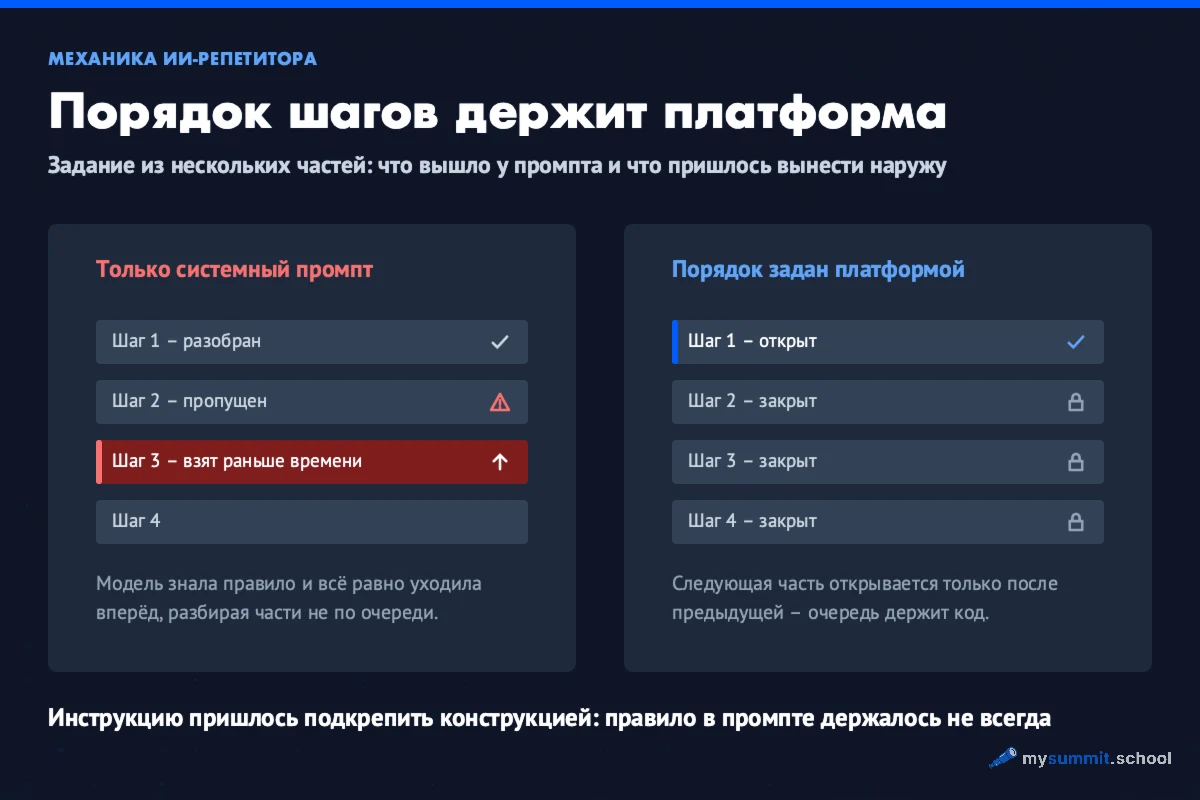
Первое инженерное решение выглядит так: порядок исполнения переехал из инструкции в продукт. Промпт отвечал за поведение внутри шага, платформа – за переход между шагами. Несколько месяцев разработки ушли прежде всего на эту среду с учётом педагогических правил.
Статья показывает, что сделало поведение предсказуемее. Она не учит превращать такую схему в собственный рабочий процесс, где результат стабильно получается с первой попытки.
Промпт – только один слой из трёх. Попробуйте ИИ на 9 реальных задачах менеджера и посмотрите, где ваш запрос перестаёт держать результат. Бесплатно.
Доступ сразу после регистрации
Точность была написана заранее
Второе решение ещё важнее. Авторы прямо говорят, что избегали полагаться только на GPT-4 при решении заданий: языковая модель предсказывает следующий фрагмент текста, поэтому уверенная формулировка сама по себе точности не добавляет. Такая ошибка выглядит особенно убедительно, когда ответ хорошо написан. Механизм подробно разобран в статье про правдоподобный и неправильный отчёт ИИ.
Преподаватели заранее подготовили подробные пошаговые решения и добавили их в контекст каждого вопроса. Модель объясняла материал, опираясь на эталон. По опросу 83% студентов оценили её объяснения на уровне объяснений преподавателей курса или выше, однако эта оценка относится ко всей конструкции вместе с готовыми решениями.
Архитектура получается простой. Модель ведёт разговор. Эксперт поставляет правильное содержание. Платформа решает, какая часть содержания доступна сейчас.
В рабочем процессе менеджера роли распределяются похоже. Эталоном может быть одобренный директором статус, корректно разобранный инцидент или финансовая записка, цифры которой уже сверили с источником; последовательностью служит сохранённая процедура, где следующий этап открывается после проверки предыдущего. Модели остаётся формулировать, задавать уточняющие вопросы и применять материал к новому случаю. Чем критичнее решение, тем опаснее просить её одновременно придумать стандарт качества и оценить по нему собственный ответ.
Третий слой – те самые педагогические правила в системном промпте. Как студенты восприняли занятие, авторы мерили опросом, и читать его стоит целиком. По пятибалльной шкале средняя вовлечённость с ИИ составила 4,1 против 3,6 в аудитории, различие было значимым при p < 0,0001. Для мотивации средние оценки составили 3,4 и 3,1 при p < 0,001. Удовольствие от занятия и установка на развитие способностей статистически значимо не различались.
Что именно дало основной вклад – готовые решения, дробление задачи, обратная связь по запросу или их сочетание? Эксперимент сравнивал две целые среды и не разделял вклад компонентов.
Один раз без эталона, один раз с ним
Перенесём механику в обычную работу менеджера. Допустим, нужно разобрать задержку проекта и подготовить сообщение руководителю. Один большой запрос оставляет модели слишком много решений: какие факты считать причиной, в каком порядке проверять версии и где провести границу между фактом и догадкой.
Опыт удобно провести в два захода. Сначала отправьте модели одну строку: «Разбери причины задержки, определи главную и напиши статус для директора». Ответ придёт уверенный, связный и с готовым виновником. Потом отправьте промпт ниже, где та же задача разбита на шаги и добавлен проверенный образец статуса.
Контекст: запуск личного кабинета задержан на две недели. Известно: интеграционный тест не пройден, API подрядчика трижды менялся, команда фронтенда ждала схему данных четыре рабочих дня, владелец продукта добавил два обязательных сценария после начала тестирования.

Работай по одному шагу. После каждого шага остановись и жди моего подтверждения.

Шаг 1. Выпиши только наблюдаемые факты. Не добавляй причины, которых нет в контексте.
Шаг 2. Для каждого факта укажи возможное влияние на срок и пометь вывод как «подтверждено» или «гипотеза».
Шаг 3. Сравни причины по силе доказательств. Если данных мало, сформулируй вопрос владельцу данных.
Шаг 4. Предложи план восстановления: действие, ответственный, срок, проверяемый результат.
Шаг 5. Напиши статус для директора по эталону ниже.

Эталон хорошего статуса:
«Запуск смещён с 14 на 28 октября. Подтверждённая причина – команда четыре рабочих дня не получала согласованную схему данных, поэтому интеграционный тест начался позже. Изменения API подрядчика могли добавить задержку, точный вклад проверяет Иван к 16:00 10 октября. Дальше: Мария фиксирует версию API сегодня, повторный тест 11 октября».

Сохрани в ответе разделение подтверждённых причин и гипотез. Не называй одну причину главной без сравнительных данных.
Смысл опыта проявится даже без сравнения красоты двух ответов. Проверять стоит другое: придумала ли модель причинность, смешала ли факт с гипотезой, перескочила ли к письму до анализа и совпал ли итоговый статус с принятым у вас стандартом.
И обратите внимание на просьбу останавливаться после каждого шага. Выполнить её модели нечем: в чате нет того, что заставит её ждать вашего подтверждения. Ровно эту функцию Гарвард и забрал у промпта.
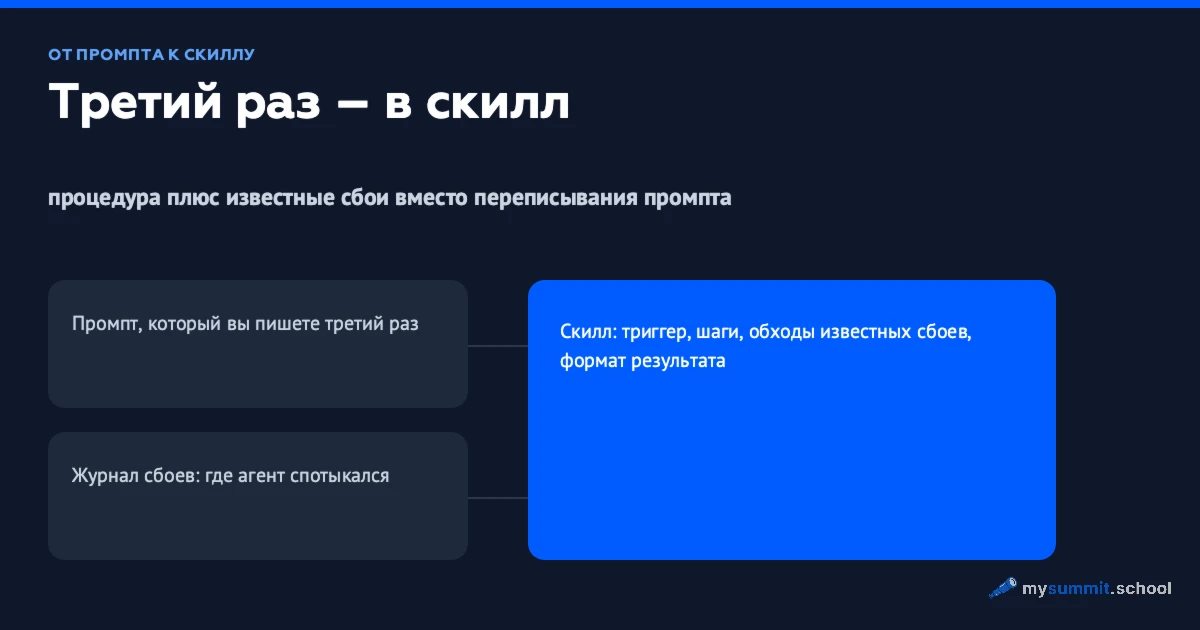
Именно здесь разовая техника становится рабочей привычкой: шаги сохраняются, эталон обновляется после хорошего результата, правила проверки переходят в следующую задачу. Близкое продолжение – разбор пути от промптов к скиллам и субагентам.
Три действия можно начать без собственной платформы: разрезать регулярную задачу по моментам проверки, выбрать один принятый командой результат в качестве эталона и записать причины, по которым прошлые ответы пришлось исправлять. Последний пункт особенно полезен. Он превращает замечание «получилось слабо» в правило, которое модель сможет исполнить при следующем запуске.
Разрезать задачу и написать эталон остаётся работой менеджера. Проверьте на 9 задачах, насколько у вас получается ставить её так, чтобы результат повторялся. Бесплатно, без регистрации.
Доступ сразу после регистрации
У каждого свой час
Платформа зафиксировала медианное время ИИ-занятия – 49 минут. В пределах часа уложились 70% студентов, оставшиеся 30% работали дольше. Между временем в системе и результатом пост-теста авторы корреляции не нашли: дополнительная минута сама по себе ничего не предсказывала.
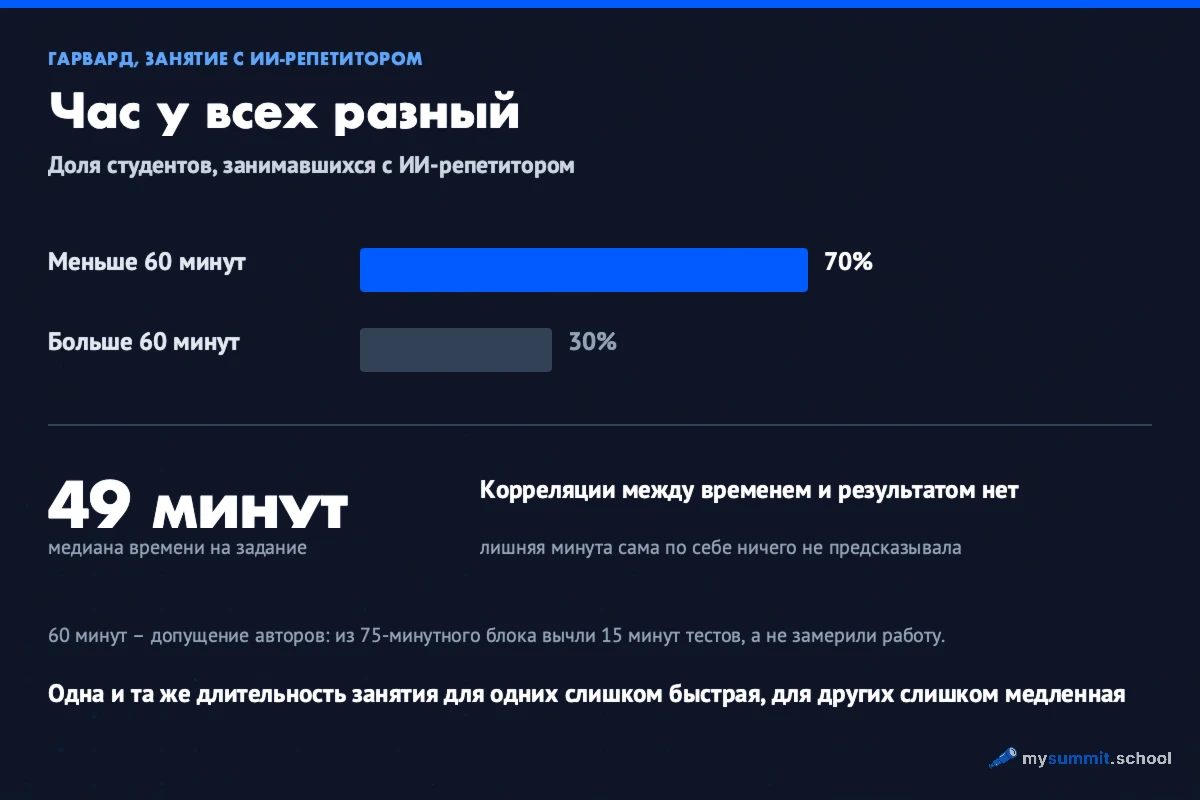
С аудиторным временем нужна аккуратность. Исследователи считают, что обучение заняло 60 минут: из 75-минутного блока они вычли 15 минут на тесты. Это допущение авторов, а не замер фактической активности каждого студента. Сравнение «меньше времени» стоит ровно на этой оценке.
Маленький фрагмент данных хорошо показывает разброс темпа. Слишком быстрым аудиторный темп назвали 3,8% студентов – примерно семь человек, и каждый провёл с ИИ больше медианных 49 минут. Ещё 2,2%, то есть примерно четыре человека, сочли аудиторию слишком медленной; каждый закончил ИИ-занятие быстрее медианы. Слово «каждый» звучит сильно, выборки здесь крошечные.
Для менеджера это узнаваемая проблема часового брифинга. Одни участники уже поняли контекст и ждут решения, другие ещё связывают новые данные с проектом; одинаковая длительность встречи маскирует обе ситуации, а запись «команда прошла час обучения» почти ничего не измеряет. Что сотрудник теперь способен сделать сам, без подсказки? И какой результат можно проверить?
Свой темп и обратная связь по запросу – именно такой механизм улучшения предполагают авторы. Они не объясняют преимущество тем, что ИИ якобы думает быстрее.
Граница результата проходит раньше, чем кажется
Работа охватывала понимание, применение и анализ по таксономии Блума. По составу вопросов пред- и пост-теста 33% приходилось на анализ, 41% – на применение, 21% – на понимание и 4% – на запоминание. Авторы отдельно исключают из вывода сложный синтез нескольких понятий и критическое мышление высокого уровня; такие задачи они предлагают оставлять для совместной очной работы.
Так же осторожно они говорят о роли преподавателя. ИИ-репетитор может подготовить студентов к содержательной работе в классе, освободив очное время для проектов, сложных задач и обсуждения. В статье дважды сказано, что система не должна заменять очное преподавание.
Цена сборки тоже заметна. Подготовка промптов и решений для одного урока заняла несколько дней, причём сами задания и ответы уже существовали. Разработка платформы потребовала нескольких месяцев. Поэтому исследование не даёт основания обещать дешёвое внедрение.
Есть временная оговорка. Эксперимент проходил в 2023 году на GPT-4. За прошедшие годы часть функций, ради которых тогда писали отдельный софт, приблизилась к штатным возможностям инструментов: структурированный вывод фиксирует форму ответа, скиллы сохраняют процедуру, субагенты исполняют отдельные этапы. Инженерная задача стала доступнее, хотя готовые эталоны, ограничения и проверка никуда не делись.
Остаётся вопрос для любой команды: какая часть вашей работы уже достаточно понятна, чтобы вынести её из головы в последовательность, и кто будет отвечать за эталон? А что пока рано фиксировать, потому что хороший результат узнаётся только по опыту конкретного менеджера?
Предсказуемая работа с ИИ начинается с системы
В «Фундаменте» вы учитесь получать нужный результат с первого промпта, а потом встраивать ИИ в рабочий день так, чтобы процесс не приходилось собирать заново в каждом чате – на задачах менеджера, со своими эталонами и проверками.



Часто задаваемые вопросы
Правда ли, что ChatGPT в исследовании обошёл преподавателей?
Почему одного системного промпта оказалось мало?
Как перенести устройство ИИ-репетитора в работу менеджера?
Stanislav Belyaev
Engineering Leader в Microsoft18 лет в управлении инженерными командами. Основатель mysummit.school. 700+ выпускников в Яндекс Практикуме и Стратоплане.