Qwen от Alibaba в 2026: открытые веса вернулись во флагманы

AI-модели в этой статье
Пока менеджеры платят за ChatGPT Plus и Claude Pro, Alibaba выстроила одну из самых масштабных ИИ-экосистем в мире – с бесплатным чатом, открытыми моделями и ценами API в разы ниже конкурентов. Qwen (произносится «Чвен», от 通义千问 – «Тысяча вопросов») к середине 2026 года обогнал по числу загрузок все западные аналоги и стал инструментом, который стоит знать каждому менеджеру. Весной казалось, что экосистема сворачивает в сторону OpenAI и Anthropic: флагманы серии 3.7 вышли закрытыми, ключевые разработчики ушли. За август Alibaba выпустила три модели и развернулась обратно. Флагманский Qwen3.8-Max обещан к публикации весов, а Qwen3.8-27B с лицензией Apache 2.0 запускается на одной потребительской видеокарте.
Главная особенность Qwen для менеджера проста: это полноценный ИИ-ассистент, доступный бесплатно через Qwen Chat – без подписки, без ограничений по количеству запросов. К апрелю 2026 года число загрузок моделей Qwen приблизилось к миллиарду – на семейство приходится более 50% всех скачиваний открытых моделей в мире. У потребительского приложения Qwen – более 200 миллионов активных пользователей в месяц, третье место в мире после ChatGPT и DouBao.

В чём особенность Qwen?
Ключевое отличие Qwen от большинства конкурентов – масштаб и гибкость. Alibaba публикует значительную часть моделей в открытый доступ на Hugging Face – любая компания может скачать их и развернуть на собственных серверах. Среди тех, кто использовал Qwen как основу, – Oylan, национальная языковая модель Казахстана. Летом открытые веса перестали быть чертой моделей среднего уровня: Alibaba объявила, что выпустит веса и флагманского Qwen3.8-Max. Серия 3.7 при этом осталась закрытой и доступна только через API.
- Большинство моделей Qwen доступны для скачивания и запуска на собственном сервере. Для компаний с жёсткими требованиями к безопасности данных открытые модели – Qwen3.8-27B, Qwen3.8-Flash-Next, Qwen 4 Coder, всё семейство Qwen 3.5 – остаются одними из лучших в мире.
- Флагманские модели работают по принципу специализации: на каждый запрос отвечает только нужная группа экспертов – небольшая активная часть модели. Практический результат – модель, которая запускается на ноутбуке, даёт качество ответов, которое раньше требовало серверного оборудования за сотни тысяч рублей.
- Текстовые модели серии Qwen3 поддерживают 119 языков и диалектов, новейшие версии – 201 язык, включая русский. Россия – один из крупнейших рынков Qwen: около 30% трафика платформы приходится на русскоязычных пользователей.
- Текст, изображения, видео, аудио, генерация речи – всё в одной экосистеме.
Что Qwen умеет в сентябре 2026
Линейка Qwen сегодня охватывает практически все типы задач, с которыми сталкивается современная компания:
- Флагман, который обещали открыть. Qwen3.8-Max (GA – 3 августа 2026) – разреженная MoE на 2,4 трлн параметров, из них около 95 млрд активны на каждом проходе. Контекст 1 млн токенов, на вход принимает текст, изображение и видео. Цена $2,00/$6,00 за 1 млн токенов.
- Локальное развёртывание со зрением. Qwen3.8-27B (13–14 августа) – плотные 27–28 млрд параметров с энкодером зрения, контекст 262K, лицензия Apache 2.0 и примерно 17 ГБ в квантовании Q4_K_M: одна видеокарта или ноутбук с 16 ГБ памяти.
- Дешевле в двенадцать раз. Qwen3.8-Flash-Next (26 августа) – открытое превью архитектуры Qwen4: 125 млрд параметров, 6 млрд активных на токен, около $0,16/$0,47 за 1 млн токенов.
- Агенты нового поколения. Qwen 3.7 Max (май 2026) спроектирован как «агентная модель» – способен автономно выполнять цепочки из 1 000+ вызовов инструментов в одном сеансе без деградации качества. Контекст 1 млн токенов, самый низкий уровень галлюцинаций среди флагманских моделей (22,9%).
- Мультимодальный агент. Qwen 3.7 Plus (GA – 1 июня 2026) понимает текст, изображения и видео, видит экран и возвращает координаты элементов интерфейса (GUI agent grounding). Контекст 1 млн токенов.
- Код нового уровня. Qwen 4 Coder 32B-A3B (2 июня 2026) – первая открытая модель, взявшая 82% на SWE-Verified. Архитектура MoE: 32 млрд параметров, из них активны только 3 млрд – запускается на Mac с 24 ГБ памяти со скоростью 58 токенов/сек. Лицензия Apache 2.0.
- Работа с длинными документами. Qwen3.6-Plus держит в памяти до 1 миллиона токенов – около 2 000 страниц A4 за один запрос. Можно загрузить годовой отчёт целиком, базу клиентских обращений или весь репозиторий кода и задавать вопросы по всему массиву.
- Сложные рассуждения. Qwen3.7-Max в режиме цепочки рассуждений набирает 92,4% на GPQA Diamond – выше Claude Opus 4.6 Max (91,3%) и K2.6 Thinking (90,5%). На математических задачах (Apex Math) – 44,5% против 34,5% у Claude Opus 4.6 Max.
- Агентское программирование. Qwen3.6-35B-A3B работает в связке с Claude Code, Qwen Code и подобными инструментами и решает задачи на уровне Claude Sonnet 4.5 при кратно меньшей цене. Открытая лицензия – можно развернуть внутри компании.
- Голос и видео в одной модели. Qwen3.5-Omni одновременно понимает текст, изображения, аудио и видео в рамках единой архитектуры. На её базе работает «Audio-Visual Vibe Coding» – режим, в котором задача описывается голосом и видео с экрана, а модель генерирует код.
- Генерация изображений и речи. Qwen-Image-2512 делает фотореалистичные картинки с точным рендерингом многострочного текста – редкость для генеративных моделей. Qwen3-TTS синтезирует речь с клонированием голоса для озвучки и голосовых ассистентов.
- Третье место в таблице зрения LMArena. Qwen3.8-Max набирает 1 300±8 и пропускает вперёд только две модели Anthropic. Интервалы у первой девятки перекрываются, так что это плотная группа, а верхние строчки держатся на разнице внутри погрешности.
Основные модели Qwen (сентябрь 2026)
К сентябрю 2026 года Alibaba сформировала одну из самых обширных линеек моделей в индустрии.

Qwen3.8-Max – флагман, который Alibaba обещала открыть (август 2026)
Qwen3.8-Max вышел в общий доступ 3 августа 2026 года, а 2–3 сентября получил пост-тренинговое обновление с индексом 0902. В наш бенчмарк модель ещё не входит – ниже данные производителя и независимых площадок.
Архитектура – разреженная смесь экспертов: 2,4 трлн параметров всего, около 95 млрд активны на каждом проходе. Контекст 1 млн токенов, максимальный ответ – 131 072 токена. На вход модель принимает текст, изображение и видео, возвращает текст; рассуждения включены по умолчанию. Есть вызовы инструментов и структурированный вывод по JSON-схеме в response_format. Цена за 1 млн токенов: $2,00 на входе, $6,00 на выходе, $0,25 за чтение кэша.
Что заявляет сам Alibaba:
- OSWorld-Verified – 86,1 против 83,2 у GPT-5.6 Sol Max, 85,0 у Claude Fable 5 и 76,2 у Gemini 3.1 Pro
- PaperBench – 93,0, выше всех опубликованных результатов в этом бенчмарке
Это цифры производителя, собранные на его же прогонах, и относиться к ним стоит соответственно.
Независимые площадки подтверждают главное. На LMArena Qwen3.8-Max стоит третьим в таблице зрения – 1 300±8, сразу за claude-fable-5 (1 313) и claude-opus-4-7-high (1 301). Смысл этой строчки в другом: один вторичный источник называл Max-версию чисто текстовой, и таблица зрения вопрос закрывает. Обновление 0902 поднялось на первое место в Code Arena WebDev с результатом 1 691 – на три пункта выше Claude Opus 5 Max и на двадцать два выше исходной версии 3.8-Max.
На Artificial Analysis Qwen3.8-Max получает 47 баллов индекса интеллекта при смешанной цене $1,19 за 1 млн токенов. Столько же баллов у Gemini 3.8 Flash, который стоит $0,74. Отдельная строка, которую стоит запомнить: 40 токенов в секунду на выходе – последний результат в первой десятке таблицы, у Gemini 3.8 Flash их 334. Флагман Qwen медленный, и на интерактивной работе это ощущается без всяких бенчмарков.
Qwen3.8-Flash-Next – двенадцать раз дешевле флагмана (26 августа 2026)
Открытое превью архитектуры Qwen4. 125 млрд параметров всего, 6 млрд активны на токен, плюс слой N-gram-эмбеддингов на 51 млрд параметров, который живёт в обычной оперативной памяти и не занимает память видеокарты. По сути это словарь часто встречающихся словосочетаний, и держать его на GPU необязательно – отсюда и экономия.
Контекст 262 144 токена штатно, до 1 млн через YaRN. Цена – около $0,16 на входе и $0,47 на выходе за 1 млн токенов, кэшированный вход дешевле примерно на 89%. От Qwen3.8-Max это отличается раз в двенадцать.
В нашем бенчмарке модели нет, и на независимых площадках она на момент написания тоже не появилась. Всё, что есть, – данные производителя: DeepSWE 58,7 и SWE-bench Pro 62,5 на коде, плюс CoWorkBench 73,9 и JobBench 55,7. Там же утверждается, что Flash-Next обходит Qwen3.7-Plus примерно при девятой части затрат на обучение и оказывается сильнее DeepSeek-V4-Flash (284B) и Claude Opus 4.6 на большинстве протестированных задач. Проверить эти цифры пока негде, так что считайте их обещанием.
Веса лежат на Hugging Face и ModelScope под Qwen Community License, хостинг – через QwenCloud API.
Открытые веса и лицензия
Три модели одного поколения вышли в трёх разных юридических режимах, и для менеджера это важнее баллов.
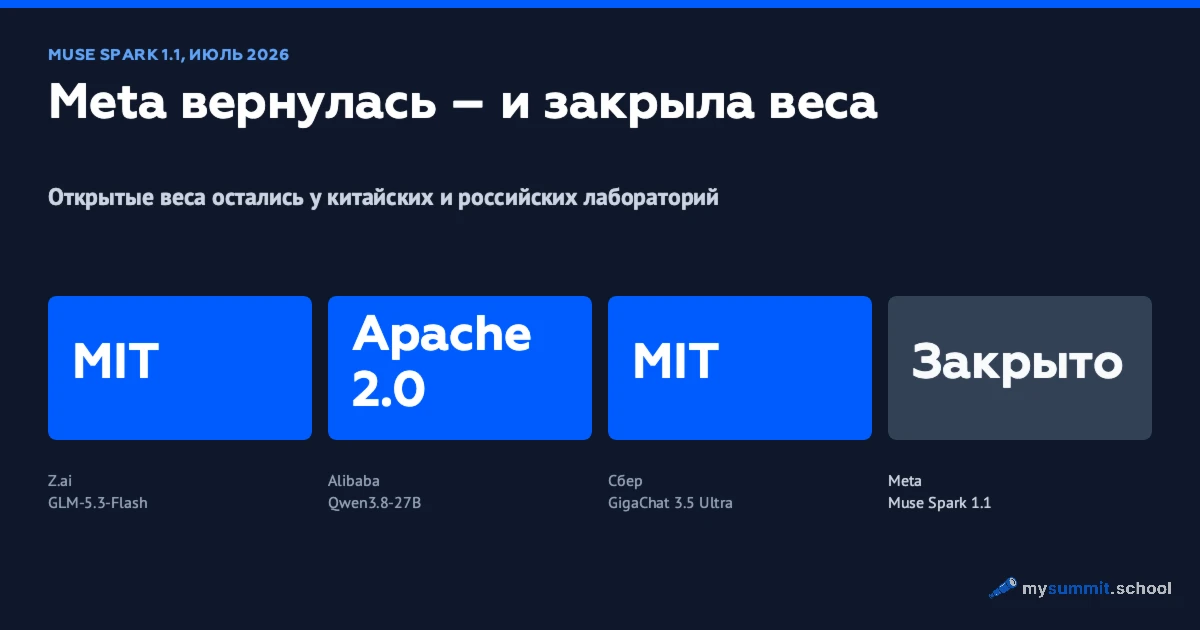
- Qwen3.8-27B – Apache 2.0. Никаких условий: можно встраивать в коммерческие продукты, дообучать, перепродавать.
- Qwen3.8-Flash-Next – Qwen Community License. Это собственный текст Alibaba, и читать его нужно до внедрения.
- Qwen3.8-Max – впервые Max-класс обещан к открытию, но сообщается о собственной лицензии с ограничениями для компаний, зарабатывающих на ИИ-услугах больше $50 млн. Это не Apache 2.0.
Плюс физика. Qwen3.8-Max в FP8 – примерно 2,5 ТБ весов, то есть уровень дата-центра. Открытые веса в его случае означают возможность изучить модель и, при наличии соответствующего железа и лицензии, развернуть её.
Порог по выручке как условие лицензии – приём не уникальный, у Kimi K3 он установлен на $20 млн. Практический вывод один: фраза «модель с открытыми весами» без названия лицензии не несёт информации.
Qwen 3.7 Max – агентный флагман (май 2026)

Qwen 3.7 Max (в записи без пробела – Qwen3.7-Max) анонсирован на Alibaba Cloud Summit 20 мая 2026 года после тихого появления в LM Arena 14 мая. Серия 3.7 включает две модели: Qwen3.7-Max (текстовый флагман для рассуждений и агентных задач) и Qwen3.7-Plus (мультимодальный агент, GA с 1 июня 2026).
Ключевые характеристики Qwen3.7-Max:
- Контекст 1 млн токенов – против 256K у Qwen 3.6 Max
- Агентная архитектура – модель способна работать в автономных сессиях длительностью до 35 часов, связывая 1 000+ последовательных вызовов инструментов без потери качества. В демо на саммите модель автономно оптимизировала ядро – более тысячи правок кода и 10-кратное ускорение инференса
- Самый низкий уровень галлюцинаций среди флагманских моделей – 22,9%
- Режим «Thinking» – переключаемая цепочка рассуждений, видимая в интерфейсе Qwen Chat
Результаты на бенчмарках:
| Бенчмарк | Qwen3.7-Max | Сравнение |
|---|---|---|
| Intelligence Index v4.0 | 56,6 | 5-е место в мире, 1-е среди китайских моделей |
| GPQA Diamond | 92,4% | Выше Claude Opus 4.6 Max (91,3%) |
| Apex Math | 44,5% | Выше Claude Opus 4.6 Max (34,5%) |
| MRCR-v2 128K (длинный контекст) | 90,4% | Выше Qwen3.6-Plus (85,9%) |
| Terminal-Bench Hard (код) | 50,8% | – |
Qwen3.7 доступен только через API, открытых весов у серии нет и сроков их публикации Alibaba не называла. Следующее поколение эту логику сломало: 3.8-Max обещан к открытию, а 27B и Flash-Next вышли с весами в публичном доступе.
Qwen 3.7 Plus – мультимодальный агент (GA – 1 июня 2026)
Qwen3.7-Plus появился в LM Arena 14 мая как предварительная версия и вышел в общий доступ (GA) 1 июня 2026. Это мультимодальная версия серии 3.7: модель принимает текст, изображения и видео на вход и возвращает текст.
Отличия от Qwen3.7-Max:
- GUI Agent Grounding – модель «видит» скриншот и возвращает точные пиксельные координаты элементов интерфейса. Это позволяет создавать автономных агентов, которые управляют приложениями визуально – без API
- Контекст 1 млн токенов, до 65 536 выходных токенов, внутренний бюджет рассуждений до 256K токенов
- Параметр
preserve_thinking– сохраняет состояние рассуждений между вызовами инструментов в агентном цикле - Цена за задачу – в карточке выше; среди мультимодальных моделей Plus один из самых дешёвых вариантов
Qwen 3.7 Plus – закрытая модель (API-only, без открытых весов). Для менеджера это важный сигнал: самые способные мультимодальные модели серии 3.7 доступны только через облачный API; локального развёртывания для них нет. С выходом Qwen3.8-27B со зрением и Apache 2.0 этот аргумент заметно ослаб.
Qwen3.6-Plus – флагман с контекстом 1 млн токенов
Выпущен в апреле 2026 как ответ на Gemini 2.5 и GPT-5. Гибридная архитектура объединяет линейное внимание и разреженную смесь экспертов – это позволяет работать с гигантскими документами без потери скорости.
- Контекст до 1 миллиона токенов: годовой отчёт или весь репозиторий кода уходит в один запрос целиком, без разбивки на части.
- 78,8% на SWE-bench Verified – почти уровень закрытых флагманов в задачах программирования.
- Audio-Visual Vibe Coding: опишите задачу голосом и покажите макет в камере – модель сгенерирует код.
- Лицензия Apache 2.0 – можно скачать веса и запускать локально.
Qwen3.5 – семейство мультимодальных моделей
Выпущена в марте 2026, доступна на платформе Microsoft Azure. Принципиальное отличие – модели «понимают» текст, изображения, аудио и видео как единое целое в рамках одной архитектуры. Один вопрос может одновременно ссылаться на загруженный документ, скриншот, фрагмент видео и текстовый контекст.
Серия охватывает весь диапазон – от 0,8 млрд параметров (запускается на смартфоне) до 397 млрд (сравним с GPT и Claude):
- Qwen3.5-4B / 9B – самые «умные» в своих весовых категориях; запускаются на ноутбуке и обходят модели в 2–3 раза крупнее. И даже на телефоне.
- Qwen3.5-27B – строгое следование инструкциям: структурированные отчёты, заполнение форм, многошаговые поручения.
- Qwen3.5-35B-A3B – баланс между качеством и скоростью: 35 млрд параметров, но активно работают только 3 млрд.
- Qwen3.5-122B-A10B – сложная аналитика и большие объёмы информации.
- Qwen3.5-397B-A17B – флагман с открытым кодом; на тесте GDPval-AA опережает предшественника Qwen3-235B на 361 пункт. Третий результат среди open-source моделей в мире.
Осенью семейство остаётся актуальным и по-прежнему идёт целиком под Apache 2.0, со зрением у всех версий до 27B включительно. Ориентиры по железу: 0,8B работает на ноутбуке без видеокарты и занимает около 0,6 ГБ, 2B влезает в RTX 3060 или M1, 9B – в карту на 16 ГБ, 27B – в RTX 4090. У всех версий 256K контекста штатно; гибридные слои линейного внимания снимают обычный штраф за KV-кэш. 35B-A3B на машинах, упирающихся в процессор или пропускную способность памяти, идёт примерно впятеро быстрее плотной 27B. 122B-A10B и 397B-A17B – текстовые и требуют нескольких H100.
Общее для всей серии:
- За один запрос можно загрузить около 400 страниц A4; при необходимости контекст расширяется до эквивалента небольшой книги.
- Два режима работы – «Думать» (пошаговые рассуждения для сложных задач) и «Не думать» (мгновенные ответы для рутины) – переключаются внутри одной модели без перехода в другой сервис.
- Поддержка 201 языка, включая русский.
- На независимых тестах конкурирует с ведущими мультимодальными моделями при значительно меньших затратах.
Переключение между режимами – главная находка Qwen3/3.5. Не нужно выбирать между «умной» и «быстрой» моделью: одна и та же адаптируется под сложность задачи. Для анализа финансового отчёта – режим глубоких рассуждений. Для ответа «когда совещание?» – мгновенный ответ.
Qwen3-235B – флагманская текстовая модель с открытым кодом
Выпущена в апреле 2025, обучена на объёме данных вдвое большем, чем у предыдущего поколения. Специализированная архитектура позволяет достигать флагманского качества при значительно меньших вычислительных затратах – разница ощутима при работе через API.
- Код модели открыт – любая компания может скачать и запустить её на собственных серверах. Потребуется серьёзное серверное оборудование.
- Модель «размышляет» перед ответом – пошагово проверяет логику. Это важно для сложных расчётов, юридического анализа, финансового планирования.
- Qwen3-Max – облачная версия через API для тех, кто не хочет заниматься установкой на сервер.
- За один запрос – до 200 страниц A4; в расширенном режиме – до 400 страниц.
Qwen3-30B – оптимальный выбор для корпоративного сервера
Модель корпоративного класса: обрабатывает запросы быстро и дёшево, несмотря на большой размер. По качеству превосходит более старые модели, которые требовали втрое больше ресурсов.
- Для команд, которым нужен мощный ассистент на собственном сервере, но без расходов на целый дата-центр.
- До 200 страниц A4 в одном запросе.
Qwen3-Coder-Next – модель для разработчиков (февраль 2026)
Специализированная модель для написания и проверки кода. На независимых тестах обходит модели DeepSeek и держится на уровне Claude Sonnet 4.5.
Для менеджера это, скорее всего, инструмент команды разработки. Модель способна удерживать в памяти весь проект целиком, включая все файлы репозитория. Запуск на собственном сервере потребует около 51 ГБ оперативной памяти.
Qwen 4 Coder – первый open-source кодер с 82% SWE-Verified (июнь 2026)
Qwen 4 Coder 32B-A3B, выпущенный 2 июня 2026, – первая модель, обозначающая переход к четвёртому поколению Qwen, и первая открытая модель, преодолевшая 80% на SWE-Verified – бенчмарке, который коррелирует с реальной продуктивностью разработчика.
- Архитектура MoE: 32 млрд параметров всего, 3 млрд активны на каждый токен. Контекст 256K
- 82% SWE-Verified – выше Devstral, Qwen3.6-Coder и всех моделей, запускаемых на ноутбуке
- Работает на Mac с 24 ГБ: 58 токенов/сек на M4 Pro – полноценное использование без сервера
- Обучение на реальных тестах: в отличие от предшественников, Qwen 4 Coder обучен с подкреплением (reinforcement learning) на результатах выполнения тестов из реальных GitHub-задач
- Лицензия Apache 2.0 – те же свободы, что у Qwen3.8-27B: коммерческие продукты, дообучение, перепродажа
Для IT-директора или руководителя разработки Qwen 4 Coder – повод пересмотреть расходы на подписки: модель, которую можно запустить на рабочем ноутбуке разработчика, решает задачи на уровне облачных флагманов.
Линейка выглядит внушительно, но выбрать в ней правильную модель – лишь часть задачи. За август Alibaba выпустила три релиза, и у каждого своё назначение: флагман для сложных рассуждений, компактная модель для запуска у себя и дешёвая для потоковых агентных сценариев. Разница между «получить ответ» и «получить надёжный результат» – в умении формулировать запросы и проверять выводы. Именно этому посвящён наш открытый модуль.
Qwen3.8-Max, 27B на одной видеокарте и Flash-Next за $0,16 – три релиза за один август. Понять, какой из них ваш, можно только на практике: 9 реальных задач менеджера, бесплатно и без регистрации.
Доступ сразу после регистрации
Qwen3-VL – анализ изображений и документов
Понимает изображения, видео (продолжительностью более часа), PDF-документы и рукописный текст. Распознавание текста работает на 32 языках, включая русский: загрузите скан договора или фотографию доски после совещания – получите структурированный текст.

Qwen3.5-Omni – нативная мультимодальность (март 2026)
Текст, изображения, аудио и видео обрабатываются единой архитектурой, без отдельных кодировщиков. По замерам Alibaba – лучшие в классе результаты на 215 задачах понимания аудио и аудиовизуального контента. Поддерживает голосовой ввод и вывод в реальном времени на русском языке, встроенный веб-поиск и вызов внешних инструментов. На базе Omni реализован сценарий Audio-Visual Vibe Coding: разработчик описывает требования голосом и показывает интерфейс в видео – модель пишет код.
Qwen3-TTS и Qwen-Image-2512 – голос и изображения
Qwen3-TTS (открытая лицензия) – синтез речи с клонированием голоса и потоковой генерацией для голосовых ассистентов и озвучки. Qwen-Image-2512 – обновлённая модель генерации изображений с фотореалистичной детализацией и качественным рендерингом текста: многострочные надписи, абзацы, фирменные элементы – то, на чём ломаются Midjourney и DALL-E.
Модели для локального запуска
Alibaba предлагает линейку компактных моделей, которые можно запустить на собственном оборудовании – от ноутбука до корпоративного сервера:
| Где запускать | Модель | Макс. документ | Для каких задач |
|---|---|---|---|
| Смартфон или планшет | Qwen3-0.6B | ~50 стр. | Автодополнение, простые подсказки |
| Обычный ноутбук (4 ГБ RAM) | Qwen3-1.7B | ~50 стр. | Черновики писем, краткие сводки |
| Мощный ноутбук (8 ГБ RAM) | Qwen3-4B | ~50 стр. | Анализ документов, качество уровня старых топ-моделей |
| Рабочий ПК (16 ГБ RAM) | Qwen3-8B | ~200 стр. | Сложные документы, таблицы, длинные диалоги |
| Сервер отдела (32 ГБ RAM) | Qwen3-14B | ~200 стр. | Полноценный командный ассистент |
| Корпоративный сервер (48 ГБ RAM) | Qwen3-32B | ~200 стр. | Качество, близкое к облачным топ-моделям |
| Серверный кластер (от 140 ГБ) | Qwen3-235B | ~400 стр. | Флагманское качество, конкурирует с GPT и Claude |
Если ваша компания не может отправлять данные на внешние серверы – финансы, медицина, госсектор – можно скачать нужную модель и развернуть её внутри корпоративной сети. Данные никогда не покинут ваш периметр. Это невозможно сделать с ChatGPT или Claude.
Qwen3-4B умещается на обычном ноутбуке (от 4 ГБ памяти) и даёт качество, сопоставимое с моделями, которые раньше требовали полноценного серверного шкафа.
Практическое руководство по выбору железа, установке Ollama и сравнению локальных моделей с облачными – в гиде по локальным LLM для менеджеров.
Qwen3.8-27B – модель, которая помещается на одной видеокарте
Релиз 13–14 августа 2026 года, и для компании это событие заметнее выхода флагмана.
Плотные 27–28 млрд параметров с энкодером зрения: модель нативно понимает изображения и видео, возвращает текст. Контекст 262K. Лицензия Apache 2.0 – без оговорок про выручку и без отдельного юридического согласования для каждого сценария. В квантовании Q4_K_M это примерно 17 ГБ, то есть одна потребительская видеокарта уровня RTX 4090 либо ноутбук с 16 ГБ памяти через Ollama или llama.cpp.
В нашем бенчмарке модели пока нет, но здесь почти нечего сравнивать с другими производителями: Apache 2.0, зрение из коробки и одна видеокарта – такого сочетания на рынке до августа не было.
Для российской компании, которой нельзя отправлять данные в облако, это первый вариант «всё у себя», который не выглядит компромиссом. Qwen3-4B на ноутбуке был демонстрацией возможности. 27B со зрением и контекстом 262K – рабочий инструмент для сканов договоров, фотографий досок после совещаний, внутренних регламентов и переписки, которые нельзя показывать внешнему сервису.
Что стоит проверить до внедрения:
- Скорость на вашем железе. 17 ГБ – это размер весов; про приемлемое время ответа он ничего не говорит. На машине с 16 ГБ памяти часть модели уйдёт на процессор, и генерация замедлится.
- Качество на русском. Независимых замеров у модели пока нет, так что тестировать её нужно на собственных документах, впечатление от демо здесь не аргумент.
- Обслуживание. Локальное развёртывание – это сервер, обновления весов, мониторинг и человек, который за всё это отвечает. Экономия на API частично уйдёт в его зарплату.
Как Qwen выглядит на фоне конкурентов
Независимые площадки рисуют более скромную картину, чем анонсы. В индексе Artificial Analysis от сентября 2026 разброс между первым местом (Claude Fable 5.1 – 57 баллов) и десятым (DeepSeek V4 Pro 0813 – 42) составляет 15 пунктов, а разброс в цене – в 34 раза: $6,12 против $0,18 у GLM-5.3-Flash. Те самые 47 баллов Qwen3.8-Max делят с Gemini 3.8 Flash.
Одна оговорка по методике. Artificial Analysis публикует индекс в версиях и пересчитывает шкалу между ними, так что цифра из анонса модели и цифра из живой таблицы относятся к разным шкалам. Сравнивать можно только внутри одного среза.
На LMArena позиции с первой по девятую перекрываются доверительными интервалами на обеих таблицах, текстовой и визуальной. Формально это ничья. Тот, кто объявляет по такой таблице лучшую модель, читает её слишком буквально – об этом у нас есть отдельный разбор.
| Критерий | Qwen | ChatGPT / Claude | DeepSeek |
|---|---|---|---|
| Качество флагмана | Высочайшее (47 баллов Artificial Analysis, 1-е место в Code Arena WebDev) | Высочайшее | Среднее при минимальной цене |
| Бесплатный веб-доступ | Да, chat.qwen.ai без ограничений | Ограниченный | Ограниченный |
| Можно запустить на своём сервере | Да – Qwen3.8-27B, Flash-Next, Qwen 4 Coder, серии 3.6 и 3.5; серия 3.7 закрыта | Нет | Частично |
| Стоимость API | Самая низкая в классе: Qwen3.8-Max – $2,00/$6,00, Flash-Next – $0,16/$0,47 | Высокая: GPT-6 Astra – $10/$50 | Низкая |
| Работа с изображениями и видео | Да (3.8-Max, 3.8-27B, 3.7 Plus, 3.5-Omni) | Да | Ограниченная: зрение только в preview на дешёвом тарифе |
| Поддержка русского языка | Хорошая | Отличная | Хорошая |
| Доступ из России | Без VPN | Требуется VPN | Без VPN |
Для большинства бизнес-задач – написание текстов, анализ данных, сводки документов – Qwen 3.7 Plus даёт результат, сопоставимый с Claude Sonnet 5, при заметно более низкой цене.
Qwen3.8-Max стоит $2/$6 за миллион токенов там, где GPT-6 Astra просит $10/$50, – и обе цифры ничего не значат, пока вы не проверили их на своей задаче. В открытом модуле 9 практических задач менеджера – бесплатно, регистрация не нужна.
Доступ сразу после регистрации
Результаты в нашем бенчмарке (обновление – сентябрь 2026)
Qwen – самая широко представленная экосистема в нашем бенчмарке: пять моделей, и все доступны из России напрямую. Результаты – на 80 сценариях реальных менеджерских задач (анализ, планирование, коммуникация, управление командой). Линейки 3.8 среди них нет: Qwen3.8-Max, 27B и Flash-Next мы пока не тестировали, всё сказанное о них выше опирается на данные производителя и независимых площадок.
Три флагмана – Qwen 3.6 Plus, Qwen 3.7 Max и Qwen 3.7 Plus – разобраны выше со свежими данными бенчмарка (место, балл, цена за задачу и дата теста – в карточках под их заголовками). Две оставшиеся модели среднего класса:
Qwen 3.6 Flash обходит Gemini 3.5 Flash при кратно меньшей цене; Qwen 3.6 27B особенно силён в планировании. По соотношению цена/качество Qwen 3.6 Plus выглядит убедительнее и Claude Sonnet 5, и GPT-5.4 Mini, а обходится дешевле.
Главный парадокс линейки: Qwen 3.7 Max дороже Qwen 3.6 Plus, но стоит в общем рейтинге ниже. Выигрывает он конкретно в категориях «планирование» и «управление командой» – если эти задачи для вас ключевые, Max оправдан.
Профиль Qwen 3.6 Plus по восьми категориям наглядно показывает разрыв: сильная работа с текстом и анализом – и провалы там, где нужен локальный контекст.
Слабости у всей линейки Qwen общие:
- Российское трудовое законодательство – изобретает несуществующие статьи и санкции. Критичные юридические вопросы нельзя решать без проверки.
- Финансовые расчёты – систематические арифметические ошибки.
- Региональная осведомлённость – слабейшая категория у всех моделей Qwen.
Стратегия использования на сегодня такая. Qwen 3.6 Plus – основная рабочая модель. Qwen 3.7 Plus – для массовых рутинных операций, когда бюджет критичен. Max оправдан там, где решают задачи планирования и управления командой: в этих категориях он сильнее по нашим замерам. Как только линейка 3.8 появится в бенчмарке, этот расклад придётся пересчитать.
Полные интерактивные результаты ->
Попробуйте сами: планирование + российское трудовое право
Qwen обычно выдаёт отличную структуру плана (планирование – сильнейшая категория), но при ссылках на ТК РФ часто изобретает несуществующие статьи и санкции (региональная осведомлённость – слабейшая категория). У DeepSeek та же проблема с российским правом, а Kimi K2.6 – сильнейший планировщик, но и он плохо знает локальные нормативы.
Практическое применение для менеджера
Большинство менеджеров, попробовавших Qwen, начинают с Qwen Chat – бесплатного веб-интерфейса с доступом к актуальным моделям. Он поддерживает веб-поиск, генерацию изображений и анализ документов без какой-либо подписки. Хорошая точка входа для тех, кто хочет оценить инструмент до разговора с IT-отделом.
Qwen уверенно справляется с русскоязычными документами: качество распознавания сканов, рукописных заметок и фотографий досок на русском заметно лучше, чем у многих западных инструментов.
Отдельный сценарий – корпоративное развёртывание без облака. Для компаний, которым запрещено отправлять данные за периметр, Qwen предлагает то, что недоступно у ChatGPT или Claude: модели можно скачать и запустить на собственных серверах. С августа 2026 этот сценарий перестал требовать компромиссов по качеству – Qwen3.8-27B со зрением и Apache 2.0 закрывает его на одной видеокарте. Это та же логика, которую выбирают государственные структуры при построении суверенных ИИ-систем – контроль над данными важнее удобства облачного доступа.
Наконец, Qwen3.5-Omni и Qwen3-TTS позволяют создать голосового ассистента на русском языке: распознавание речи, обработка запроса, синтез речи – всё из одной экосистемы, без необходимости соединять несколько отдельных сервисов.
Разворот обратно: флагман снова открыт
В первой половине 2026 года изменилось основное ценностное предложение Qwen. Alibaba перевела флагманские модели – Qwen3.7-Max и Qwen3.7-Plus – в закрытый формат (API-only, без открытых весов). Это ставило Alibaba в прямую конкуренцию с OpenAI и Anthropic за корпоративные API-контракты и выглядело как отказ от того, на чём экосистема выросла.
Подход и тогда не был полным отказом от open-source: Qwen3.6-35B-A3B и Qwen 4 Coder вышли с лицензией Apache 2.0. Но самые способные модели оказались закрыты, и чётких обязательств по срокам открытия серии 3.7 компания не давала.
В августе направление сменилось. Qwen3.8-Max – первый флагман класса Max, веса которого Alibaba обещала опубликовать. В том же месяце вышли Qwen3.8-27B под Apache 2.0 и Qwen3.8-Flash-Next с весами на Hugging Face и ModelScope. Серия 3.7 закрытой и осталась.
На фоне весеннего разворота команду покинули ключевые фигуры. В марте 2026 ушёл технический руководитель проекта Линь Цзюньян (Lin Junyang), написавший в соцсетях: «me stepping down. bye my beloved qwen». В тот же день уволился Юй Бовэнь (Yu Bowen), руководивший пост-тренингом. Ещё раньше ушёл Хуй Биньюань (Hui Binyuan), ведущий исследователь по коду. Коллега из команды прокомментировал: «Я знаю, что уход – не твой выбор». Акции Alibaba в тот день упали на 5,3%.
Для менеджера, выбирающего Qwen, картина теперь такая:
- Открытые модели дошли до верхнего уровня. 27B и Flash-Next уже скачиваются, Max обещан. Если критичен контроль над данными, ждать больше нечего.
- Условия открытия приходится читать. Apache 2.0 у 27B, собственная лицензия у Flash-Next, порог по выручке у Max.
- Кадровая нестабильность никуда не делась. За лето темп релизов не упал, но судить о тенденции по одному периоду рано.
Ограничения и риски
- Лицензия флагмана: открытие Qwen3.8-Max обещано, но лицензия у него будет собственная, с порогом по выручке. Планировать коммерческое развёртывание на своих серверах можно только после чтения её текста.
- Размер флагмана: около 2,5 ТБ весов в FP8, уровень дата-центра; на практике Qwen3.8-Max остаётся облачной моделью независимо от того, опубликуют веса или нет.
- Скорость: 40 токенов в секунду на выходе по данным Artificial Analysis – последний результат в первой десятке. Для интерактивной работы и для агентных циклов с сотнями вызовов это заметно.
- Кадровые потери: уход технического руководителя проекта и руководителя пост-тренинга в марте 2026 – серьёзный сигнал. Alibaba реорганизовала команду, создав межгрупповой штаб по разработке базовых моделей, но долгосрочные последствия пока неясны.
- Цензура и фильтры: у Qwen, как и у других китайских моделей, есть встроенные ограничения на обсуждение определённых политических и исторических тем. Для бизнес-задач это редко становится проблемой.
- Геополитические риски: модель принадлежит Alibaba (Китай). Для некоторых организаций это может быть ограничением при использовании облачного API. Решение – локальное развёртывание открытых версий.
- Качество на русском: несмотря на заявленную поддержку 200+ языков, ответы на русском могут уступать английским. Проверяйте на своих задачах.
- Интеграции: готовых подключений к западным сервисам – Slack, Notion, Google Workspace – значительно меньше, чем у ChatGPT или Claude. Qwen лучше интегрирован с китайскими корпоративными инструментами.
Тарифы и доступность
| Вариант | Стоимость | Для кого |
|---|---|---|
| chat.qwen.ai | Бесплатно | Попробовать Qwen без регистрации API |
| Qwen3.8-27B (скачать) | Бесплатно, Apache 2.0 | Зрение, контекст 262K, ~17 ГБ в Q4_K_M – одна видеокарта |
| Qwen3.8-Flash-Next (API / веса) | $0,16 / $0,47 за 1 млн вход/выход | Потоковые агентные задачи, до 1 млн контекста через YaRN |
| Qwen3.8-Max (API) | $2,00 / $6,00 за 1 млн, кэш $0,25 | Флагман: текст, изображение и видео, контекст 1 млн |
| Qwen 4 Coder 32B-A3B (скачать) | Бесплатно (Apache 2.0) | Кодинг на ноутбуке, 82% SWE-Verified |
| Qwen3-0.6B / 4B (скачать) | Бесплатно | Запуск на ноутбуке, полный контроль над данными |
| Qwen3-235B (скачать) | Бесплатно | Флагман локально, нужен серверный кластер |
| Qwen3.7-Plus (API, GA) | $0,40 / $1,60 за 1 млн вход/выход | Мультимодальный агент, GUI grounding, 1 млн контекст |
| Qwen3.7-Max (API) | $2,50 / $7,50 за 1 млн вход/выход | Текстовый флагман, агентные сценарии, 1 млн контекст |
| Qwen3.5-397B-A17B (API) | $0,39 / $2,34 за 1 млн вход/выход | Флагман с открытой лицензией |
Для сравнения: анализ 100-страничного отчёта через GPT-4o обойдётся примерно в $0,35, через Claude Sonnet – около $0,55. На верхнем конце разрыв больше: $10/$50 за миллион токенов у GPT-6 Astra против $2/$6 у Qwen3.8-Max.
У Qwen по-прежнему три точки входа: бесплатный чат, дешёвый облачный API и локальное развёртывание. За лето изменилась третья: 27B со зрением и обещанный открытый Max – это уже верхний уровень.
Стоит ли пробовать?
Полгода назад главный аргумент в пользу Qwen был простым: «всё то же, что у ChatGPT, но бесплатно и с открытым кодом». К весне он пошатнулся. К сентябрю вернулся – уже с более сильной линейкой.
Открытый код теперь покрывает весь диапазон задач. Qwen3.8-27B с Apache 2.0, зрением и 17 ГБ веса запускается на одной видеокарте. Flash-Next за $0,16/$0,47 тянет агентные сценарии с контекстом до 1 млн токенов, а Qwen 4 Coder и семейство Qwen 3.5 остаются в силе. Для компаний, которым нужен локальный контроль над данными, альтернатив по-прежнему немного, и эта – сильнейшая из доступных.
На большинстве задач все топовые модели сегодня дают сопоставимые результаты, и разница не очевидна в повседневной работе. Qwen 3.7 Plus закрывает мультимодальный анализ, агентные сценарии и работу с экраном – то же, что делает Claude Sonnet 5, но в несколько раз дешевле. Для массовых задач это ощутимая экономия.
Уход ключевых разработчиков и реорганизация команды – риск, который стоит отслеживать. Пока темп релизов не замедлился, но это не гарантия. Если вы строите критичные процессы на Qwen, разумно иметь запасной вариант – DeepSeek или облачные модели с более стабильной корпоративной структурой.
Осенью стоит следить за одной вещью: текстом лицензии Qwen3.8-Max. Обещание открыть флагман уже прозвучало, а условия, на которых его можно будет взять, пока никто не видел.
Инструмент есть. Теперь – навык
Фундамент – промпт-инжиниринг, критическое мышление, этика и безопасность – плюс специализации по ролям: управление людьми, проектное управление, образование. Упражнения не привязаны к одному инструменту и работают в Qwen, DeepSeek, ChatGPT и Claude. Девять практических задач менеджера доступны бесплатно и без регистрации.

Источники
- Qwen3.8-Max 0902 на OpenRouter – карточка модели: модальности, контекст, цены
- Alibaba releases Qwen3.8-Flash-Next – архитектура и цены Flash-Next
- Qwen3.8-Max: разбор DataCamp – бенчмарки и условия лицензии
- Alibaba releases Qwen3.8-Max – параметры и сроки релиза
- Qwen 3.5: полное руководство – требования к железу для открытого семейства
- Artificial Analysis – таблица моделей – индекс интеллекта, смешанная цена, скорость вывода
- LMArena (Arena.ai) – рейтинг предпочтений – текстовая и визуальная таблицы, сентябрь 2026
- Qwen Chat – бесплатный веб-интерфейс – официальный чат Alibaba, работает без регистрации
- Официальный сайт Qwen – документация и описание всех моделей
- Модели Qwen на Hugging Face – 433 открытые модели для скачивания, более 300 млн загрузок
- Репозиторий Qwen на GitHub – исходный код и документация, более 40 репозиториев
- API через Alibaba Cloud Model Studio – облачный доступ к Qwen-Plus и Qwen-Max
Stanislav Belyaev
Engineering Leader в Microsoft18 лет в управлении инженерными командами. Основатель mysummit.school. 700+ выпускников в Яндекс Практикуме и Стратоплане.