Исследования

Мат, КАПС и XML-теги: мифы промптинга против данных

10 мин чтения

«Напиши КАПСОМ – модель послушается». «Поругайся на неё – выдаст лучше». «Разбей на шаги – получишь глубокий анализ». Эти советы кочуют из блога в блог, из чата в чат. Кто-то ссылается на исследование Microsoft, кто-то – на личный опыт с ChatGPT.

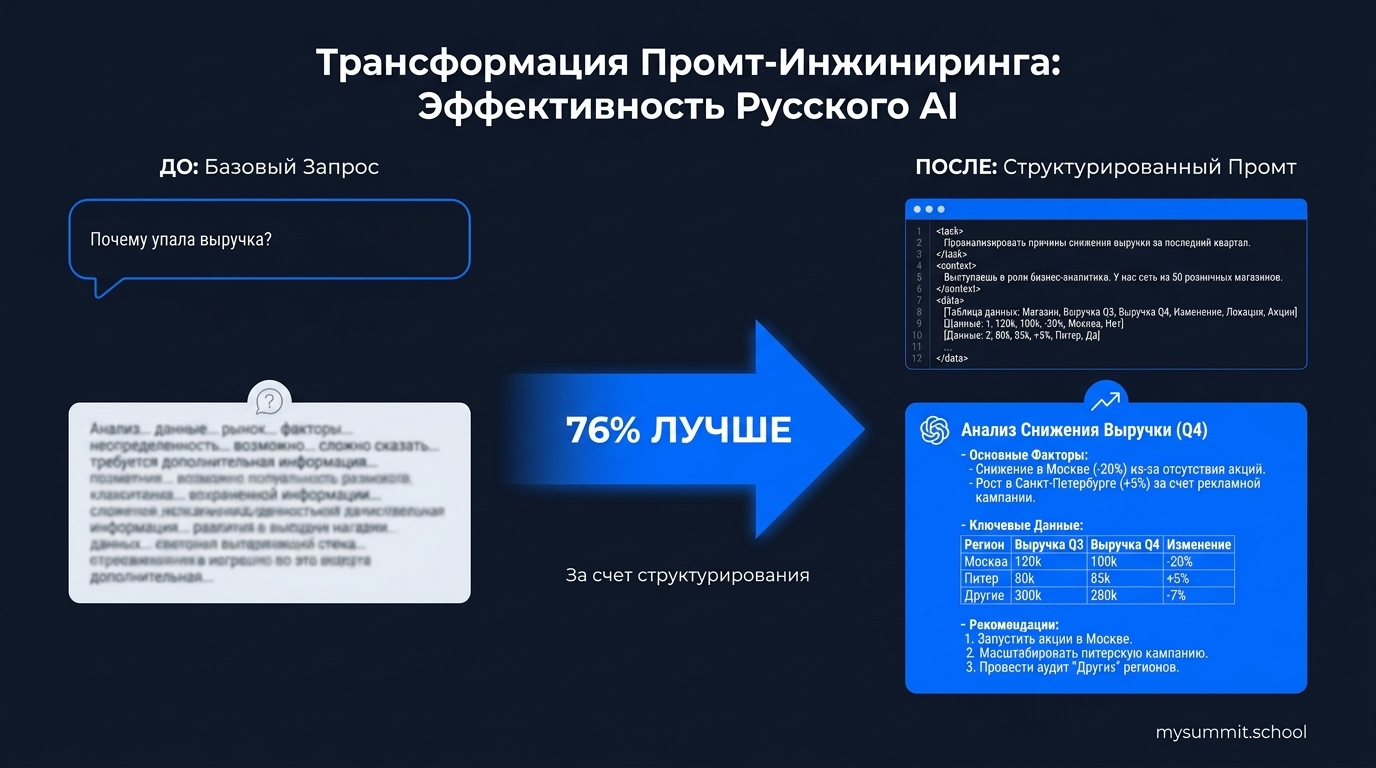
Я решил проверить – и проверил основательно. Взял четыре модели, доступные в России без VPN: GigaChat-Ultra, GigaChat-2-Max, YandexGPT и Qwen3 Max. Каждую прогнал через десять техник промптинга (способов формулировать запросы к ИИ) – от простых ролевых заданий до XML-структур. Задачи – из реальной работы менеджера: анализ выручки, подготовка записки, увольнение по ТК РФ.

Оценивали вслепую два независимых LLM-судьи. Для калибровки те же задачи решали GPT-5.4 и Claude Sonnet – чтобы зафиксировать потолок, к которому тянутся российские модели.

Если вы используете ИИ для рабочих задач – записок, писем, анализа данных – эти результаты сэкономят часы проб и ошибок.

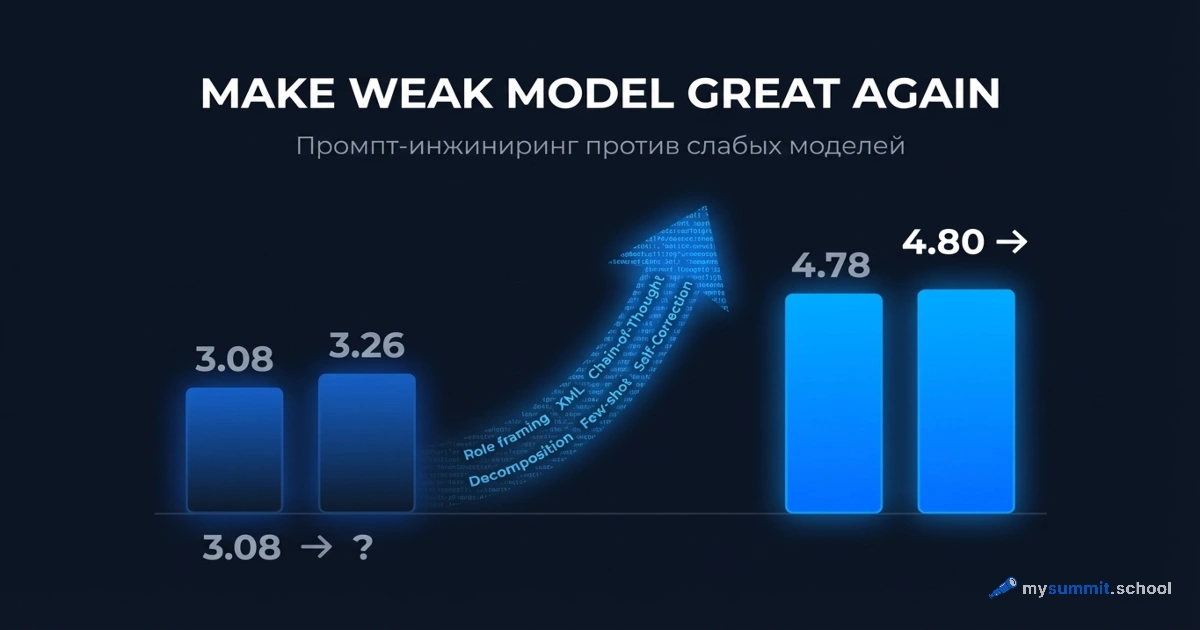
Половина популярных советов оказалась городскими легендами. Другая половина работает – но не так, как вы думаете.

Читать полностью
Мат, КАПС и XML-теги: мифы промптинга против данных
99% качества за 1,4% цены: что не так с рынком ИИ-моделей
7 мин

99% качества за 1,4% цены: что не так с рынком ИИ-моделей

Большинство менеджеров выбирают модель ИИ так: берут самую дорогую из доступных. Логика понятная – дороже значит лучше. Так работало с корпоративным софтом последние двадцать лет.

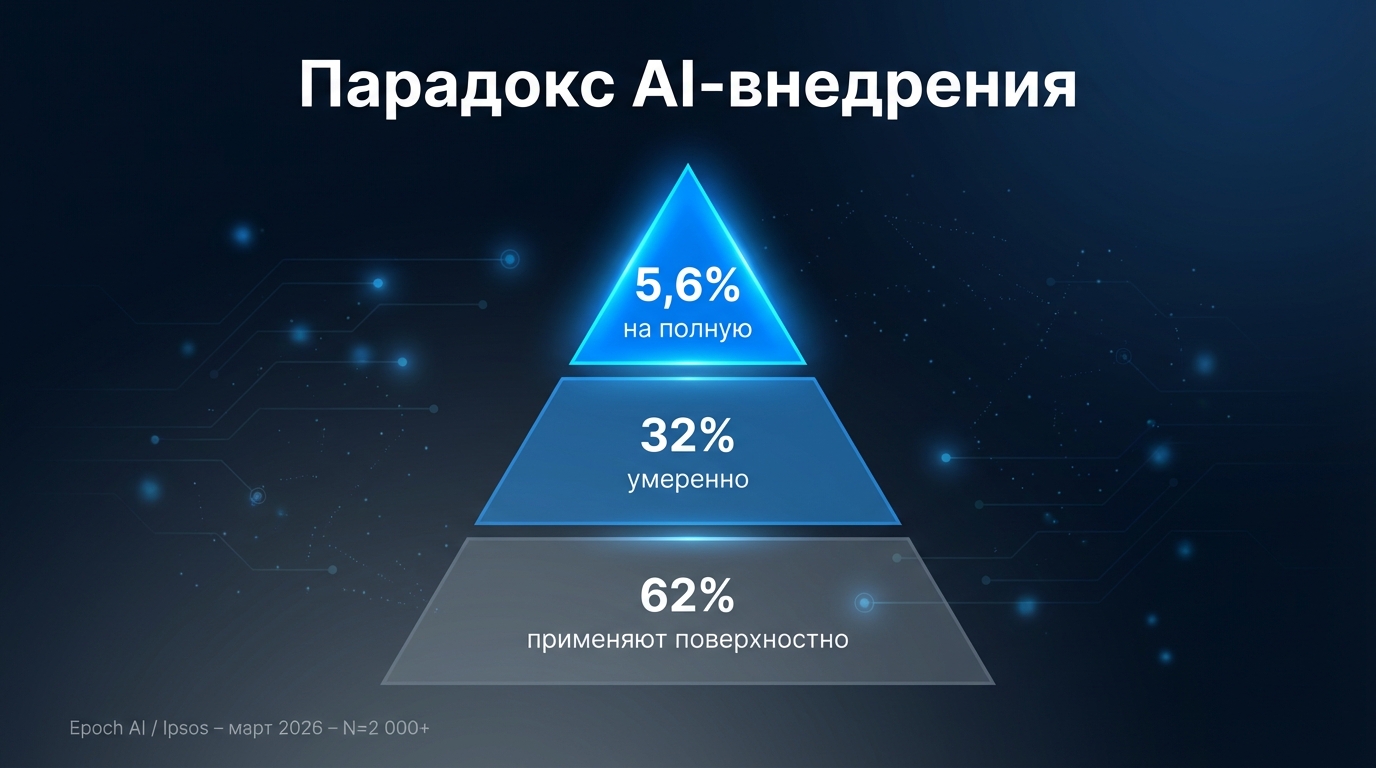
Рынок ИИ-моделей в 2026 году устроен иначе. Стоимость одного запроса варьируется от $0,0001 до $0,17 – три порядка величины. А реальная разница в качестве между десятью лучшими моделями? 0,24 балла по пятибалльной шкале. Тем временем Wharton / GBK Collective фиксируют: треть корпоративных ИИ-проектов не выходит за рамки пилота. А Epoch AI показывает, что лишь 5,6% пользователей применяют ИИ по-настоящему глубоко.

Может, вопрос не в том, какая модель лучше, а в том, даёт ли переплата за премиум пропорционально лучший результат для типичных управленческих задач.

Мы проверили. Ответ оказался жёстче, чем ожидали.

Как выжать максимум из YandexGPT: что работает, а что нет
11 мин

Как выжать максимум из YandexGPT: что работает, а что нет

Миллионы людей пользуются Алисой каждый день – не потому что выбирают, а потому что она бесплатна, встроена в Яндекс Браузер и работает без VPN. YandexGPT, модель под капотом Алисы – лучшая российская модель в нашем бенчмарке, но до GPT-5.4 ей далеко.

Можно ли получить от неё ответы, близкие к GPT, если научиться правильно спрашивать? Мы проверили это в эксперименте: десять техник промптинга, шесть управленческих задач, два независимых LLM-судьи. Короткий ответ: да, можно – но не все техники работают, а некоторые делают хуже.

Ниже – конкретные шаблоны, которые вы можете скопировать в чат прямо сейчас, и антипаттерны, которых стоит избегать.

Microsoft тихо выиграл корпоративный рынок ИИ: что это значит для руководителей
10 мин

Microsoft тихо выиграл корпоративный рынок ИИ: что это значит для руководителей

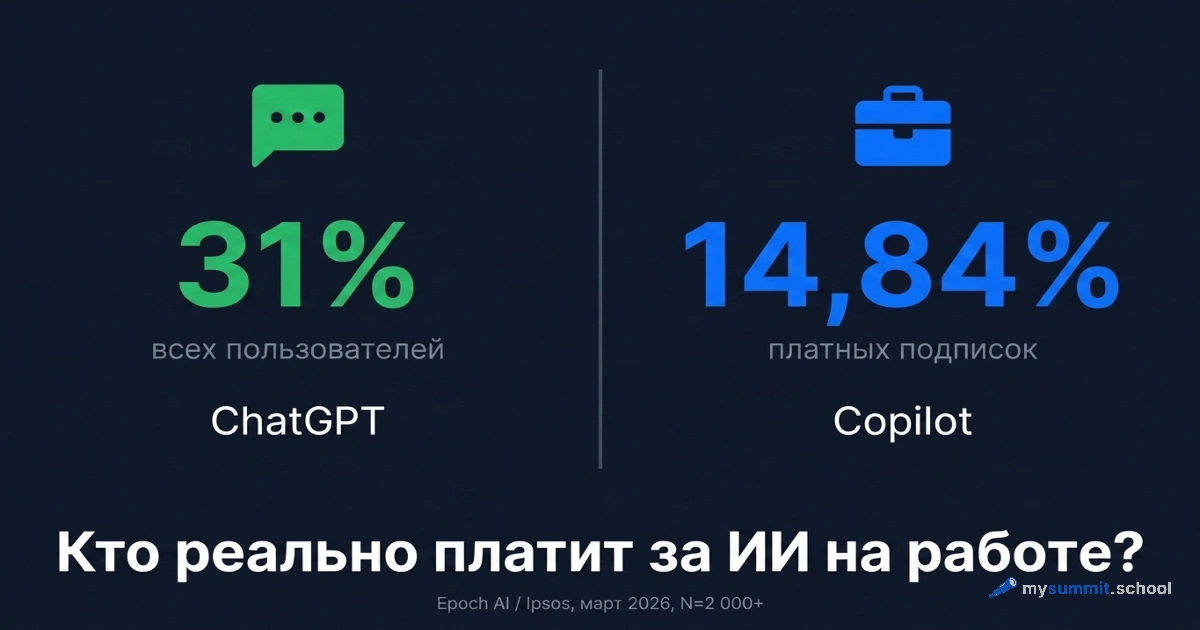
Когда вы в последний раз читали заголовок про Microsoft Copilot? Скорее всего, редко. Медиапространство заполнено новостями про GPT-5, Claude 4.7, Gemini Ultra. Copilot выглядит как скучный корпоративный инструмент, о котором пишут только в LinkedIn.

А теперь посмотрите, кто платит за что.

62% пользователей применяют ИИ на 1–2 задачи: данные Epoch AI / Ipsos (март 2026)
8 мин

62% пользователей применяют ИИ на 1–2 задачи: данные Epoch AI / Ipsos (март 2026)

В ноябре 2025 года данные Stanford показали неожиданный факт: американцы используют AI чаще дома, чем на работе. Мы в mysummit.school разбирали это в отдельном материале – и тогда вывод был прямым: рабочий AI всё ещё догоняет личный.

Прошло четыре месяца. Epoch AI совместно с Ipsos провели новое исследование – и картина изменилась.

Когда ИИ вредит обучению – и когда удваивает результат
10 мин

Когда ИИ вредит обучению – и когда удваивает результат

В марте 2025 года на SXSW EDU советник по стратегическому форсайту Синид Бовелл сделала доклад об ИИ и будущем образования. Без хайпа и без паники. Но с двумя исследованиями, которые меняют то, как стоит думать о роли ИИ в обучении.

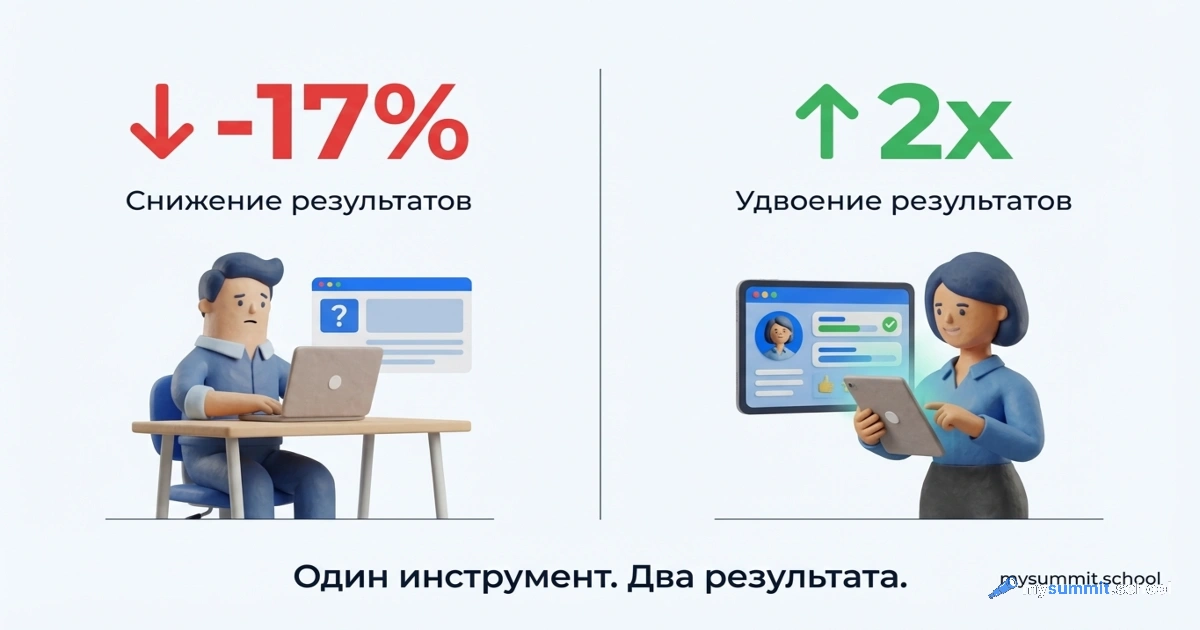
Первое: группа студентов, использовавших ChatGPT без ограничений, показала результаты на 17% хуже контрольной группы, работавшей по учебнику. Второе: другая группа, где ИИ применялся в рамках полностью переработанной учебной системы, прибавила к исходному уровню более чем вдвое больше – причём сравнивали её с занятием по методике активного обучения, а не с лекцией.

Один и тот же инструмент. Противоположные результаты. Разница – в подходе.

ИИ экономит учителю 6 часов в неделю. Но 97% этого не замечают
11 мин

ИИ экономит учителю 6 часов в неделю. Но 97% этого не замечают

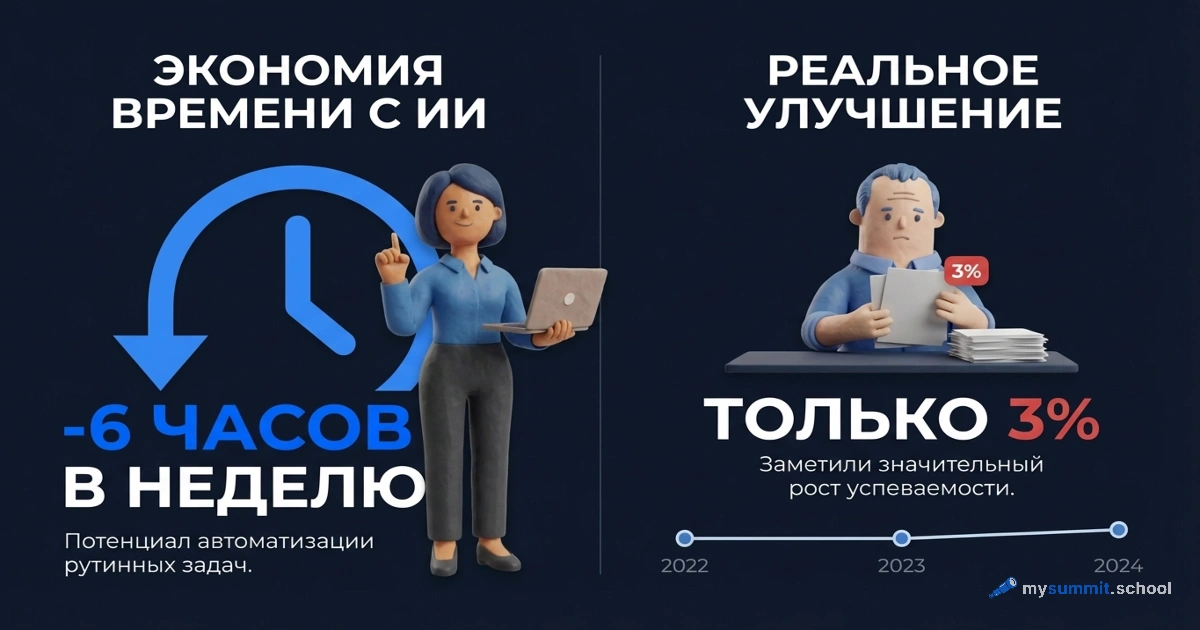
Опрос Gallup и Walton Family Foundation (2024–2025, репрезентативная выборка учителей США) зафиксировал впечатляющую цифру: преподаватели, регулярно использующие AI, экономят в среднем 5,9 часов в неделю – эквивалент шести полных рабочих недель за учебный год. Звучит как решённая проблема.

Но параллельный опрос Royal Society of Chemistry (2024, Великобритания) показывает другую картину: 44% учителей пробовали AI, но только 3% сообщили о реальном снижении нагрузки. Учитель математики из Ирландии объяснил разрыв точнее, чем любая статистика: «AI генерирует рабочие листы быстро, но их нужно тщательно проверять – и экономия времени оказывается меньше, чем казалось».

Кто прав? Мы уже разбирали кризис AI в образовании со стороны учеников – 86% школьников используют нейросети, но критическое мышление деградирует. Теперь – сторона преподавателей. За последние два года накопилось достаточно экспериментальных данных, чтобы ответить на этот вопрос не мнениями, а цифрами.

AI не делает вас тупее. Дело в том, как вы его используете
7 мин

AI не делает вас тупее. Дело в том, как вы его используете

Полтора года назад я написал заметку в личном блоге о том, что замечаю в работе коллег и в своей собственной: чем больше доверяешь AI, тем реже задаёшь себе вопрос «а это точно правильно?». Я тогда опирался на исследование Microsoft – оно показывало, что доверие к AI подавляет критическую оценку выдаваемых ответов. Аргумент казался мне сильным, но у него был очевидный изъян: корреляция, а не причинно-следственная связь.

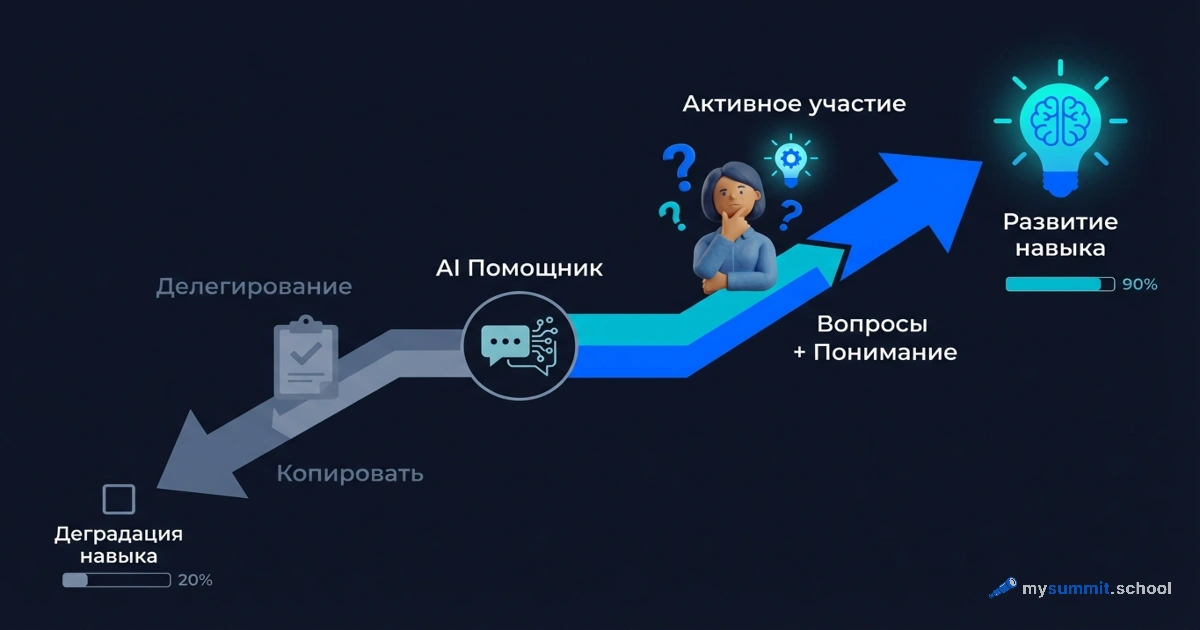
В феврале 2026 года исследователи Anthropic Джуди Шэнь и Алекс Тамкин опубликовали эксперимент, который закрыл этот пробел. Рандомизированный контроль. Конкретные данные. И вывод, который, как мне кажется, неправильно понимают большинство людей, кто о нём читал.

Потому что это не история о том, что AI делает нас глупее. Это история о том, как именно мы его используем.