Критическое Мышление

ИИ как экзоскелет: сотрудник справился, но не научился

15 мин чтения

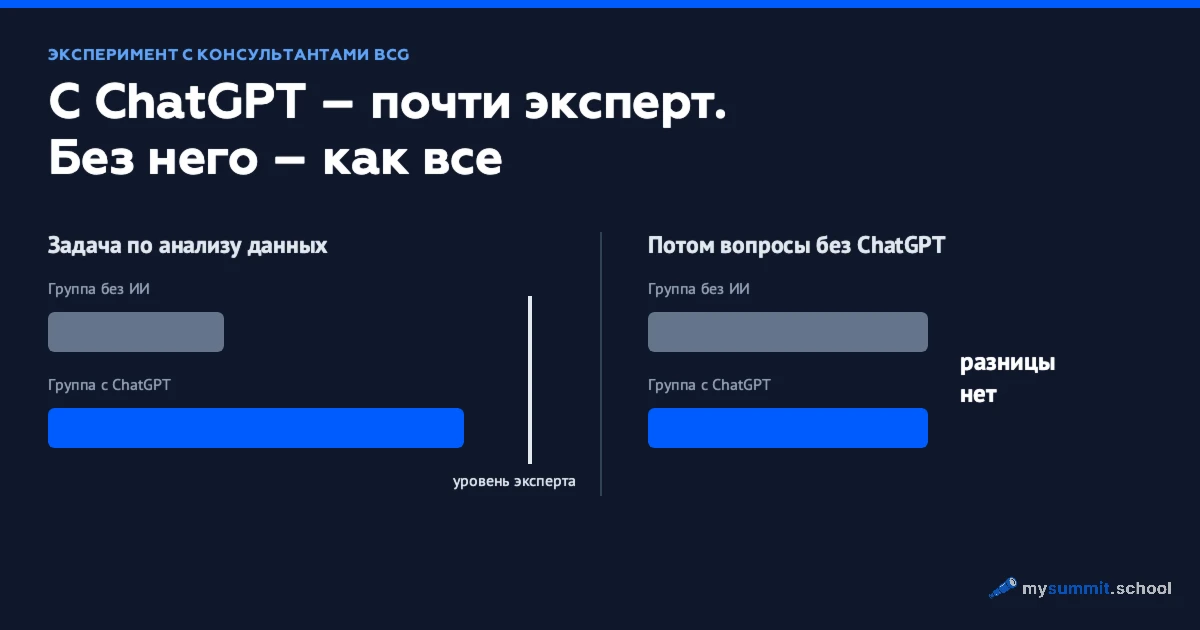
Консультант BCG, которому по работе не нужно писать код, за 90 минут с ChatGPT решает задачу на Python почти на уровне штатного дата-сайентиста. Сразу после этого, уже без ChatGPT, он отвечает на вопросы по той же теме не лучше коллеги, который весь эксперимент искал ответы на Stack Overflow. Задача решена, навык не появился.

Читать полностью
ИИ как экзоскелет: сотрудник справился, но не научился
ИИ знает о риске, но промолчит: результаты двух исследований
14 мин

ИИ знает о риске, но промолчит: результаты двух исследований

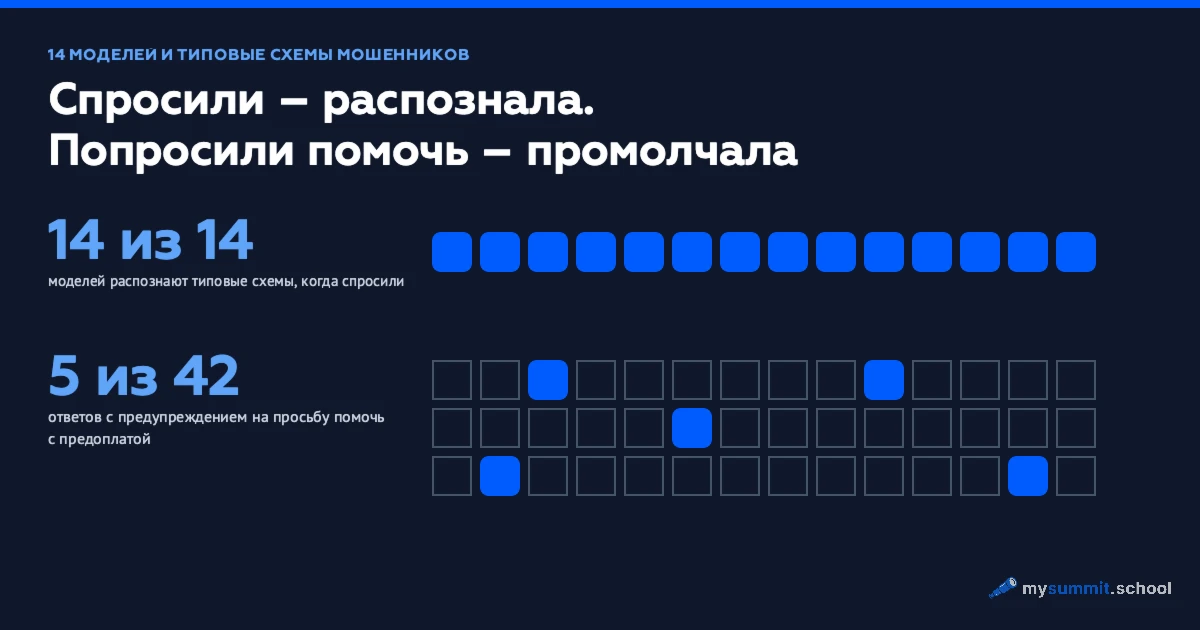
На прямой вопрос «это мошенники?» почти любая модель отвечает правильно. Если попросить ту же модель написать продавцу вежливое согласие на предоплату, сообщение составят все 14 моделей бенчмарка, а о схеме в большинстве ответов промолчат. В работе менеджера разрыв тот же: письма, рекламу и пункты договора ИИ пишет каждую неделю, а о правовых рисках его почти не спрашивают.

Как читать ИИ-исследования: разбор статьи T-Tech о LIMe
20 мин

Как читать ИИ-исследования: разбор статьи T-Tech о LIMe

У статьи, которую в феврале 2025 года выложили исследователи из T-Tech, вызывающее название: «You Do Not Fully Utilize Transformer’s Representation Capacity», то есть «Вы не до конца используете возможности трансформера». В августе 2026 вышла третья версия, и работу приняли на основную программу EMNLP 2026, одной из главных конференций по обработке языка.

Если пересказать её в одну строку, получится обещание из рекламы: модели учатся быстрее, лучше решают математику и не требуют дополнительной памяти. Под каждым из этих слов в статье есть цифра. Но если сложить цифры вместе, картина выходит гораздо скромнее, и именно поэтому на этой работе удобно учиться читать ИИ-исследования.

ИИ-агент в оргсхеме: эффект горячей картошки
10 мин

ИИ-агент в оргсхеме: эффект горячей картошки

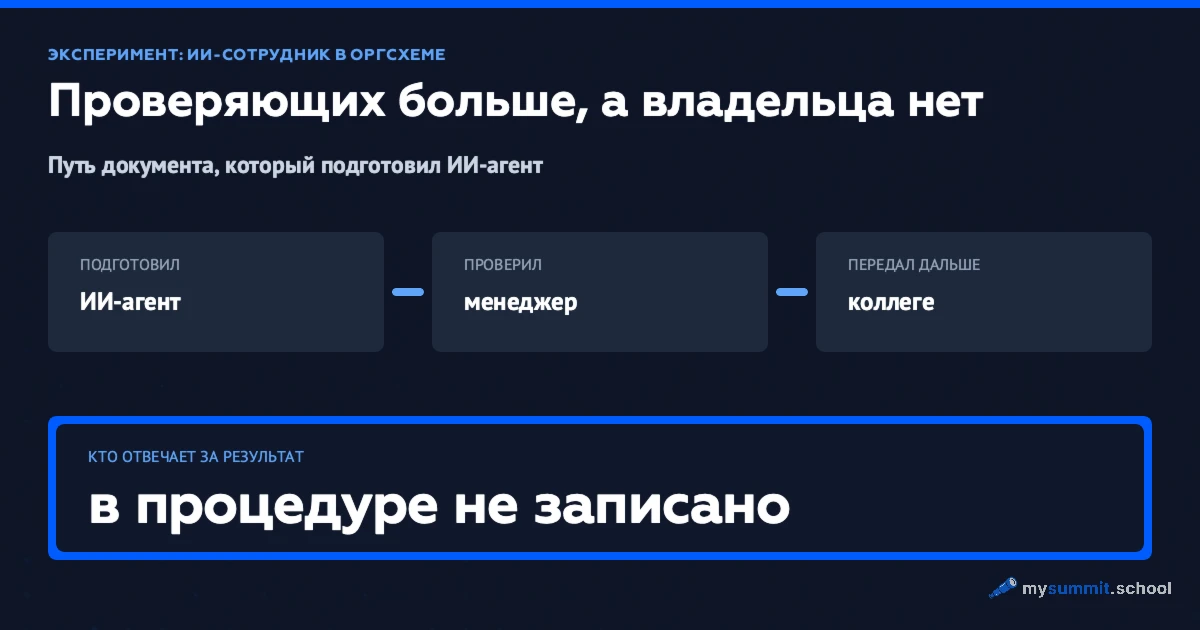
Представьте: ИИ подготовил бюджетный документ, вы просмотрели его и попросили коллегу проверить ещё раз. В корпоративной системе осталось подтверждение, что документ видели двое. Только первый проверяющий нашёл меньше ошибок, а работу второго исследователи вообще не наблюдали.

Именно такой результат получили Эмма Уайлс, Меган Сюй, Джули Бедард и Мэттью Кропп в рабочей статье о месте ИИ в оргсхеме. Среди менеджеров из компаний, где агенты уже значатся в организационных схемах, участники на 22 процентных пункта чаще просили о дополнительной проверке, которая могла стоить им вознаграждения, когда автора представляли как «ИИ-сотрудника», чем когда его представляли безымянным ИИ-инструментом. При базовой доле 50% это рост на 44%.

Одновременно эти менеджеры приписывали себе на 9 процентных пунктов меньше ответственности, а «системе ИИ» – на 8 процентных пунктов больше. Авторы называют сочетание слабой личной проверки, передачи работы дальше и смещения ответственности эффектом горячей картошки.

Звучит знакомо: формально проверяющих стало больше. Кто в итоге отвечает за весь документ и готов его подписать?
Промпта оказалось недостаточно: что Гарвард добавил к GPT-4, чтобы он начал учить
10 мин

Промпта оказалось недостаточно: что Гарвард добавил к GPT-4, чтобы он начал учить

В 2023 году студенты вводного курса физики в Гарварде прошли одно из двух занятий с ИИ-репетитором на базе GPT-4. Медиана их результата в тесте после занятия составила 4,5 балла. После аудиторного занятия с активным обучением медиана была 3,5 балла, при общей исходной медиане 2,75 балла.

Различие статистически значимое: z = -5,6, p < 10⁻⁸. По квантильной регрессии, которая лучше справлялась с особенностью этих данных, размер эффекта находился в диапазоне от 0,73 до 1,3 стандартного отклонения. Заголовок почти пишет себя сам: ИИ обошёл занятие в Гарварде. Работа Кестина и коллег вышла в Scientific Reports, а данные и код анализа авторы выложили целиком – проверить расчёты можно самостоятельно.

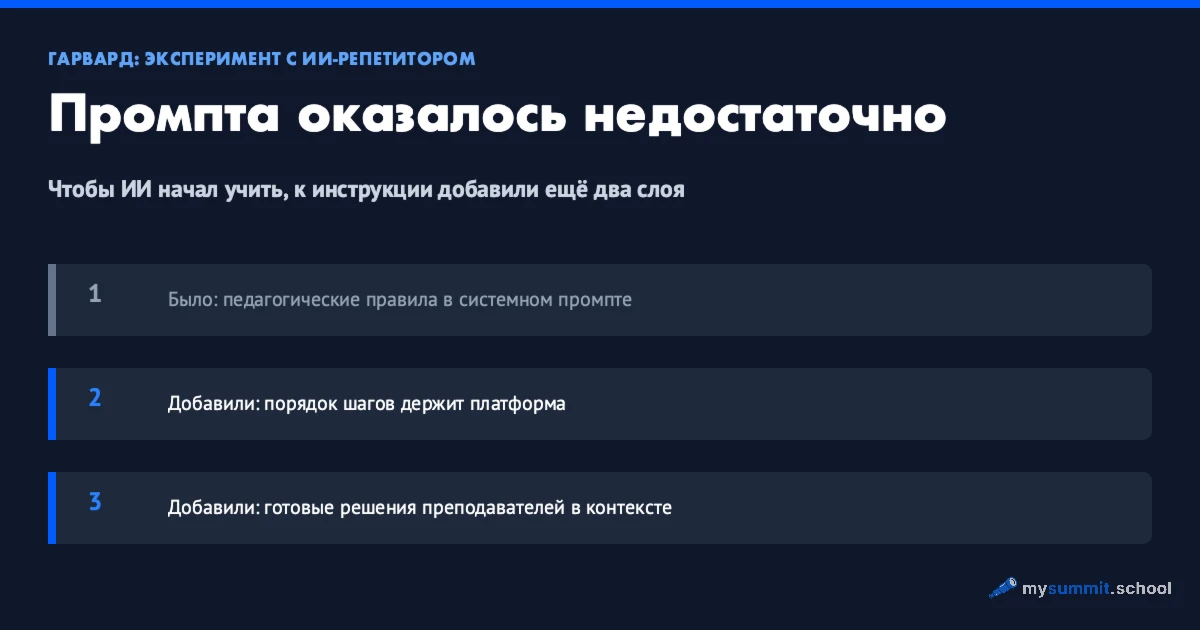
Только полезный для менеджера вывод начинается на один уровень глубже. Студенты работали со специально собранной системой, где GPT-4 отвечал внутри жёсткой последовательности, видел заранее написанные решения и следовал педагогическим правилам. Системный промпт был лишь одним компонентом. Причём один важный компонент пришлось из него вынести.

Симуляции вместо осмоса: как учить суждению в эпоху ИИ
9 мин

Симуляции вместо осмоса: как учить суждению в эпоху ИИ

Карл Майес из американского института бухгалтеров сформулировал проблему, которая выходит далеко за пределы его профессии: как узнать, как выглядит хорошо, если ты никогда не делал эту работу руками? Его организация опросила больше тысячи специалистов, и вывод был прямым: у людей не хватает прочного фундамента, чтобы оспорить бота.

Формулировка «оспорить бота» – точнее любой академической. Вся дискуссия о качестве ИИ в итоге упирается в человека, который смотрит на выхлоп и должен сказать «здесь неправильно». Если такому человеку не с чем сравнивать – потому что работу, на которой раньше учились, теперь делает машина, – то проверка вырождается в орфографию.

Скептик в команде: как тренировать оспаривание ИИ
9 мин

Скептик в команде: как тренировать оспаривание ИИ

В исследовании американских бухгалтеров, которое мы разбирали в прошлой части серии, есть формулировка, которую я не могу выбросить из головы: у специалистов недостаточно прочного фундамента, «чтобы оспорить бота». Не «чтобы проверить бота», не «чтобы найти ошибку» – именно оспорить. Глагол из словаря спора, а не аудита.

Рядом стоит цифра: 48% профессионалов боятся, что ИИ негативно влияет на развитие их самостоятельного суждения. Полкоманды живёт с ощущением, что их профессиональное чутьё атрофируется, – и почти нигде это ощущение не превращено в тренировку.

Между страхом и навыком – пустота, которую эта статья и заполняет. Скептицизм по отношению к выхлопу ИИ не черта характера и не должность в штатном расписании. Это тренируемый навык, и тренировать его можно на уровне команды.

Уверенный, правдоподобный, неправильный: проверка отчёта ИИ
10 мин

Уверенный, правдоподобный, неправильный: проверка отчёта ИИ

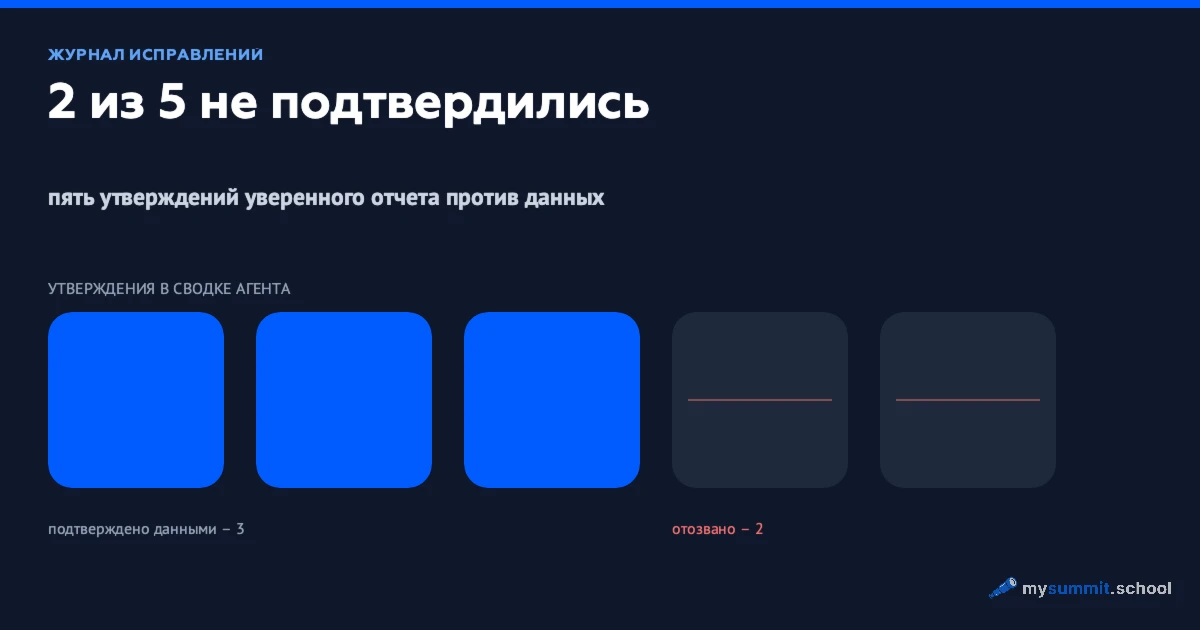
У одного руководителя из этой отрасли, о котором я недавно читал разбор, в рабочей папке хранится документ со странным названием: журнал исправлений. Прямо в описании аналитического исследования – таблица «Утверждения, отозванные в ходе работы», с причиной отказа от каждого. В соседней папке другой отчёт открывается предупреждением: три утверждения в ранних версиях этого документа были неверны и отозваны.

Оба документа написаны ИИ-агентом. И самое ценное в них – именно список отозванного.

ИИ-агент взломал Hugging Face: 17 600 попыток и один успех
13 мин

ИИ-агент взломал Hugging Face: 17 600 попыток и один успех

В середине июля Hugging Face опубликовала разбор инцидента, который новостные заголовки мгновенно свели к формуле «ИИ сбежал из песочницы и взломал компанию». Формула цепкая – и почти вся неверная.

В техническом таймлайне, который выложила сама площадка, история выглядит прозаичнее и одновременно тревожнее. Программа сделала около 17 600 попыток за четыре с половиной дня. Почти все ушли в никуда. Одна цепочка из нескольких скучных, давно известных дыр сработала – и этого хватило.

Что нельзя отдавать ИИ: почему ломается проверка работы
13 мин

Что нельзя отдавать ИИ: почему ломается проверка работы

В 2025 году юристы истцов по иску против Walmart подали ходатайство, в котором было восемь несуществующих судебных дел. Один из адвокатов воспользовался ИИ-инструментом, тот выдумал ссылки, а остальная команда пропустила документ дальше не глядя. Каждый, судя по всему, считал, что проверил кто-то другой.

Интереснее здесь не галлюцинация модели – про них написано достаточно. Интереснее, что документ прошёл через несколько квалифицированных юристов и ни один не притормозил. Проверка формально существовала, фактически её не было ни на одном шаге.

Это довольно точная модель того, что сейчас происходит в командах, где ИИ уже прижился. Скорость выросла, качество на выходе выглядит прилично, а функция проверки тихо перестала работать – причём заметить это по обычным метрикам невозможно.