Claude Code

Кодинг-агенты 2026: два форм-фактора – терминал и десктоп

25 мин чтения

К сентябрю 2026 кодинг-агента выпустил каждый вендор моделей: Anthropic, OpenAI, Google, Microsoft, xAI, DeepSeek, Moonshot, Alibaba, Z.ai, Tencent. К середине года Claude Code, Cursor, Codex и Antigravity сошлись на одной схеме агентного кодинга – программа читает файлы, правит их, запускает команды, проверяет результат и отчитывается. Различия остались в упаковке, ценах и экосистеме, поэтому алфавитный перечень из десятка названий читателю ничего не даст.

Полезное разделение проходит по форм-фактору. В терминале живут агенты для инженеров: Claude Code, Codex CLI, Antigravity CLI, Grok Build, Kimi Code CLI, Qwen Code. Менеджер там не работает, но платит за них он – и понимать, за что именно, ему нужно. На десктопе – агенты для офисных задач: Claude Cowork, Copilot Cowork, Kimi Work, Tencent WorkBuddy. Вот эти сделаны для менеджера и его команды: HR, операционка, администрирование, проекты, продажи. Разложить файлы, собрать отчёт, обработать чеки, привести таблицы в порядок.

Читать полностью
Кодинг-агенты 2026: два форм-фактора – терминал и десктоп
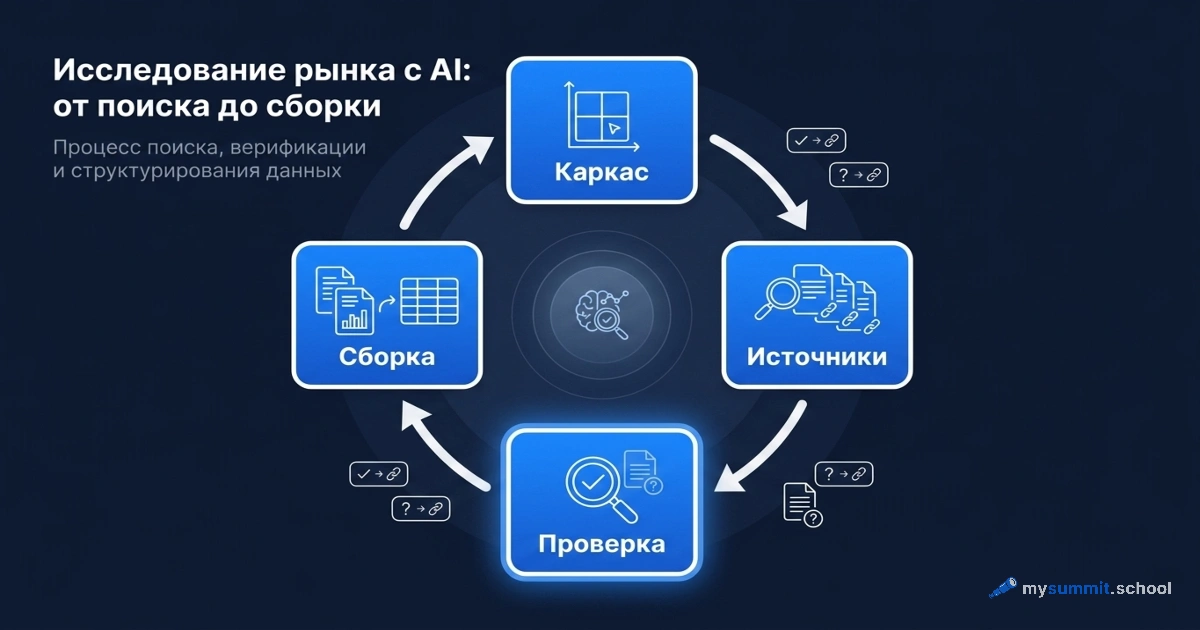
Агентский ресёрч конкурентов: цикл с поиском и проверкой
11 мин

Агентский ресёрч конкурентов: цикл с поиском и проверкой

В предыдущем материале «Анализ конкурентов с ИИ: где модель выдумывает факты» мы показали, как наивный чат-бот сочиняет конкурентов: пять компаний в списке, две не существуют, обороты назначены на глаз. Рецепт там был один – проверять каждый факт руками. Но есть способ сократить количество выдумок ещё до проверки: проводить ресёрч не в чате, а в агентском инструменте, который сам ищет, открывает страницы и сверяет найденное за несколько итераций.

Этот материал – практический цикл такого ресёрча: от настройки инструмента до проверенного результата. Тот же пример, что и раньше, – оборудование для установок замедленного коксования (УЗК) для НПЗ. Боль та же, но инструмент другой.

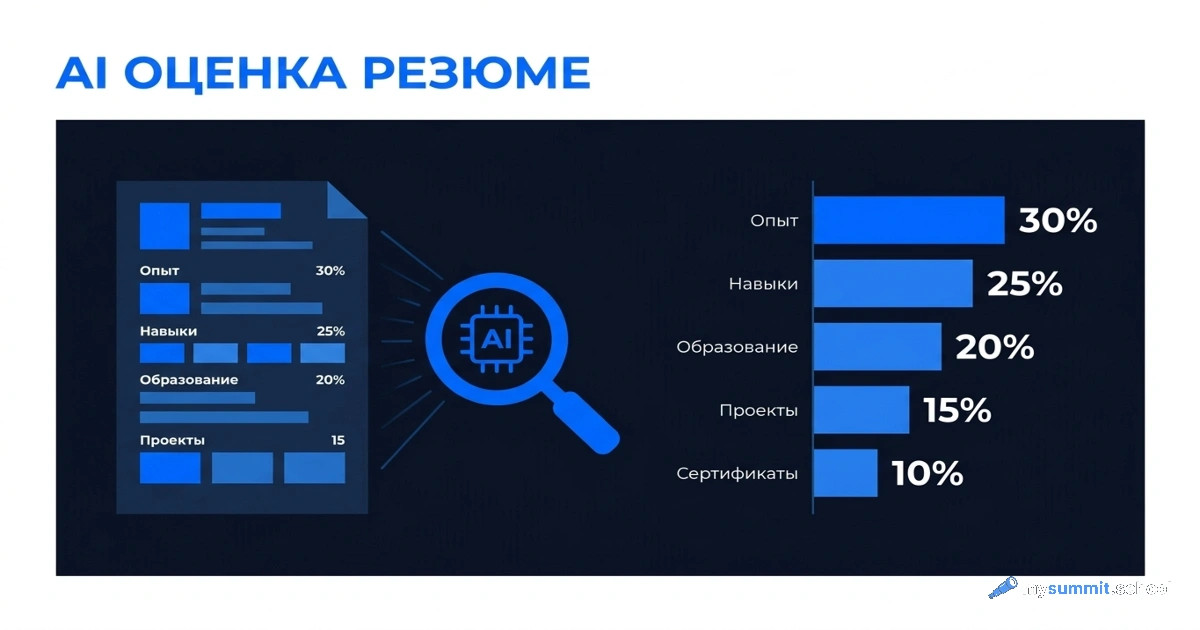
Как я построил систему оценки резюме на AI-агенте (и почему первая версия была бесполезной)
8 мин

Как я построил систему оценки резюме на AI-агенте (и почему первая версия была бесполезной)

89% британских рекрутеров планируют увеличить использование AI в найме в этом году. Кандидаты в ответ пишут резюме через ChatGPT. Компании получают сотни одинаково отполированных документов и фильтруют их алгоритмами. CEO Adecco Group подсчитал: в среднем нужно 200 заявок, чтобы получить один оффер. Гонка вооружений, где обе стороны используют одну и ту же технологию.

За четыре месяца я создал больше 20 адаптированных резюме – одни и те же данные, радикально разные документы. Каждое адаптировано под конкретную вакансию: для одной компании акцент на платформенную инженерию, для другой – на масштабирование команд, для третьей – на трансформацию процессов. Данные одни, но перестановка приоритетов меняет всё.

Проблема – как понять, что резюме работает, до того как рекрутер его увидит? Грамматику проверит любой инструмент. Мне нужен был синтетический «первый читатель» – тот, кто смотрит на документ глазами нанимающего менеджера и говорит: «Я бы позвал на интервью» или «Я бы прошёл мимо».

P5.express и агентный ИИ: где помогает, где ломает
22 мин

P5.express и агентный ИИ: где помогает, где ломает

В PMI-мире принято думать о портфельном управлении как о чём-то монументальном: комитеты, Tableau, сотни полей в Jira, еженедельные статус-митинги с колодой слайдов. P5.express предлагает другое. Три цикла, пять документов, две роли. Система умещается на одном листе.

Именно к такой системе разумно приставить агентный ИИ: минималистичная архитектура понятна, роли чёткие, данные структурированы. Но «разумно» не значит «везде». Некоторые части P5.express при автоматизации перестают работать – не потому что ИИ плохой, а потому что смысл этих частей именно в человеческом процессе.

Ниже – разбор по каждому циклу. Что стоит делегировать агенту, что лучше оставить людям, и какая модель для этого подходит в реалиях России.

Агент вместо чата: анализ данных без copy-paste
12 мин

Агент вместо чата: анализ данных без copy-paste

У вас три файла с данными: воронка активации, результаты A/B-теста и тикеты поддержки. Задача – понять, почему онбординг проседает. Вы открываете ChatGPT, загружаете первый файл, задаёте вопрос. Получаете ответ. Загружаете второй файл. ChatGPT спрашивает: «Можете напомнить контекст?» Загружаете третий. Контекст первого файла уже вытеснен.

Через сорок минут у вас три отдельных разговора, ни один из которых не отвечает на исходный вопрос. Потому что вопрос был один, а данные – в трёх местах.

Это не проблема ChatGPT. Это проблема подхода.