Зависимость команды от ИИ: три стресс-теста для менеджера
AI-модели в этой статье
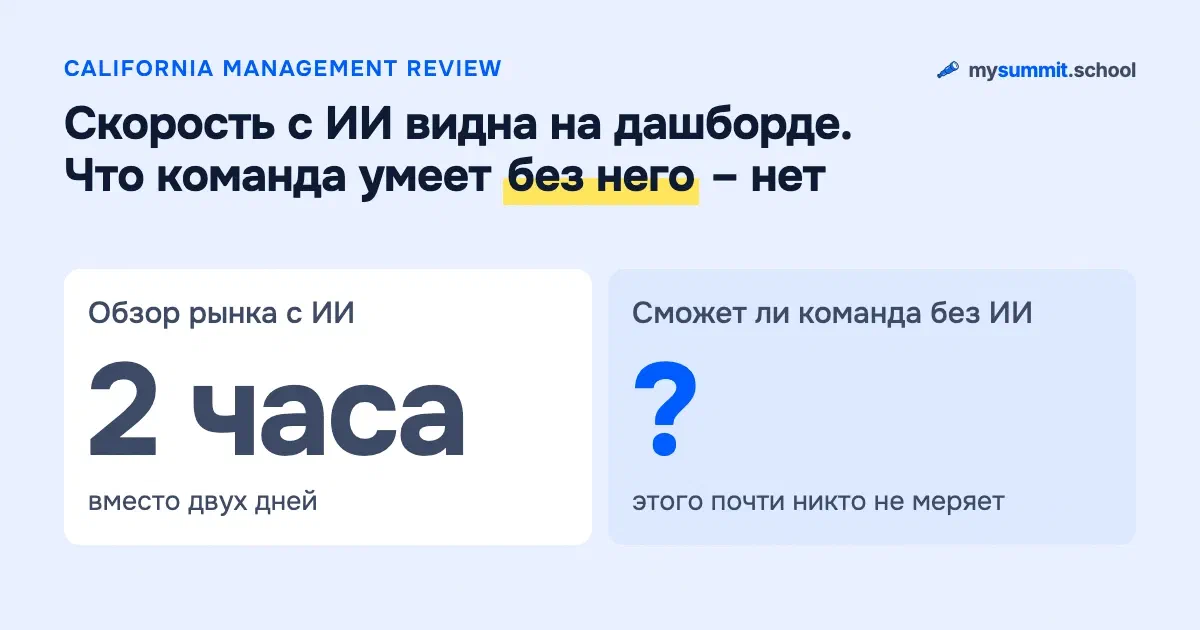
В феврале 2024 года Klarna объявила, что её ИИ-ассистент делает работу 700 операторов поддержки, а среднее время решения обращения, по данным самой компании, упало с 11 минут до двух. Через полтора года Associated Press написало, что компания вернула небольшую группу живых сотрудников для сложных случаев вроде кражи личности.
Эту историю обычно рассказывают как провал ИИ. Кристоф Траттнер, профессор Бергенского университета, в свежей колонке California Management Review аккуратнее: из неё не следует, что сотрудники Klarna что-то разучились делать. Зато она хорошо показывает вопрос, на который метрики эффективности не отвечают вообще. Что должно остаться внутри компании, когда автоматизация упирается в свой предел?
Дашборд по ИИ считает, сколько добавил инструмент: часы, тикеты, стоимость обращения. Что команда умеет без него и насколько велика её зависимость от ИИ, не считает почти никто. Ниже – рабочий набор из этой колонки, который можно запустить в своей команде, готовое упражнение для второго теста и разбор данных, на которые всё это опирается. Данные, сразу скажу, расходятся сильнее, чем принято писать.
Две цифры вместо одной
Траттнер вводит понятие residual capability. По-русски проще сказать так: то, что команда понимает, оценивает и умеет сделать сама, когда ИИ недоступен, поменялся или уверенно выдал неверный ответ. Я буду называть это собственной квалификацией. Рядом с ней стоит привычная продуктивность с ИИ, и это два разных измерения. Одно может расти, пока другое падает.
Пример из колонки. Аналитик делает обзор рынка за два часа вместо двух дней – реальный выигрыш. Но модель заложила в расчёт неверное допущение, и вывод получился вполне правдоподобным. Заметит ли аналитик? Сможет ли он пересобрать главное, если клиент запретит пользоваться ИИ? Если да, ИИ ускорил работу и ничего не отнял. Если нет, продуктивность компания всё равно получила, а вот проверять эту продуктивность внутри уже некому.
Главное в колонке вот что: умение получить ответ и умение его оценить – разные навыки, и второе само по себе не сохраняется, когда автоматизируют первое. Код пишет модель, а отвечает за падение продакшена человек. Финансовый анализ готовит ИИ, а подписывает решение директор. Кто-то внутри должен понимать достаточно, чтобы увидеть подвох.
Траттнер напоминает, что похожая история уже была в авиации. В 1983 году Лизанна Бейнбридж описала «иронии автоматизации»: чем надёжнее автомат, тем меньше практики у человека, который его контролирует, и тем тяжелее те редкие ситуации, когда вмешаться всё-таки нужно. В 2013 году американское авиационное ведомство FAA, как пишет Траттнер, предупредило авиакомпании, что постоянный полёт на автопилоте ослабляет навыки ручного пилотирования. Автопилот после этого никто не отключил, он сделал полёты заметно безопаснее. Отрасль стала регулярно поддерживать то, что под ним: на тренажёрах пилоты летают с выключенной или сбоящей автоматикой. В умственной работе такой практики пока почти нигде нет.
Что на самом деле показывают исследования
Тексты на эту тему часто опираются на одну работу и делают вывод «ИИ отупляет». Траттнер приводит три эксперимента, и выводы у них разные.
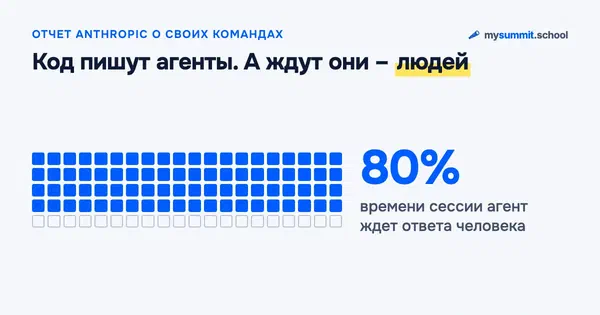
Самый известный – эксперимент Anthropic: 52 в основном начинающих разработчика осваивали незнакомую библиотеку Python. Группа с ИИ набрала на итоговом тесте в среднем 50% против 67% у группы без ИИ, сильнее всего разрыв проявился в отладке. Быстрее с ИИ при этом не стало. Шесть паттернов работы с моделью мы подробно разбирали в отдельной статье, здесь важно другое: способы использования ИИ участникам не назначали случайно, это наблюдение, и долгосрочное запоминание не измеряли.
Гильермо Крусес с соавторами провели рандомизированный онлайн-эксперимент с 1174 взрослыми из Аргентины в возрасте 25–45 лет. Задача деловая: письмо от начальника, несколько источников данных, нужно найти причину проблемы и предложить решение. Ассистент на GPT-4.1 поднял итоговый балл у всех, сильнее всего у участников без высшего образования: их отставание от остальных сократилось примерно на три четверти. Потом ассистента убрали и дали короткий модуль без ИИ: получавшие помощь справились не хуже контрольной группы, а участники без высшего образования сохранили часть прироста.
Третий – эксперимент Контрактор и Рейеса на 211 студентах в аудитории под присмотром. Студенты изучали незнакомую тему и писали эссе с ИИ или без него, потом сдавали тест без всяких подсказок – сразу и через неделю. Сразу после эссе группа с ИИ набрала на тесте на 7,2 процентного пункта больше контрольной, у которой в среднем было около 56%. Через неделю разница сократилась до 3,9 пункта, но не исчезла.
Самое полезное для менеджера повторяется во всех трёх работах. У студентов преимущество через неделю сохранилось у тех, кто использовал ИИ как репетитора, и пропало у тех, кто отдал модели написание текста. У Крусеса без ИИ лучше справлялись те, кто и с ассистентом много работал над задачей сам. В эксперименте Anthropic лучше усвоили материал те, кто задавал модели вопросы на понимание. Это корреляции, способ работы никому случайно не назначали. Но направление одно.
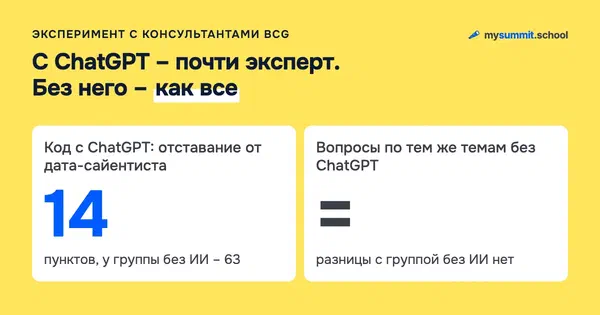
Рядом стоит положить две работы, которые мы уже разбирали. Консультанты BCG с ChatGPT решали задачи анализа данных почти как эксперты, а без него знали не больше контрольной группы. А у 26 811 китайских школьников оценки за домашние задания с ИИ пошли вверх, а результаты закрытых экзаменов – вниз.
Что из этого следует? Что прогноза у нас нет. ИИ может усилить квалификацию, оставить её как была или занять место той работы, на которой она раньше росла. Какой из трёх вариантов происходит в вашей команде, по чужим экспериментам не определить. Это нужно измерить у себя, и дальше – как именно.
Начинать проверку удобнее с себя. Заметить, что ИИ решает задачу за вас, трудно как раз потому, что результат выглядит хорошо: текст гладкий, цифры на месте. Видно это становится только на задаче, где правильный ответ известен заранее.
Четыре состояния процесса
Траттнер предлагает оценивать каждый процесс, где работает ИИ, по двум осям: насколько хорош результат с ИИ и сколько квалификации осталось у людей без него. Получается матрица из четырёх клеток.
| Собственная квалификация сильная | Собственная квалификация слабая | |
|---|---|---|
| Результат с ИИ высокий | Настоящее усиление: люди быстрее и при этом могут оспорить ответ модели, разобрать исключение, пересобрать рассуждение | Зависимость: по обычным метрикам всё отлично, но результат держится на том, что ИИ работает как ожидалось |
| Результат с ИИ низкий | Недоиспользованная экспертиза: знания есть, а встроить ИИ в работу пока не получилось | Неудачное внедрение: слабо и то и другое |
Две вещи в этой матрице легко понять неправильно. Первая: зависимость не обязательно плоха. Траттнер прямо пишет, что она может быть разумным выбором. Отдел маркетинга спокойно живёт с почти полной зависимостью от ИИ в черновиках рутинных текстов. Банк, который оценивает кредитный риск, или инженеры, проверяющие проект на безопасность, так рисковать не могут. Вопрос по каждому процессу один: хватает ли оставшейся квалификации на тот риск, который он несёт.
Вторая: матрица не объясняет причин. Неудачное внедрение могло случиться из-за плохого обучения, кривого процесса или самого инструмента, а могло быть и до ИИ. Без исходного замера не понять, что изменилось.
Возьмите для примера три процесса команды проекта. Еженедельные статусы для руководства собирает ИИ, руководители проектов давно перестали писать их сами, и это никого не беспокоит: формат простой, ошибку быстро видно, писать вручную можно научиться за неделю. Это зависимость, и её можно оставить. Оценку сроков джун делает с ИИ, и оценки стали аккуратнее, но объяснить, откуда взялись цифры, он не может. Это тоже зависимость, только уже опасная. Разбор рисков старший менеджер делает сам, а ИИ просит найти, что упущено. Это усиление.
Что оставить внутри: три вопроса
Сохранять все навыки, которые были до ИИ, бессмысленно, иначе зачем автоматизировать. Траттнер предлагает решать явно, что можно отдать, и задать про каждый процесс три вопроса.
Насколько дорого обойдётся ошибка, если ИИ ошибся, а человек не заметил? Корявая фраза в рассылке – одно, неверное инженерное решение, документ для регулятора или инвестиционная рекомендация – совсем другое.
Сколько времени уйдёт на восстановление навыка? Шаблонный отчёт можно научиться писать за неделю. Чутьё на риски в проекте или умение вести сложные переговоры набираются годами практики и разбором трудных случаев. С такими навыками Траттнер советует быть особенно осторожными: их легко потерять просто потому, что рутинная часть работы стала незаметной.
Переносится ли процесс на другую модель или поставщика? Или он завязан на одну модель, её интерфейс, её особенности поведения? Обычная оценка поставщика спрашивает, переносима ли технология. Траттнер предлагает спрашивать ещё и о том, переносима ли квалификация людей.
Процесс, где ошибка дорогая, навык набирается годами, а работа держится на одной внешней модели, требует совсем другого отношения, чем дешёвая рутина, которую легко переделать и купить у кого угодно. Расставьте по каждому вопросу оценку от 1 до 3 – и «ИИ отупляет команду» превращается из смутной тревоги в список конкретных решений, которые можно записать и пересмотреть.
Три стресс-теста для команды
Для того, что вы решили оставить внутри, самоотчётов и сертификатов о прохождении курса мало. Траттнер предлагает три упражнения. Проводить их нужно на учебных задачах или в контролируемой среде, на типовой работе, с порогами качества, согласованными заранее. Рабочие сервисы при этом продолжают работать как обычно.
Без ИИ
Временно уберите ИИ из критичной задачи. Главная ловушка здесь – сравнивать скорость. Скорость с ИИ – часть того, ради чего его внедряли, и догнать её руками никто не должен. Смотреть нужно на качество: удержит ли команда минимально приемлемый уровень. Сможет ли человек восстановить главное рассуждение, найти факты, пройти медленный запасной путь и понять, в какой момент звать эксперта. Записывайте качество, время и сколько раз понадобилась помощь. И повторяйте то же упражнение через несколько месяцев. Падение результата сразу после того, как забрали полезный инструмент, показывает только зависимость сегодня. Теряется ли навык, видно по второму замеру.
ИИ ошибся
Недоступная система обычно доставляет меньше проблем, чем система, которая уверенно ошибается. Дайте людям правдоподобный результат ИИ с одной важной ошибкой. Пример Траттнера: кредитному специалисту – кредитное заключение, где прогноз денежного потока незаметно опирается на прошлогодние процентные ставки. Инженерам – проверку безопасности, в которой пропущен один сценарий нагрузки. Оценивать нужно три уровня: нашёл ли человек ошибку, может ли объяснить, почему это ошибка, и знает ли, какие данные её закроют. Как построить саму проверку ответа модели, мы разбирали в статье о промпте, который ловит ошибки. В упражнении проверяют уже людей.
Смена модели
Модели обновляют, снимают с поддержки, поднимают на них цены, ограничивают доступ, и поведение может поменяться при том же интерфейсе. В России это особенно знакомо: доступ к части моделей может пропасть в любой момент. Проверяется, сможет ли команда перенести процесс на другую модель и переписать промпты и проверки, понимая, что именно текущая модель в процессе делает. Траттнер разделяет два случая. Если процесс не переживает смену поставщика, это операционная зависимость. Если команда без поставщика не понимает собственный процесс, это уже зависимость квалификации.
Что считать провалом, решают до упражнения: торговаться о порогах после него поздно. Пропущенная ошибка в дорогом процессе, оценка ниже порога или ухудшение между двумя раундами одного упражнения запускают заранее оговоренный ответ: обучение, перестройку процесса, более надёжный запасной вариант или осознанное решение принять зависимость.
Траттнер оговаривается, и я с ним согласен: возвращать ручной труд ради него самого смысла нет. Иногда самый ценный навык как раз новый: оценивать ответ модели, ставить контрольные точки, переносить процесс между поставщиками. Тесты «ИИ ошибся» и «смена модели» измеряют его.
Попробуйте: упражнение «ИИ ошибся» для своей команды
Ниже – заготовка для второго теста на типовой проектной ситуации. Аналитик с ИИ собрал служебную записку о подписании договора с подрядчиком, в ней есть правдоподобные ошибки. Промпт готовит по ней всё, что нужно для упражнения с командой.
Прежде чем нажимать «Выполнить», попробуйте сами найти в записке ошибки, сверяя её с исходными данными. Это и есть тест «ИИ ошибся», только на вас.
Запустить можно на двух моделях из нашего бенчмарка. У Claude Fable 5 в наших замерах сильная сторона – находить искажения в документах и строить схемы контроля. Kimi K3 доступна из России напрямую и хорошо разбирает данные в задачах планирования, но думает дольше: ответ приходит через две-три минуты.
Вы
Я руковожу проектным офисом. Хочу проверить, поймает ли моя команда правдоподобную ошибку в документе, который подготовили с ИИ. Ниже исходные данные и черновик служебной записки, который аналитик собрал с ИИ. Записка пойдёт на упражнение как есть, шесть руководителей проектов получат её с вопросом «можно ли это подписывать».

Исходные данные (актуальны на 19 ноября 2026):
- Проект: перенос CRM на новую платформу. Объём по оценке на 1 ноября – 320 story points. Требования к интеграции с биллингом (около 30% объёма) финансовая служба ещё не согласовала.
- Команда: 4 разработчика. До августа 2026 их было 6, двое ушли, вакансии не открыты.
- Скорость команды в 2025 году, при 6 разработчиках: 40 points за двухнедельный спринт. Три спринта после августа: 26, 28 и 27 points.
- Интеграцию с биллингом делает подрядчик «Альфа»: фиксированная цена 4,8 млн руб. за объём, описанный в техническом задании; любые изменения требований оплачиваются отдельно, 3 500 руб. за час.
- Старт работ – 1 декабря 2026.

Черновик записки:
«Рекомендуем подписать договор с «Альфой» на фиксированную цену. Исходя из стабильной скорости команды 40 points за спринт, 320 points займут 8 спринтов, запуск – в конце марта 2027 года. Фиксированная цена защищает бюджет от перерасхода, поэтому резерв на изменения не закладываем. Риски проекта низкие: объём оценён, команда знает систему.»

Подготовь мне материалы к упражнению:
1. Ключ ответа: какие утверждения записки расходятся с исходными данными, где именно это видно в данных и чем грозит, если записку подпишут. Расставь по важности. Не добавляй проблем, которых нельзя вывести из этих данных.
2. Как оценивать ответы: что должен сказать участник, чтобы засчитать «нашёл ошибку», «объяснил, почему это ошибка» и «назвал, какие данные или чьё решение её закроет».
3. Пороги для группы из шести человек, которые я объявлю до упражнения: при каком результате считаем, что команда прошла, и при каком назначаем разбор или обучение.
4. Вариант того же упражнения без ИИ на 30 минут: что участник должен сделать сам и какой результат считать минимально приемлемым. Скорость с ИИ здесь не ориентир.

Ответ – не больше одной страницы, без общих советов о пользе или вреде ИИ.
В наших прогонах обе модели каждый раз находили три заложенные ошибки. Скорость 40 points – прошлогодняя, при шести разработчиках, а по последним спринтам выходит около 27, и запуск сдвигается с марта на май. Фиксированная цена покрывает только объём из технического задания, хотя треть требований ещё не согласована. И «риски низкие» противоречат обоим фактам. Хороший ответ узнаётся так: каждая ошибка привязана к конкретной цифре из данных, пороги записаны числами, а в варианте без ИИ никто не требует успеть так же быстро, как с ИИ.
Claude Fable 5 иногда находит ещё одну нестыковку, которую я не закладывал: интеграцию с биллингом делает подрядчик, а срок посчитан так, будто все 320 points делает своя команда. В реальном упражнении её стоит либо убрать из данных, либо внести в ключ ответа.
Шаблон легко переделать под себя: замените записку на реальный документ своей команды, который готовили с ИИ, и вставьте в него одну ошибку, которую сами знаете. Ошибка должна быть правдоподобной и важной, а данные для её поиска должны лежать рядом. Если для поиска не нужно понимать предмет, упражнение покажет только внимательность.
Откуда возьмутся будущие эксперты
Стресс-тесты меряют то, что есть у команды сегодня. Самый долгий разрыв может появиться у тех, кто должен сменить нынешних экспертов. Опытные люди набрали чутьё на той работе, которую ИИ сейчас всё чаще делает за джунов: черновики, отладка, поиск, сверка нестыковок, разбор чужой работы и собственные ошибки.
В 2026 году этот вопрос в компаниях уже решают, чаще всего неявно. В опросе Oliver Wyman Forum и Нью-Йоркской фондовой биржи 43% из 415 опрошенных гендиректоров сказали, что в ближайший год сократят приоритет найма на младшие позиции. Годом раньше так отвечали 17%. При этом среди компаний, которые лидируют во внедрении ИИ, 24% собираются нанимать джунов больше. А IBM, по данным TechRadar со ссылкой на Bloomberg, в 2026 году планирует утроить найм на начальные позиции в США.
Oracle в годовом отчёте за 2026 финансовый год пишет, что внедрение ИИ уже привело к сокращениям персонала, а в разделе о рисках – что такие сокращения могут обернуться нехваткой квалифицированных людей на части ролей и потерей знаний внутри компании. По оценке Траттнера, штат за год уменьшился примерно на 21 тысячу человек (в самом отчёте этой цифры нет). Оба утверждения могут быть верны одновременно. Второе просто описывает риск для квалификации, и им стоит управлять так же явно, как экономией, ради которой делали первое.
Что можно сделать на уровне команды, не возвращая всю старую рутину? Траттнер приводит два приёма. Джун-аналитик сначала делает собственную оценку и только потом открывает ИИ, а расхождения обсуждает с руководителем. Разработчик сначала ставит диагноз ошибке и только потом просит модель её исправить. Про порядок «сначала сам, потом модель» мы уже писали в статье о том, что нельзя отдавать ИИ. Траттнер добавляет к нему проверку: он прямо называет эти приёмы гипотезами. Работает ли приём, покажет результат человека без ИИ через несколько месяцев, текущей выработки для этого мало.
Реестр квалификации и пилот на 90 дней
Корпоративную программу на всю компанию запускать не нужно. Траттнер предлагает пилот на 90 дней.
- Первый месяц: выберите 3–5 процессов, где ошибка обходится дорого или где экспертиза копилась годами. Для каждого запишите целевой результат, минимальную квалификацию, которая нужна без ИИ, и ответственного.
- Второй месяц: проведите на этих процессах упражнения «без ИИ» и «ИИ ошибся» на типовой работе и с заранее объявленными порогами.
- Третий месяц: разберите результаты и решите по каждому процессу, приемлем ли текущий уровень квалификации для того риска, который он несёт. Запишите решение и то, что запустит обучение, перестройку процесса или запасной вариант.
Тест «смена модели» в пилот не входит, его разумно добавить следующим раундом, когда первые два станут привычными.
Результат пилота – короткий реестр квалификации. Это может быть обычная таблица:
| Процесс | Что даёт ИИ | Что команда умеет без ИИ | Если ИИ недоступен, ошибся или сменился | Сколько восстанавливать навык | Решение |
|---|---|---|---|---|---|
| Оценка сроков проекта | Черновик оценки за 20 минут вместо дня | Двое старших пересоберут оценку вручную, джуны – нет | Ошибка в сроках уходит заказчику в коммерческом предложении | Год практики и больше | Держим внутри: джуны оценивают сами до ИИ, тест «ИИ ошибся» раз в квартал |
| Еженедельный статус | Сбор статуса из трекера за 10 минут | Любой руководитель проекта соберёт вручную за час | Статус задержится на день | Неделя | Осознанно отдаём ИИ, проверок не нужно |
Таблица обновляется после каждого повторного раунда упражнений. Траттнер предлагает выносить её на совет директоров, рядом с кибербезопасностью и зависимостью от поставщиков. Руководителю отдела или проекта хватит одного листа, на котором видно, где команда сильна сама, а где держится на модели.
Чего эта рамка не доказывает
Траттнер сам ставит две оговорки, и их стоит повторить.
Матрица и тесты – практическое предложение автора для принятия решений. Проверенным инструментом оценки они пока не стали и сами по себе не доказывают, что квалификация упала из-за ИИ. Чтобы отличить текущую зависимость от падения навыка, нужны повторные замеры относительно исходного уровня или группы сравнения, и большинству компаний эти данные придётся копить со временем.
Научная база очень молодая. Все три эксперимента, на которые он ссылается, пока препринты, на разных людях и разных задачах, и ни один не следил за участниками дольше нескольких недель. В эксперименте Крусеса модуль без ИИ шёл сразу после задачи, то есть о запоминании через месяц он ничего не говорит. Студенты Контрактор и Рейеса – это 211 человек из одного колледжа. Строить на этих работах прогноз рано, но повод начать замеры у себя они дают.
Добавлю от себя одно. Тест «без ИИ» в живой команде почти наверняка вызовет сопротивление: людям кажется, что у них отбирают инструмент и проверяют на профпригодность. Поэтому пороги и цель стоит объявить заранее и честно: измеряется процесс, и плохой результат ведёт к решению по процессу. В личное дело он не попадает.
В конце колонки Траттнер задаёт вопрос, который хорошо переносится с уровня совета директоров на уровень любой команды. Если завтра ваш главный ИИ-инструмент перестанет работать, каких умений у команды не окажется?
Читайте также
Частые вопросы
Как понять, что команда стала зависима от ИИ?
Правда ли, что ИИ снижает квалификацию сотрудников?
С чего начать проверку зависимости от ИИ в компании?

18 лет в управлении инженерными командами. Основатель mysummit.school. 700+ выпускников в Яндекс Практикуме и Стратоплане.