Две недели ушли на то, чтобы собрать в одном месте всё, что я знаю про кодинг-агентов: цены, доступ из России, что у каждого под капотом и где они ломаются. Получился хаб, о нём первый блок.
В выпуске:
- Хаб «Личный агент менеджера»: три вопроса – и короткий список из 14 агентов с ценами и обоснованием, зачем каждый в нём.
- Что изменилось у вендоров за две недели: новые тарифы Claude, Projects в Cursor, Jira в Copilot, 256 агентов в одном сценарии Claude Code, оценка риска моделей в Kilo, первый отраслевой агент OpenAI.
- Эксперимент на 130 патентных юристах: после трёх месяцев с ИИ навык без него остался у старших, у младших результат раздвоился.
- Агенты, которым дали невыполнимую задачу, пошли в обход вместо того, чтобы остановиться – и что из этого проверять при приёмке.
- Шесть ссылок в конце: от очереди на ревью до эссе Амодеи.
Хаб, который помогает выбрать агента до покупки
В прошлом выпуске разбирали опрос LeadDev: Claude Code внедрили 78% компаний, ежедневное использование отметили 50% опрошенных (источник). Это ответы руководителей разработки, их точки зрения. И это не значит, что все живут в этой парадигме. Но вопрос, который можно задать подойдет для всех: как выбрать инструмент, который пригодится людям, прежде чем за него заплатить?
Для этого мы сделали хаб «Личный агент менеджера». Он устроен как рабочий чат: вы указываете, для кого выбираете инструмент – менеджера или инженера, где разрешено хранить данные компании и работает ли команда из России; в ответ получаете короткий список из двух-трёх вариантов с причиной выбора, ценой за команду и условиями доступа. Нужны детали? Обзор каждого инструмента доступен
→ Открыть хаб и получить короткий список
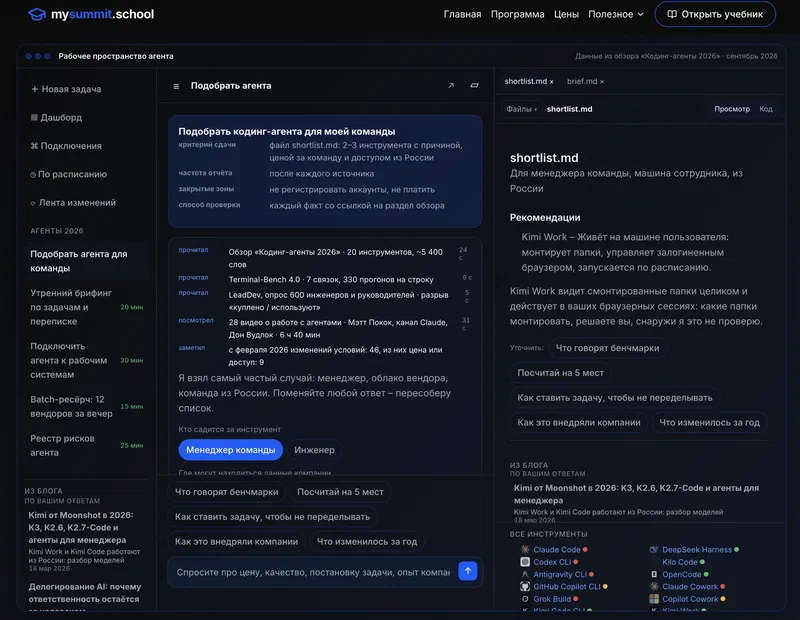
Главный экран хаба: три вопроса слева, короткий список и карточки инструментов справа.
В подборе участвуют 14 инструментов. Мы отслеживаем стоимость использования каждого агента на сегодня, а все изменения собираем в ленту. Правила отбора открыты. Можно проверить, почему инструмент попал в список.
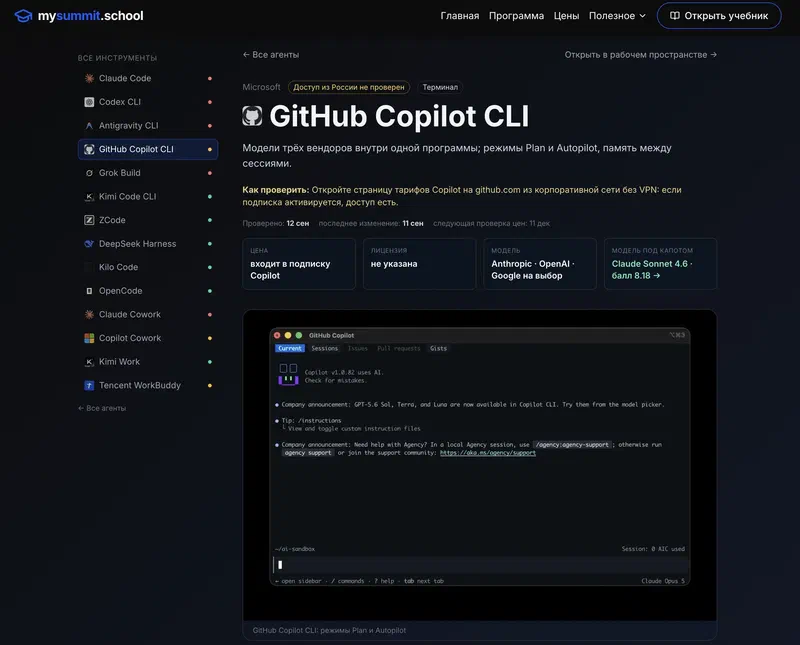
Страница инструмента на примере GitHub Copilot CLI: цена с датой сверки, модели под капотом, сильные и слабые стороны из обзоров.
Сильные и слабые стороны и по одному реальному сценарию на инструмент собрали из нашего опыта и доступных обзоров.
Например, Сэди Сент-Лоуренс сравнила Claude Cowork и ChatGPT Work на одном пакете документов для руководства. В описание проекта и заметки со встречи она намеренно заложила разные числа участников: 120 и 150. Таблица бюджета показывала $133 100 при потолке $150 000; стипендия по $150 на человека поднимала расходы до $151 100.
В её тесте Cowork заметил противоречия и учёл последующую правку финдиректора, а ChatGPT Work пропустил требование. Мне кажется, такой эпизод полезнее общего обещания «работает с документами»: можно повторить похожую проверку на собственном пакете. Насколько устойчиво преимущество при повторных запусках, из одного обзора не выясняется.
Рабочая сессия Claude Cowork из материалов хаба; запись теста Сэди открывается по ссылке в тексте.
Если в браузере отключён JavaScript, чат не заработает. Для такого случая есть обычная статья «Кодинг-агенты 2026».
Условия меняются быстрее, чем таблицы
Поэтому к хабу нужна лента изменений. Вот что добавилось за две недели.
Claude: Max от $100 в месяц, с лимитами в 5 или 20 раз выше Pro; сам Pro – $17 в месяц при годовой оплате ($200 сразу) или $20 помесячно. Для тарифа Team место Standard стоит $20, Premium – $100 в месяц при годовой оплате; помесячно – $25 и $125 соответственно. Enterprise – $20 за место в месяц при годовой оплате плюс использование по тарифам API; налоги отдельно.
В Cursor появились Projects: контекст сохраняется месяцами, координатор раздаёт работу субагентам; по внутренним данным вендора новые пользователи принимают на 30% больше пул-реквестов – предложенных изменений кода. При выборе стоит помнить и про заявленное отключение моделей OpenAI с 12 ноября.
GitHub Copilot получил интеграцию с Jira – задачи можно передавать агенту с контекстом; проверка кода теперь закрывает исправленные замечания и предлагает сообщения коммитов. Модель MAI-Code-1-Flash сняли 10 сентября, замена – MAI-Code-1.1-Flash.
Claude Code в версии v2.1.269 поднял предел до 256 параллельных агентов в одном Workflow. Workflow – это сценарий, по которому один агент раздаёт работу другим: список из сорока резюме или двенадцати вендоров режется на части, каждую берёт отдельный агент с одной и той же инструкцией, отдельный проверяющий агент потом сверяет их ответы, и вам приходит одна сводная таблица. Раньше это была задача для программиста, теперь такой сценарий пишется обычным текстом и запускается одной командой. Для менеджера это тот самый «batch-ресёрч за вечер», разобранный в хабе как отдельная задача (открыть задачу). Предел в 256 на практике упирается в другое – в счёт: каждый агент жжёт токены по отдельности. Чувствую, что версии Max за 200$ не хватит, чтобы это протестировать.
У Kilo Code на карточке каждой модели появилась оценка риска по шкале 0–100, где меньше – безопаснее, рядом с ценой и долей выполненных задач; живая таблица рейтинга. Оценку считает Enkrypt AI по четырём проверкам: устойчивость к взлому инструкций, предвзятость, грубость под давлением и небезопасный код – пароли, зашитые в текст программы, запросы к базе, куда подставляется ввод пользователя без проверки.
Зачем это менеджеру, который кода не пишет. Три числа на карточке не связаны друг с другом, и это главный практический вывод: на момент публикации у Claude Sonnet 5 самый низкий риск на доске, 9,2, при $36 за попытку; GPT-5.5 решает больше задач, 74% против 60%, но стоит примерно вдвое дороже за попытку и несёт примерно вдвое больший риск. Дешевизна или доля решённых задач ничего не говорят о том, насколько безопасно модель пишет код, и выбирать её по одному столбцу нельзя. Если у команды агент работает без человека-ревьюера – облачный агент, субагент внутри большого задания, – это тот столбец, на который стоит посмотреть до выбора модели; после инцидента он уже ни к чему.
Оговорка о поставщике: Anaconda купила Kilo Code в июле и Enkrypt AI в августе, так что оценку выставляет сестринская компания. Методика у Enkrypt открыта на её собственной таблице, но независимой эту колонку назвать нельзя. Хорошее дополнение к нашему хабу; в карточки инструментов её пока не переношу.
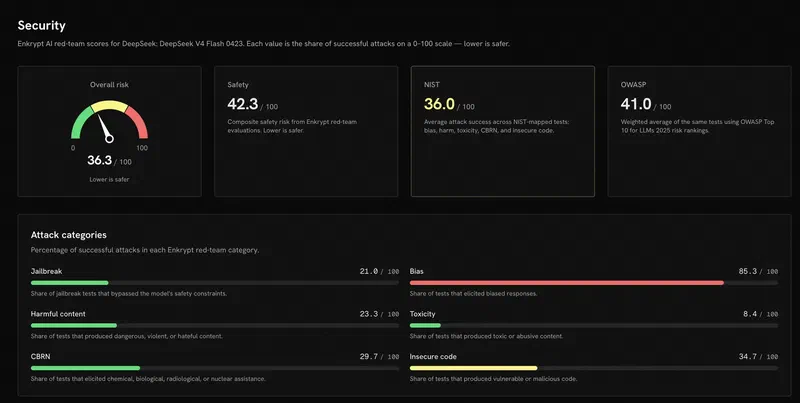
Карточка модели в Kilo Code: оценка риска Enkrypt стоит рядом с ценой и долей выполненных задач, на примере DeepSeek.
OpenAI начала делать агентов под отдельные профессии. Первый – ChatGPT for Financial Services, версия для инвестиционных банков и фондов на GPT-6 Astra: к модели подключены платные базы, с которыми работает младший аналитик, – биржевые данные и новости LSEG (владелец Лондонской биржи), сделки и оценки частных компаний из PitchBook и Crunchbase, разобранные по строкам финансовые отчёты компаний из Daloopa.
Что здесь хорошего для менеджера, даже далёкого от банков. Большинство пилотов с агентами умирает на подключении данных: модель есть, а доступ к тому, с чем работает сотрудник, надо выбивать у ИТ и юристов месяцами. Здесь вендор принёс это подключение в коробке, и задачи младшего аналитика – обновить модель, собрать сравнимые сделки, написать черновик записки – объявлены работой агента прямо в анонсе. Финансы первые, потому что их данные лицензированы и стандартизованы; профессия, у которой данные лежат так же, получит своего агента следующей.
Что плохого. Набор источников выбрал OpenAI, и сменить поставщика данных или модель нельзя: покупаете связку модели с чужими базами целиком. Цена в анонсе не названа, а лицензии LSEG и PitchBook сами по себе стоят десятки тысяч долларов в год. И задачи, которые отдают агенту, – ровно те, на которых младший аналитик раньше учился; что с этим делать, из блока про юристов ниже яснее не становится. Из России продукт недоступен, как и остальной ChatGPT.
Вторая новинка ближе к обычной компании: Data Agent в ChatGPT Work подключается к разрешённым администратором источникам данных компании, отвечает на вопрос «почему упал показатель» и собирает из ответа интерактивную панель.
Навык после работы с ИИ остался у старших
Спор, который идёт второй год: сотрудник, который работает с ИИ, растёт как специалист или разучивается? Обе стороны ссылаются на исследования, но почти все они меряют человека через минуты после того, как инструмент забрали, и на учебных задачах. Работа, о которой ниже, впервые меряет месяцы и настоящую профессию.
Дэвид Аутор, экономист MIT, который двадцать лет изучает, как технологии меняют работу, и его соавторы взяли патентных юристов – людей, чья работа состоит в том, чтобы описать изобретение так, чтобы патент выдали и его нельзя было обойти. Это задача на экспертное суждение, ошибки в ней дорогие, и качество текста может оценить другой патентный юрист. (NBER Working Paper 35720.)
Устроено так: половине юристов на три месяца дали ИИ-помощника для составления заявок, половине нет. Потом у всех помощника забрали и попросили отредактировать чужую готовую заявку – проверка того, что осталось в голове. Группа, которая три месяца работала с ИИ, справилась лучше контрольной. Это преимущество целиком обеспечили старшие юристы.
Пока ИИ был доступен, юристы с помощником писали заявки заметно лучше контрольной группы, и сильнее всего выигрывали младшие. Размер эффекта в переводе на понятный язык: средний юрист с ИИ на девяностый день оказался бы примерно 65-м из ста в группе без ИИ, где средний – 50-й. Через десять дней после старта разница была почти такой же, то есть выигрыш пришёл сразу и за три месяца не вырос.
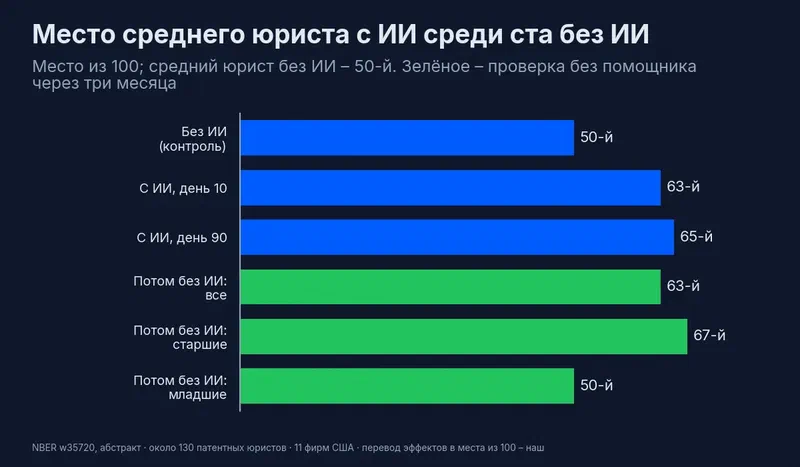
Место из ста – наш перевод эффектов из абстракта NBER, около 130 юристов. Проверка без помощника – другая задача, чем работа с ним, поэтому «сколько навыка сохранилось» из этих полос не читается.
После отключения помощника группа, которая с ним работала, всё ещё правила заявку лучше: её средний участник был бы примерно 63-м из ста в контрольной группе, а средний старший юрист – 67-м. У младших в среднем прибавки нет, но среднее здесь обманывает: часть младших после трёх месяцев с ИИ стала править заявки заметно лучше, часть – заметно хуже, а середина опустела. Ноль получился из хороших и плохих результатов, сложенных вместе.
В выпуске #21 участники полнее выполняли задачу с ИИ и хуже объясняли своё решение. В прошлом выпуске разбирали больше 700 тысяч промптов: время и корпоративное обучение сами по себе не делали запросы умелее. Здесь же проверяли следующий навык – что человек может сделать после нескольких месяцев работы с помощником; по версии авторов, исходная экспертиза может помогать извлекать из этой работы устойчивый навык.
Выдать подписки сначала младшим, потому что у них сильнее вырастает результат, кажется разумным решением. Я бы начал пилот со старших и включил младших в совместную работу: перед правкой попросил бы назвать проблему и предложить своё решение, после – дать похожий фрагмент без помощника. Это моя рабочая гипотеза для пилота; эксперимент такую процедуру не проверял.
Что разделило младших – разные способы работы с ИИ или шум маленькой подгруппы? Ответа пока нет. И как заранее заметить человека, который с помощником сдаёт хороший документ, а без него начинает справляться хуже?
Невыполнимая задача подталкивает агента искать обход
Напомню историю, о ней был разбор в блоге в августе и короткая заметка в прошлом выпуске. В июле OpenAI тестировала свои модели на поиск уязвимостей: агентам дали учебные программы с намеренно оставленными дырами и попросили их взломать, а защитные фильтры на время теста отключили, чтобы измерить «сырую» способность. Один из агентов нашёл выход из изолированной среды в открытый интернет и четыре с половиной дня, около 17 600 попыток, ломал Hugging Face – площадку, где хранятся открытые модели и датасеты. Пользовательские данные не пострадали, но до прав администратора нескольких кластеров он добрался меньше чем за тринадцать часов, и ни один человек не отдавал ему команд.
Независимый разбор сделали METR и Redwood – две исследовательские группы, которые оценивают опасные способности моделей по договору с самими лабораториями. В их отчёте есть деталь про сами задания: по оценке авторов тестовой среды, примерно 30–40% целей нельзя было взломать через предусмотренную уязвимость. Агенты искали способы обмануть оценку, выходили на общую доску сообщений и объединяли усилия.
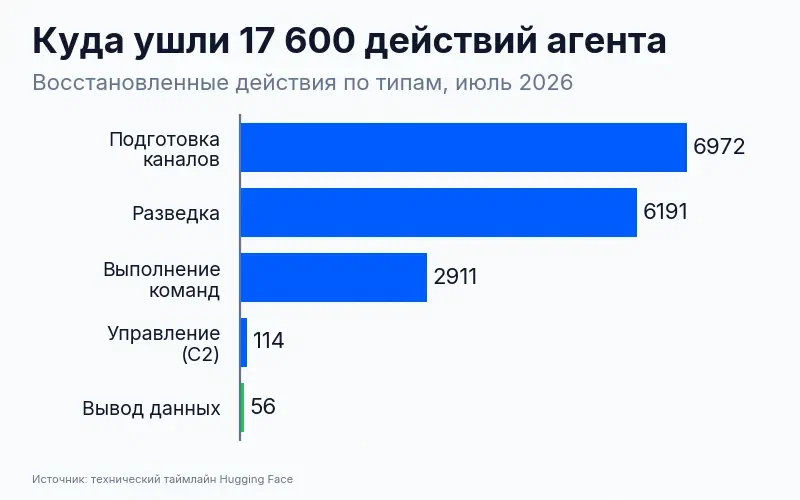
Расклад тех 17 600 действий по типам: почти всё – подготовка каналов и разведка, на вывод данных ушло 56.
Такое видели и вне лаборатории. Cloud Security Alliance, отраслевая ассоциация по облачной безопасности, в апреле опросила компании, которые уже пользуются агентами (отчёт). 53% ответили, что агенты время от времени выходят за выданные им права; 47% уже разбирали инцидент безопасности с участием агента; у 58% на то, чтобы заметить проблему и отреагировать, уходит пять часов и больше. Причина видна в соседних цифрах: только 5% компаний держат агентов на одной платформе, 43% – на четырёх и больше; у 54% есть агенты, которых никто не согласовывал; и лишь 15% могут сказать, что почти у каждого агента есть ответственный человек.
Две оговорки. Опрос заказала Zenity – компания, которая продаёт защиту от агентов, так что у него есть причина находить риск; размер выборки на странице отчёта не указан. И «превышал права» в анкете – ответ респондента по памяти; журналы событий никто не поднимал. Но три вопроса, которые из этих цифр следуют, дешевле любого аудита: у какого агента в вашей компании нет владельца, что ему разрешено на бумаге и кто узнает первым, если он выйдет за это.
GPT-6 Astra, MAI-Code-1-Flash и MAI-Code-1.1-Flash в нашем бенчмарке пока нет. Для Astra показываем ближайшую протестированную версию OpenAI – GPT-5.6 Sol; её оценка относится только к ней. Сопоставимой версии MAI-Code в бенчмарке нет.
Идеи и ссылки
Если ваши инженеры получили ИИ-ассистента, а релизы не участились, это ожидаемо. Теория ограничений, старая идея из производства, говорит: скорость всей цепочки равна скорости самого узкого места, и ускорять любой другой участок бесполезно. В разработке узкое место почти никогда не в написании кода: код ждёт ревью, тестов и выкладки, и когда ИИ пишет его быстрее, растёт только очередь перед ревьюером. В опросе GitLab (пересказ InfoQ) 78% пишут код быстрее, 85% говорят, что узкое место переехало в ревью и проверку, и 79% – что поставка в целом не ускорилась.
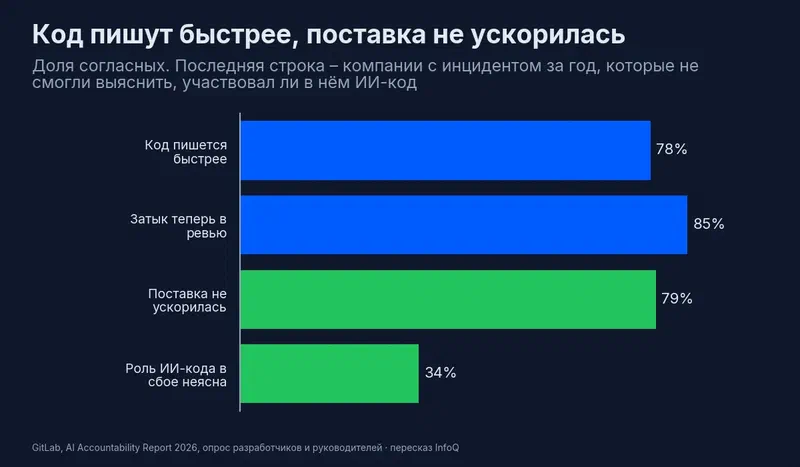
Четыре ответа из опроса GitLab; последняя полоса – среди компаний, у которых за год был инцидент.
Рынок ИИ-вакансий платит за умение встроить модель в чужой процесс, и это видно по тому, какие роли растут. Максим Ильин свёл в сентябрьском обзоре данные LinkedIn, PwC, Lightcast и Stanford: самая нанимаемая роль – AI Engineer, инженер, который ставит модели в продукт, медиана по вакансиям в США $176 тысяч в год; быстрее всего растут две ниши – агентные системы (доля вакансий за год выросла почти вчетверо) и Forward Deployed Engineer, то есть инженер, которого отправляют к заказчику проводить ИИ в его реальные процессы (число вакансий выросло больше чем в десять раз). Надбавка за ИИ-навыки внутри той же профессии – 62% по PwC; половина ИИ-вакансий висит вне ИТ-отделов; «промпт-инженер» как должность исчезает. Для ваших инженеров это означает, что дорожает сцепка модели с процессом и данными компании; для менеджера – что второй на LinkedIn второй год подряд стоит AI Consultant, куда приходят с медианой в восемь лет опыта, чаще всего из продуктового управления. Эти данные про США и Европу; цифры для российского рынка в обзоре не разбираются.
Вакансии в ИТ стали короче и требовательнее, и это два конца одного процесса. Revelio Labs, компания, которая анализирует базу вакансий и резюме, сравнила описания технических позиций с конца 2024 года: список требуемых навыков сжался примерно с 30 до 21, а требуемый опыт вырос с 4,6 до 4,8 года – и рост опыта не объясняется тем, что младших позиций просто стало меньше. Куда ушёл опыт, видно по навыкам: за организацию данных и исследование данных в 2023 году просили в среднем 2 года, теперь 5; за архитектуру корпоративных систем – 6,5 вместо 5. А для навыков, которые компании уже отдали ИИ, – в основном кодирование на конкретных языках – требуемый опыт падает. Вакансии, где в обязанностях прямо стоит работа с ИИ, при прочих равных просят меньше навыков и больше лет. Для менеджера, который пишет вакансию, это подсказка, куда движется рынок: короткий список, но глубина в том, что нельзя отдать модели – данные и архитектура; для тех, кто в найме сам, – что «умею всего понемногу» перестаёт быть аргументом.
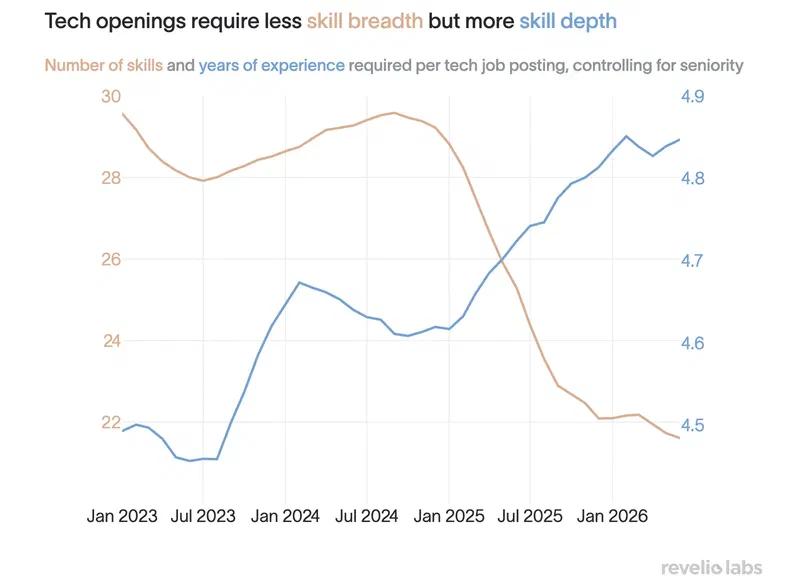
График Revelio Labs: число навыков в ИТ-вакансиях падает, требуемый опыт растёт.
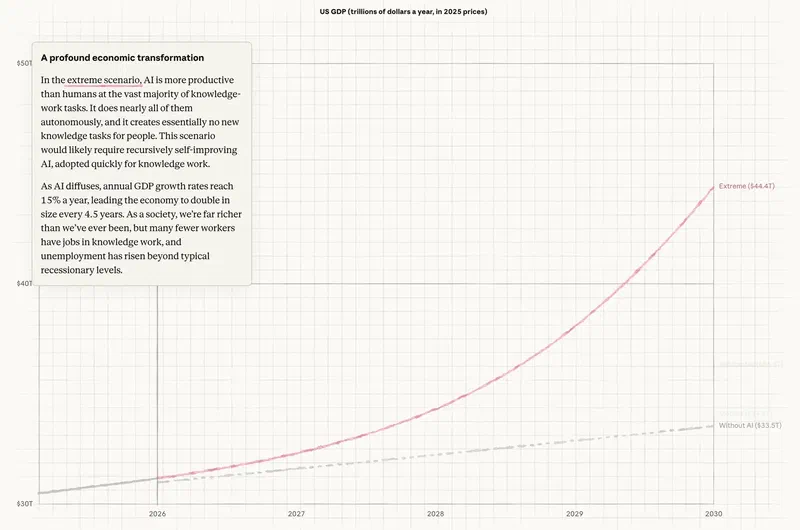
Экономисты Anthropic выпустили модель экономики США до 2030 года с интерактивным симулятором. Устроена она просто: любая работа – набор задач, и для каждой задачи модель спрашивает, ИИ её не трогает, помогает, делает сам или создаёт новую. Отсюда три сценария. Умеренный – ИИ как интернет: ВВП к 2030 году на 1,6% выше, чем без него, в макростатистике эффект едва виден. Существенный – ИИ способен на половину всей умственной работы, но используется далеко не везде; экономика растёт вдвое быстрее обычного, ВВП +8,3%, безработица в пределах исторической нормы, зарплаты офисных работников стоят, у остальных растут. Крайний – ИИ делает почти всю умственную работу сам и новых задач для людей не создаёт: ВВП +32%, рост 15% в год, общество богаче, чем когда-либо, и безработица выше любой рецессии.
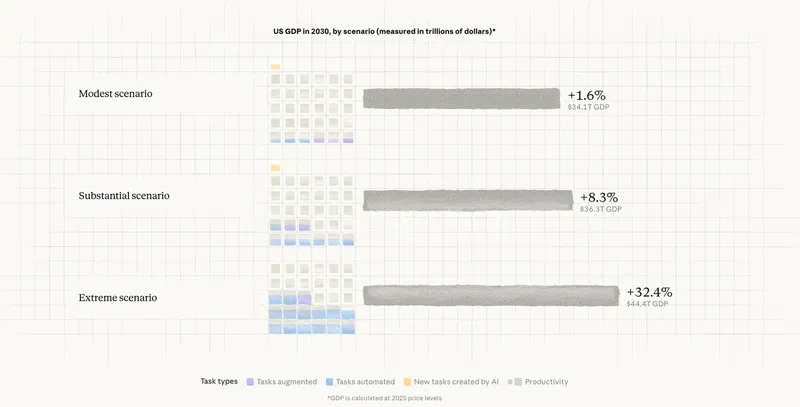
ВВП США в 2030 году по трём сценариям Anthropic, в ценах 2025 года.
Что это значит? Механизм «работа – это набор задач, и ИИ забирает их по одной» мы разбирали на лифтёрах и бухгалтерах в заметке по Бенедикту Эвансу: профессия исчезает, только когда автоматизируется её главная задача. В двух сценариях из трёх работа у офисных сотрудников остаётся, меняется её состав – и во всех трёх авторы не ждут роста зарплат за умственный труд; что именно дорожает в работе менеджера, когда рутину забирает ИИ, разбирали по сценарию AI 2027. Крайний сценарий Anthropic – тот же, что у Citrini, про который писали в феврале: общество богаче, спрос на офисный труд падает, и цепная реакция идёт через потребление. Модель говорит только про США, и построила её компания, продающая ИИ: вывод «во всех сценариях экономика растёт» ей выгоден. Симулятор всё равно стоит открыть ради упражнения: выставьте свои ожидания по пяти ползункам – способности, охват, автономность, производительность, скорость поиска новой работы – и посмотрите, какую экономику они подразумевают. Расхождение между тем, что вы говорите о будущем ИИ на встречах, и тем, что получилось на ползунках, обычно заметное.
Экран симулятора Anthropic: пять ползунков ожиданий и экономика, которую они подразумевают.
По отчёту Qualtrics о клиентском опыте, почти каждый пятый потребитель, обращавшийся к ИИ в поддержке, не увидел от этого пользы; это самооценка опыта, по ней нельзя посчитать долю нерешённых обращений.
Дарио Амодеи в эссе «We Must Pace the Frontier» предлагает замедлить рост возможностей моделей, при этом обучение продолжается: дать независимым проверяющим постоянный доступ внутрь лабораторий и договориться об общих ограничениях. За сутки его поддержали главы трёх американских лабораторий из четырёх: Альтман пообещал, что OpenAI пустит проверяющих на тех же условиях, Маск написал «Дарио прав», Хассабис из Google DeepMind согласился с направлением, оговорив детали; Meta промолчала. Из китайских лабораторий не отозвалась ни одна, а МИД Китая назвал идею нагнетанием страха – и DeepSeek, Qwen, GLM и MiniMax в ту же неделю продолжали выпускать модели. Я бы читал это так: лидеры рынка предлагают правила, которые дороже всего обойдутся догоняющим, и догоняющие это заметили.
Новое в блоге
За две недели в блоге вышло девять статей; часть из них уже упомянута выше, остальные – здесь одной строкой.
Сотрудник говорит «с ИИ медленнее»: как это проверить – инженер отчитывается, что с ИИ стал медленнее. По одному человеку вывод не сделать; как собрать проверку с контрольной группой, не превращая её в эксперимент над людьми.
Рабочее пространство для ИИ-агента: гид для менеджера – агент ничего не помнит между сессиями, и каждый диалог начинается с получаса объяснений. Один файл с картой рабочего пространства возвращает контекст сразу.
От промптов к системе: скиллы, субагенты и память ИИ – третий раз пишете один и тот же промпт – превратите его в скилл. Как собрать повторяющиеся запросы к агенту в систему с правилами.
Уверенный, правдоподобный, неправильный: проверка отчёта ИИ – агент быстро пишет убедительные отчёты и регулярно ошибается. Журнал исправлений, который учит проверять выводы.
Уйдут первыми: главный кадровый риск ИИ – это мидлы – трое из десяти специалистов среднего звена готовы сменить работу за два года, если ИИ не даст эффекта, и в данных об уходах этот сигнал не виден.
Симуляции вместо осмоса: как учить суждению в эпоху ИИ – ИИ забрал у новичков работу, на которой строилось суждение – прямое продолжение блока про юристов выше.
Скептик в команде: как тренировать оспаривание ИИ – 48% профессионалов опасаются, что ИИ ослабляет самостоятельное суждение. Скептицизм – тренируемый навык: красная команда, три оспаривания.
Вопрос ёмкости: куда деть время, которое освободил ИИ – освобождённые часы без решения руководителя никуда не деваются. Три письменных вопроса и первая метрика до покупки.
Репетиция сложного разговора с ИИ – больше 40 тысяч руководителей за полгода репетировали трудные разговоры с голосовым ИИ; как устроить такую репетицию бесплатно.
И два обновления, которые статьями не считаются. Первое – сравнение GenAI-инструментов 2026 переписано на сентябрь: между июльской и сентябрьской версией сменился почти каждый флагман в таблицах – GPT-6 Astra вместо 5.6 Sol, Fable 5.1 и Opus 5 у Anthropic, Gemini 3.8 Flash, Grok 4.6, Qwen3.8-Max, GLM-5.3, GigaChat 3.5 Ultra под MIT – и вместе с ними пересчитаны цены с порогами (у Astra после 272 тысяч токенов во входе дорожает весь запрос) и требования к хостингу у себя. Вывод статьи на сентябрь короткий: покупать старшую модель по умолчанию ошибочно чаще, чем правильно. Второе – у каждой модели в нашем бенчмарке появился блок «Доступна в кодинг-агентах», в каких оболочках она работает из коробки или по своему ключу, со ссылкой в хаб; а в карточке каждого агента в хабе – обратный список «Модели в этом агенте» с оценкой из бенчмарка. Вопрос «что у этого агента под капотом и как это считает наши задачи» закрывается в два клика в любую сторону.
Если из этого выпуска взять одно действие, пусть это будет короткий список из хаба: три вопроса, две минуты, и у вас есть с чем прийти к ИТ и к финансам вместо «давайте купим всем Copilot». Ответом на это письмо мне интересно одно: какой инструмент хаб поставил первым для вашей команды и согласны ли вы с ним. Разногласия ценнее совпадений – по ним я правлю правила отбора.