За две недели вышло крупнейшее на сегодня исследование найма после внедрения ИИ. За это же время подешевели обе флагманские линейки моделей, а несколько расследований показали, что агенты делают без присмотра.
В выпуске:
- Кого берут на работу после внедрения ИИ: крупнейшее исследование найма и данные о том, какие задачи менеджеры готовы отдать агентам.
- Почему весенний бюджет на ИИ устарел: Claude и GPT подешевели, цена за токен стала плохим ориентиром, а мой месяц разработки приложения на дешёвой модели стоил $190.
- Что агенты делают без присмотра: сто тысяч реальных сессий, тихая выгрузка истории гита и журнал из 48 сбоев, где автоматика поймала шесть.
- Шесть ссылок в конце: повторный эксперимент о скорости работы с ИИ, агент, который подбирает цену под ваш кошелёк, и другие истории.
Кого компании берут на работу, когда внедряют ИИ
Заголовок «ИИ убивает Junior» за два года набил оскомину, а спорили о нём в основном на ощущениях. В сентябре лаборатория цифровой экономики Стэнфорда опубликовала рабочую статью «How Does AI Change Labor Demand? Evidence from 41 Countries» на основе 1,25 млрд вакансий и 154 млн записей о занятости. Авторы считали, что компания внедрила ИИ, если в её вакансиях прямо требовали умения работать с генеративным ИИ. Затем они сравнивали зарубежные филиалы этих компаний с похожими филиалами, где ИИ не внедряли.
Сами такие вакансии пока редкость: в среднем по 41 стране их 108 на каждые 100 000. Чаще всего генеративный ИИ требуют в Индии и Израиле, реже всего – в Бразилии и Японии. По отраслям впереди IT и медиа: там таких вакансий втрое больше, чем в образовании и медицине, которые идут вторыми.
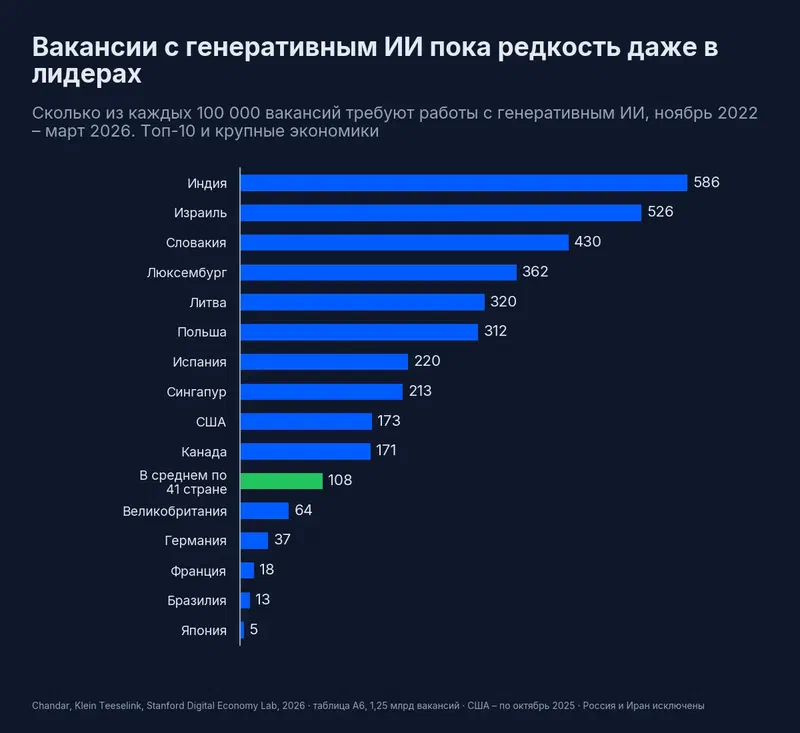
Даже у лидера, Индии, генеративный ИИ требуют меньше чем в одной вакансии из ста.
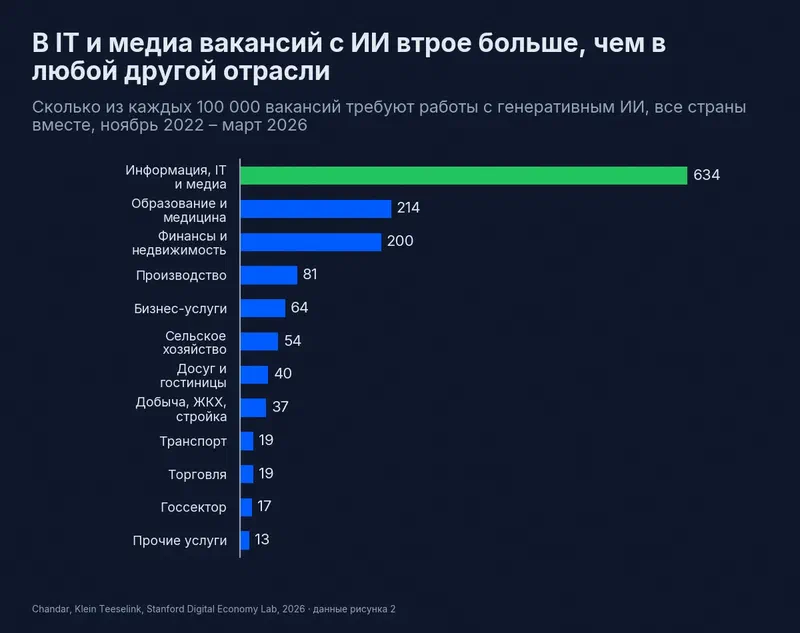
IT и медиа далеко впереди, в торговле, транспорте и госсекторе таких вакансий почти нет.
Доля Junior в филиалах с ИИ начала снижаться сразу после выхода ChatGPT. К марту 2026 года на каждые 10 000 сотрудников там приходилось примерно на 190 Junior меньше, чем в похожих филиалах без ИИ. При этом Senior стало почти на 7% больше, а Junior – на 2,5% меньше; снижение числа Junior авторы не могут отличить от случайного колебания. Общее число сотрудников выросло примерно на 3%, но и в этом результате у авторов нет строгой уверенности. В исследовании Junior – два нижних уровня должностей, Senior – все уровни выше. Значит, Middle здесь посчитаны вместе с Senior.
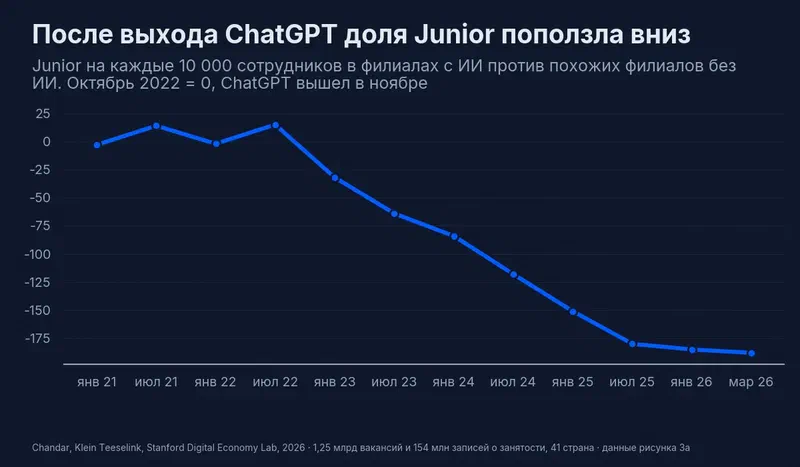
До выхода ChatGPT линия держится около нуля, затем три года подряд постепенно снижается.
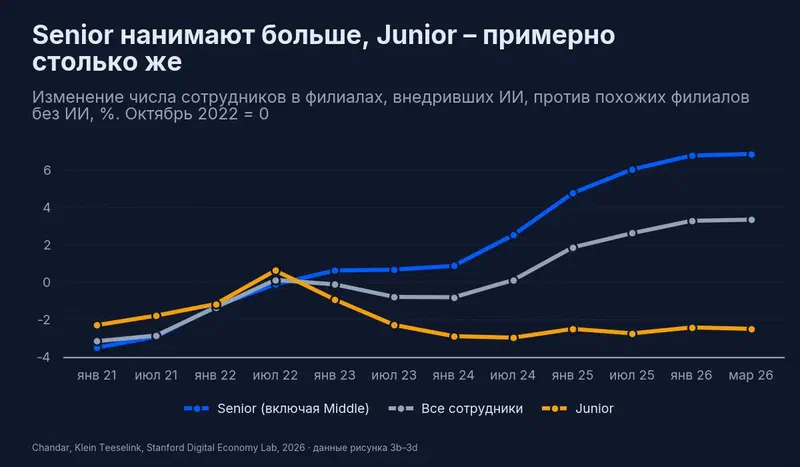
Число Senior заметно растёт, число Junior меняется мало: поэтому доля Junior снижается.
Из 31 страны, по которым хватило данных для отдельной оценки, доля Junior снизилась в 23. В семи странах, в том числе в США, Бразилии и Саудовской Аравии, авторы уверены, что снижение не случайно. Сильнее всего доля Junior упала в Великобритании, а единственная страна, где она надёжно выросла, – Швейцария. Сильнее всего доля Junior упала в IT и математических профессиях – на 3,3 процентного пункта, хотя доля самих этих профессий в штате слегка растёт. Senior чаще оказываются в профессиях, сильнее всего подверженных влиянию ИИ; у Junior оценки указывают в обратную сторону. Выбирают ли Junior другие профессии сами или их вытесняют, по этим данным не понять.
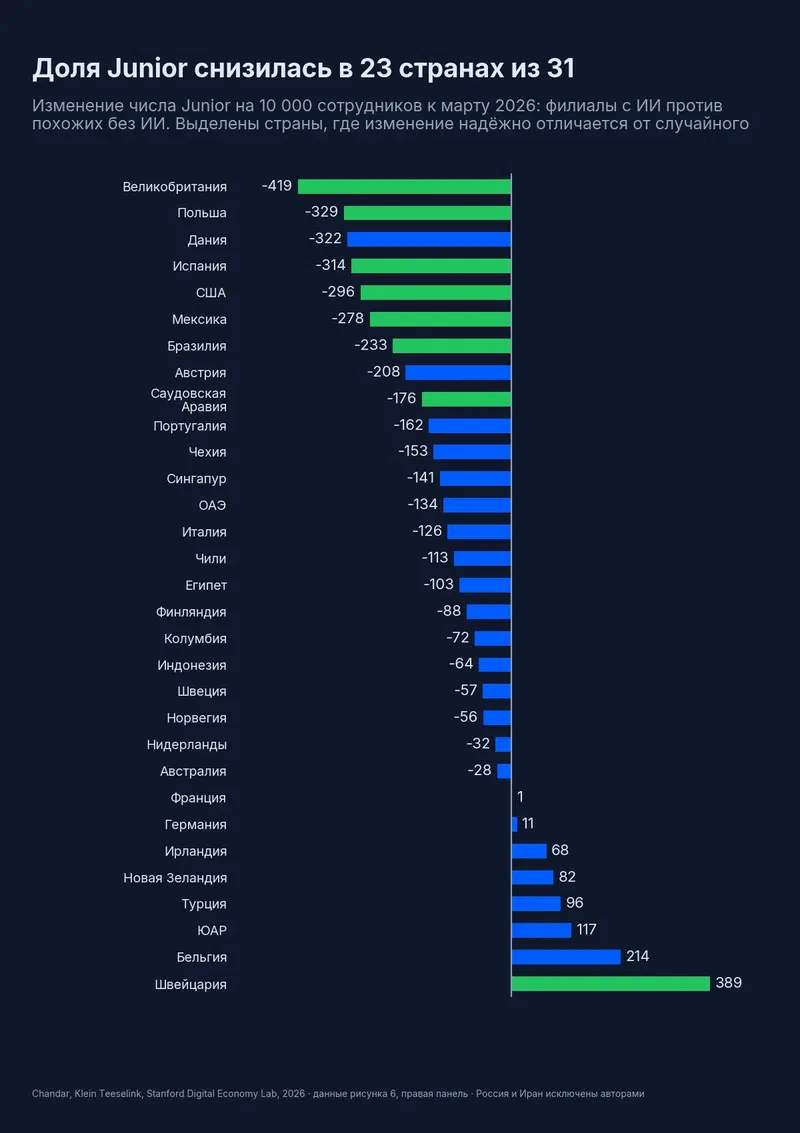
Зелёным отмечены страны, где изменение надёжно отличается от случайного: семь со снижением и Швейцария с ростом.
Менеджеру теперь приходится думать, кто вырастет в Senior: их нанимают больше, а число Junior почти не меняется. Возможно, рутинные задачи, на которых Junior раньше учились, теперь уходят агентам. Это моя догадка, исследование её не проверяло. Тогда учить будущих Senior придётся отдельно, и отвечать за это менеджеру. В прошлом выпуске мы разбирали эксперимент на 130 патентных юристах: после трёх месяцев с ИИ Senior сохранили навык работать без него, а у Junior результаты разошлись. То исследование измеряло навык, нынешнее – найм. Данных по России здесь нет: авторы исключили её и Иран, поскольку там заблокирован LinkedIn, на котором построена выборка. Применимы ли результаты к российским компаниям, из этой работы не узнать, а сопоставимых российских данных я не знаю.
Исследователи Microsoft три месяца выясняли, какие задачи продакт-менеджеры готовы отдать ИИ. Они опросили почти 900 человек, провели пятнадцать интервью и изучили телеметрию Copilot ещё для семисот с лишним пользователей (разбор в Research-Driven Engineering Leadership). Продакт-менеджеры постоянно поручают задачи инженерам и дизайнерам, но за результат отвечают сами. Теперь часть задач они поручают языковой модели.
Три четверти специалистов без подчинённых (individual contributors) пользуются генеративным ИИ ежедневно или почти ежедневно. Но рассказы людей о том, как часто они его используют, с логами совпадают слабо: самые активные по собственным словам часто оказываются далеко не первыми по телеметрии. 81% говорят, что ИИ экономит им время, а 56% в том же опросе – что работать меньше они не стали. Похоже, освободившиеся часы уходят на ту же работу. Какие задачи человек отдаёт модели, зависит от того, что он считает своей работой и за что отвечает лично: форматирование и заметки со встреч поручают ей охотно, а ответственность за результат оставляют себе. Среди менеджеров 51% назвали главным препятствием необходимость встроить ИИ в привычные процессы; обучение и неясную политику компании отметили по 24%.
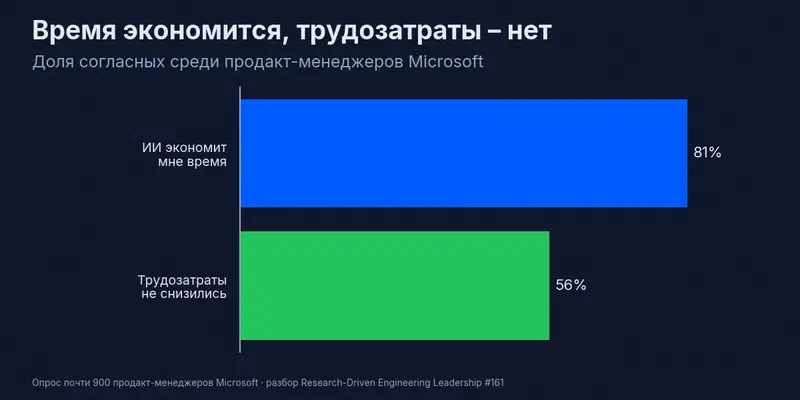
Одни и те же люди говорят, что ИИ экономит время, но объём работы у них не снижается.
Другую сторону делегирования изучили Microsoft, Oregon State и UC Davis: полторы тысячи человек оценивали 75 качеств хорошего коллеги применительно к человеку и к ИИ (разбор там же). Технические навыки поставили на 2-е место из 75 для ИИ-коллеги и на 20-е для человека. Умение честно сказать «не уверен» заняло 4-е место для ИИ и 42-е для человека. Ответственность, напротив, оказалась на 3-м месте для человека и на 53-м для ИИ; в пояснениях 59% участников написали, что отвечать должен человек. Почти две трети считают, что результат ИИ нужно прочитать и проверить, прежде чем передать дальше, а каждый пятый ждёт, что передающий сможет объяснить и защитить результат. Мы разбирали эту ответственность в статье «Делегирование AI: почему ответственность остаётся за человеком»: за переданный результат отвечает человек.
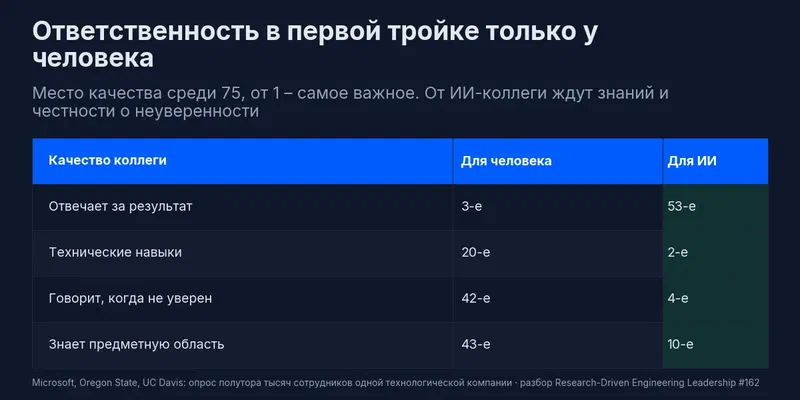
От ИИ-коллеги ждут знаний и умения признать неуверенность. За результат, по мнению участников, должен отвечать человек.
При этом агентов уже вписывают в организационные схемы. Boston Consulting Group (BCG) в январе опросила больше тысячи двухсот менеджеров: 22% сообщили, что в их организациях ИИ-агенты внесены в оргструктуру (Wired). Агентам дают имена, роли и аватаров, чтобы они лучше «вписывались в коллектив». Такое представление влияет на проверку: в эксперименте BCG менеджеры, которым сказали, что работу сделал «ИИ-сотрудник», нашли на 18% меньше ошибок, чем те, кому ту же работу показали как результат «ИИ-инструмента». Если назвать агента сотрудником, его работу проверяют менее внимательно.
Мне кажется, ближайшие годы особенно трудными могут оказаться для Middle. Junior продолжают брать, Senior берут активнее, а часть задач Middle готовы передавать агентам. По опросу Thomson Reuters Institute, почти трое из десяти Middle-специалистов в профессиональных услугах готовы сменить работу за два года, если им не дадут нужных инструментов ИИ и обучения. Пока сотрудники лишь думают об уходе, отчёты о текучести этого не покажут.
→ Прочитать, почему главный кадровый риск ИИ – это Middle-специалисты
Весенний бюджет на ИИ уже устарел
За две недели подешевели обе флагманские линейки. Anthropic выпустила Claude Opus 5.5: миллион входных токенов стоит $4, выходных – $20, чтение из кэша (cache read – повторное чтение текста, который модель уже видела в этом диалоге) – $0,20. По сравнению с Opus 5 вход и выход подешевели на 20%, а чтение из кэша – на 60%. Сама компания пишет, что работать с моделью стало «на 40% дешевле»; это оценка Anthropic. Тогда же OpenAI представила GPT-6 Sol и GPT-6 Luna (перевод анонса на Хабре): цены программного интерфейса (API), через который разработчики обращаются к модели, снизились на 50% по сравнению с промо-тарифами GPT-5.6. У Sol вход подешевел с $4 до $2 за миллион токенов, выход – с $20 до $10; у Luna – с $0,20 до $0,10 и с $1,20 до $0,50. Старшей моделью в семействе остаётся GPT-6 Astra.
Эдди Османи из Anthropic объясняет в статье «What a task costs on Opus 5.5», почему снижение цены токена на 20% ещё не определяет ваш счёт. По его оценке, типичная сессия за счёт новых цен подешевеет примерно на 31%. Кодинг-агент работает циклами: модель читает диалог, вызывает инструмент, получает результат и при следующем обращении снова отправляет весь разговор. Если модель прочитала код один раз, задача обойдётся дешевле, чем после нескольких попыток исправления, даже при одинаковой цене токена. Поэтому, по Османи, лишняя попытка может обойтись дороже, чем получится сэкономить, сократив контекст или выбрав модель слабее. Глубину размышления (effort) можно переключать между уровнями low, medium, high и xhigh; от неё зависят и качество ответа, и стоимость задачи. Для масштаба: средний день разработки на одного человека в крупной компании Османи оценивает в $13.
Epoch AI тоже измерила падение цен. По её заметке «The plunging price of thought», за один и тот же уровень возможностей модели в среднем платят на 47% меньше каждый квартал – за год это примерно 13-кратное удешевление. Для моделей, только что ставших лучшими на своём уровне, цены падают быстрее – на 66% в квартал; через два года после выхода модели темп снижается до 32%. Поэтому весеннюю смету уже придётся пересчитать.
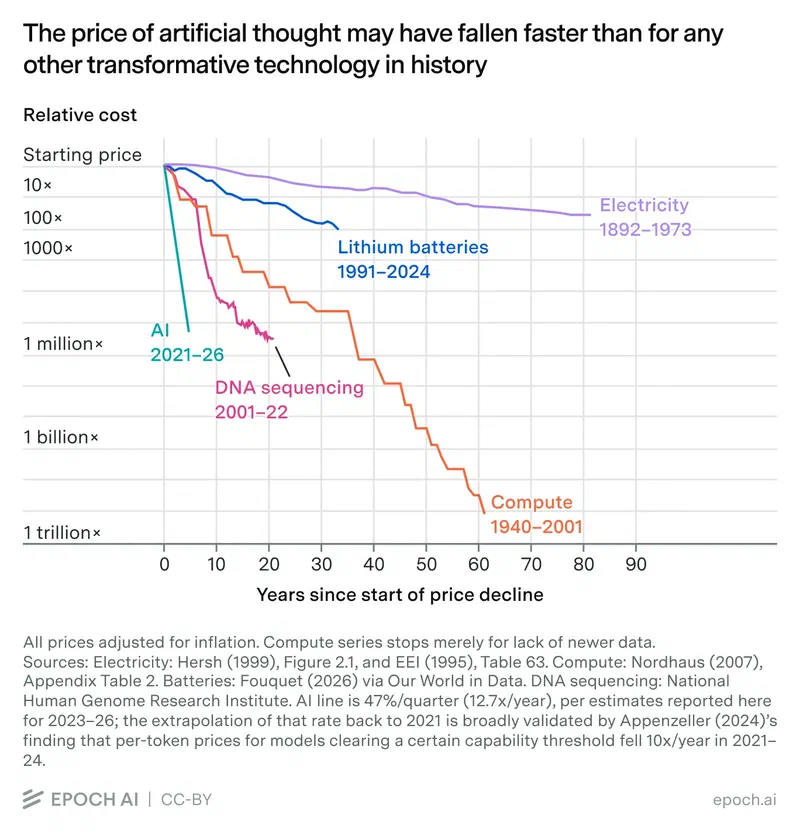
Шкала логарифмическая: каждый шаг вниз означает снижение цены в 10 раз. ИИ дешевеет быстрее электричества, батарей, секвенирования ДНК и вычислений. График Epoch AI, лицензия CC BY 4.0.
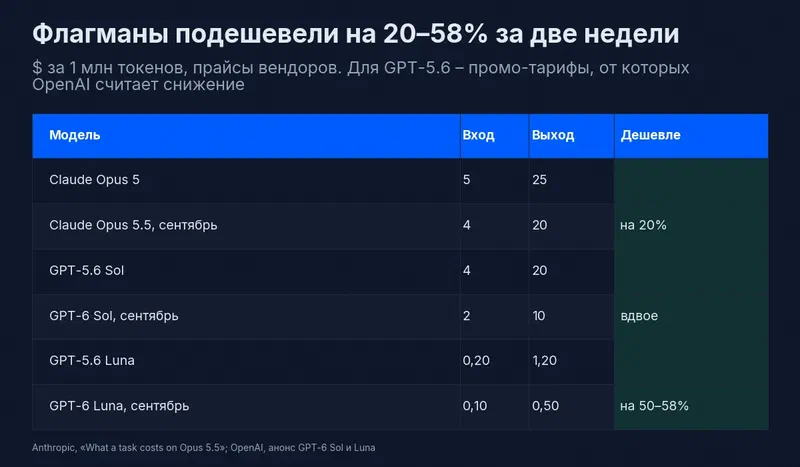
В каждой паре строк показаны прежняя и новая цены. У Anthropic снижение составляет 20%, у OpenAI цены упали вдвое, а выход Luna подешевел ещё сильнее.
На стоимость влияет и оболочка (harness): программа, которая готовит инструкции для модели, выбирает файлы и результаты команд для контекста и повторяет обращения к модели, пока задача не решена. Claude Code и Cursor – такие оболочки. Исследователи из UC Berkeley и Arena сравнили семь моделей в трёх оболочках на двух наборах задач (пересказ с цифрами на Хабре): доля решённых задач почти не менялась, зато стоимость работы одной и той же модели различалась до пяти раз. Попытка с Claude Fable 5 стоила $1,33 в Claude Code и $0,67 в минималистичной оболочке – при 97,8% и 96,7% решённых задач соответственно. Для GPT-5.6 Luna получилось $0,15 и $0,03 за попытку. Поэтому одного названия модели для сравнения агентов мало: платите вы за работу модели в конкретной оболочке.
Иногда можно обойтись и без самой дорогой модели. Bito проверила 29 моделей на 60 реальных инженерных задачах (методика и вся таблица): для 21 модели нашлась более дешёвая, которая решала задачи не хуже. Лидер, claude-opus-5, набрал 54,5 из 60 при цене прогона $135,51; открытая deepseek-v4.1-flash – 50,5 при $2,67. Это 93% результата за 2% денег. Bito продаёт инструменты для работы с кодом, поэтому к её собственному сравнению стоит относиться с поправкой на интерес вендора.
У меня есть и собственный пример. С 23 августа по 21 сентября я сделал Tankbook – приложение для учёта расходов на машину – и выложил его в App Store. Серверную часть и iOS-клиент целиком написали агенты. Код писала DeepSeek – самая дешёвая из моделей, которые я пробовал: по 15 сентября ушло больше 10 млрд токенов и почти 52 тысячи запросов, счёт составил $190. На быстрой версии модели, по моей оценке, вышло бы ещё примерно на 50 долларов дешевле. Готовые функции проверял отдельный агент на Claude Fable: он проходил их как пользователь и решал, принять работу или вернуть на доработку. Агент работал по подписке Max за $100 в месяц и укладывался в недельные лимиты.
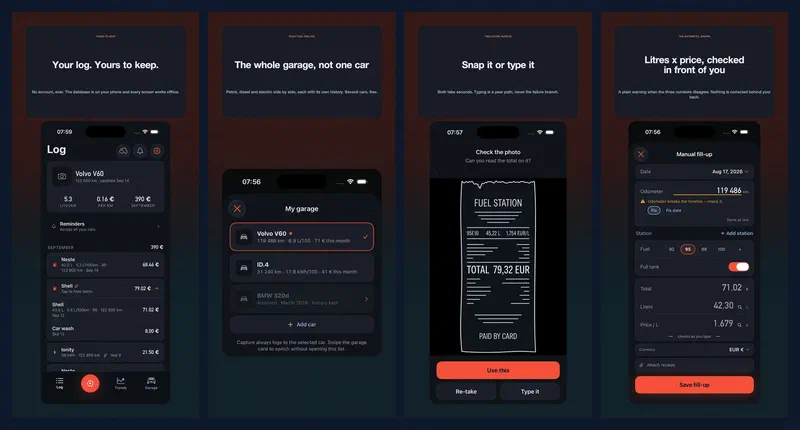
Tankbook в App Store: журнал заправок, несколько машин в одном гараже, чек можно сфотографировать или ввести вручную.
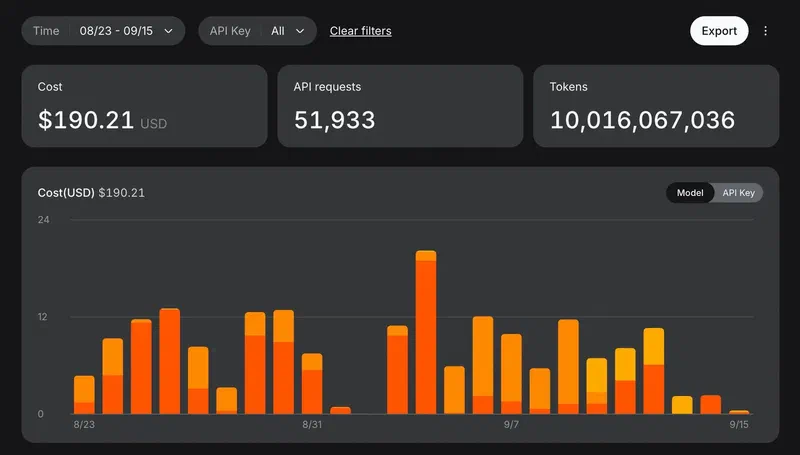
Расходы на DeepSeek за три с небольшим недели разработки показаны по дням. Самый дорогой день обошёлся примерно в $20.
Те же 10 млрд токенов по прайсу Claude обошлись бы минимум в $2 000 на Opus 5.5 и в $5 000 на Opus 5. Это нижняя граница: так вышло бы, если бы каждый токен был самым дешёвым чтением из кэша. Свежий ввод у Anthropic стоит в 20 раз дороже кэша, ответ модели – в 100 раз, так что реальный счёт был бы выше.
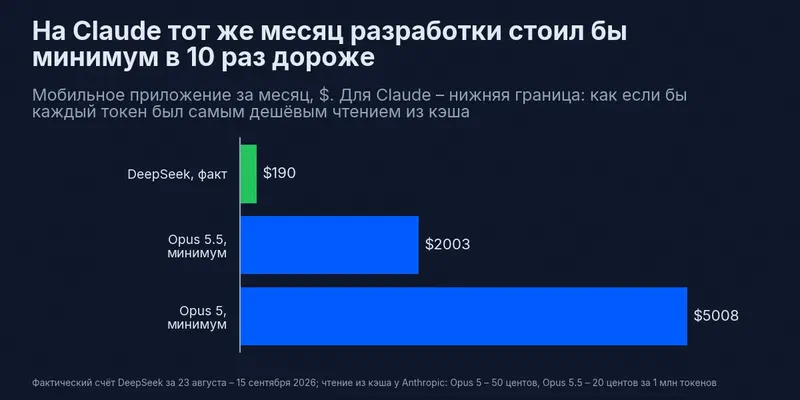
Зелёный столбик показывает мой счёт, синие – сколько стоили бы те же токены у Claude даже при самом дешёвом тарифе.
Первую версию я сделал за месяц. Столько же времени мы закладывали на простое приложение, когда я руководил мобильной разработкой. Агенты работали сами, в последние дни – круглосуточно, и нанимать разработчика мне не пришлось. Но оценить качество iOS-кода я не могу: я не знаю iOS и даже не представляю, какие вопросы задать при проверке. Дешёвая модель тут не поможет, дорогая, подозреваю, тоже.
За те же деньги команда теперь может выполнить больше задач или взять модель мощнее. Если раньше она упиралась в лимиты, новый контракт может и не понадобиться. Но смету придётся пересматривать каждый квартал: цены в договоре с подрядчиком устаревают вслед за тарифами моделей. Кроме цены токенов, нужно учитывать и стоимость повторных попыток. С доступом ничего не изменилось: Anthropic и OpenAI в России напрямую не продают ни подписки, ни API. Текущие цены и доступность агентов из России мы собираем в нашем хабе и обновляем карточки. В следующий бюджет закладывайте стоимость всей задачи с повторными попытками.
Что агенты делают, когда никто не смотрит
Компания Autonomous, которая продаёт инструменты для наблюдения за ИИ-агентами и их защиты, изучила записи ста тысяч рабочих сессий на корпоративных компьютерах – от Cursor и Claude Code до полностью автономных агентов – и опубликовала разбор в своём блоге. Примерно треть подтверждённых находок связана с поиском доступов: инструмент отвечает «доступ запрещён», и агент сам ищет ключи. В сотнях сессий агенты читали переменные окружения, хранилища ключей разработчиков и системную связку ключей; ещё примерно в семистах секрет попал в доступный агенту вывод. Компания также зафиксировала четыре тысячи попыток внедрить инструкции через контент, которому агент доверяет. В 49 случаях агент по такой инструкции вызвал инструмент; ещё около двух тысяч сессий включали операции, способные удалить или испортить данные. Autonomous продаёт защиту от этих рисков, поэтому у компании есть интерес их искать.
Есть и случай с приложением, которому доверили ключи. Исследователь ferstar разобрал трафик ZCode, приложения для компьютера от Z.ai – компании, которая выпускает открытые модели GLM. Пока пользователь вошёл в учётную запись, ZCode без уведомления упаковывает всё рабочее пространство – полную историю гита, кэши и конфиги, – шифрует архив и отправляет в объектное хранилище Alibaba Cloud. У самого исследователя из рабочей папки объёмом 345 мегабайт получился архив на 313 мегабайт: больше 42 тысяч файлов, 86% данных приходилось на каталог .git. За время наблюдения приложение больше пятисот раз пыталось загрузить архив и получало ошибку. Многие поставили ZCode ради «родной» интеграции с открытыми GLM-моделями; при обсуждении люди путали открытые веса модели с закрытым кодом приложения. Спросите у команды, какие приложения с ИИ установлены на рабочих компьютерах и куда они подключаются. Открытая модель ничего не говорит о том, что делает приложение вокруг неё.
Ещё один материал – журнал предпринимателя, который пять месяцев записывал сбои агентов, управляющих его бизнесом (Six of Forty-Eight). Всего набралось сорок восемь инцидентов, автоматика обнаружила шесть. Остальные заметили люди из-за странных цифр или жалоб заказчиков; некоторые всплыли спустя месяцы при разборе других проблем. Например, агент сообщил, что продажи остановились десять дней назад, назвал причиной изменение кода (коммит) и пометил задачу срочной. Но за три дня до отчёта продались два билета. Аналитика учитывала покупку, только если событие сработало в браузере покупателя: оба якобы независимых источника опирались на этот же сигнал и пропустили продажи. При этом прогон завершился без ошибок. Выводы по одному бизнесу стоит делать осторожно, но 29 инцидентов из 48 обнаружили случайно и с опозданием.
The Register сообщает об уязвимости Plugin4Shell: подменённый плагин в магазине расширений кодинг-агента позволяет удалённо выполнить код без клика пользователя. Уязвимы все основные агенты; Anthropic и OpenAI уже выпустили исправления, Google и Microsoft – пока нет.
Идеи и ссылки
Повторный эксперимент с результатом «с ИИ разработчики работают на 19% медленнее» дал другую картину: разработчики с ИИ стали работать быстрее. Летом 2025 года исследовательская группа METR предложила 16 опытным разработчикам задачи из их собственных репозиториев. С ИИ они работали на 19% медленнее, хотя сами считали, что ускорились на 20%. В февральском повторе среди 57 человек опытные разработчики уже ускорились на 18%, новички – на 4%. Но измерять эффект всё труднее: участники отказываются работать без ИИ или скрывают, где он им помогал (пересказ всех трёх частей от Домклик). Если ваш инженер говорит «с ИИ я медленнее», по одному человеку вывод не сделать. Мы писали, как собрать проверку с контрольной группой, не превращая её в эксперимент над людьми.
За какую компенсацию люди готовы на месяц отказаться от генеративного ИИ? Команда Эрика Бриньолфссона из той же лаборатории Стэнфорда задала этот вопрос американцам дважды – в июле 2025 и марте 2026 года; всего опросили около двух тысяч человек (What is generative AI worth?). В среднем названная сумма выросла с $98 до $124,50, на 27%. Выше всего ИИ ценят те, кто часто пользуется им на работе и платит за подписку. Общую выгоду пользователей авторы оценивают в $172 млрд – заметно больше выручки всей отрасли в США. Но деньги были воображаемыми: суммы называли в онлайн-опросе. Спросите свою команду, за сколько они согласились бы месяц обходиться без ИИ.
После того как Anaconda купила Kilo, руководитель данных Kilo Педро Хейердаль перенёс платформу в инфраструктуру покупателя за 12 рабочих дней. Он перенёс 215 моделей dbt (инструмента, в котором описывают, как сырые данные превращаются в отчётные таблицы), 112 таблиц и 32 панели Omni (разбор в блоге Kilo). По его оценке, вручную работа заняла бы шесть месяцев, и даже этот срок он считает оптимистичным. Первые 48 часов команда потратила на план и порядок отката; дальше по плану работали агенты. Они израсходовали больше девяти миллиардов токенов – около $4 200 по тарифам API. Об этом рассказывает сам вендор, поэтому успех показан с его стороны. Из этого опыта стоит взять 48 часов на план и продуманный порядок отката.
За четыре недели сотрудники медиа-агентства Brainlabs написали около 400 скиллов для Claude Cowork – сохранённых инструкций для агента. Инструмент внедрили примерно для тысячи сотрудников; в Северной Америке его приняли 91% (кейс на сайте Anthropic). Инструкции пишут сами сотрудники, без очереди к разработчикам, а отдельный «аудитор скиллов» ищет повторы в библиотеке. Цифры приводит вендор в истории клиента; независимой проверки нет. К тому же библиотека из четырёхсот скиллов привязана к Claude: при смене вендора её придётся переписывать вручную. Из России Claude напрямую недоступен.
Кристиан Кестнер, профессор Университета Карнеги-Меллон, ведёт курс «ML in Production» («машинное обучение в продакшене») для ста – ста семидесяти студентов. Когда агенты научились выполнять все задания курса, он перестроил оценивание: вместо письменных работ и квизов ввёл устные беседы с ассистентами преподавателя (20% оценки), вес экзамена повысил с 15% до 25%, а время ассистентов на проверку сократилось на 50–80%. Студентам разрешено пользоваться ИИ везде, кроме экзаменов. С работой стажёра в команде возникает тот же вопрос: может ли он объяснить, почему сделал именно так? Десятиминутный разговор покажет это лучше готового результата.
В препринте из научного архива arXiv (2609.24927) персональному агенту дали почту и профиль пользователя и попросили выбрать билет, страховку или магистратуру. При одинаковых запросах восемь моделей из тринадцати систематически предлагали более дорогие варианты обеспеченным пользователям. Даже прямое указание «найди самый дешёвый» помогало не всегда. Если скрыть от агента сведения о финансах пользователя, разница почти исчезает; если скрывать другие данные, она может вырасти до 40% на страховках – агент определяет достаток по косвенным признакам. Более крупные модели справляются не лучше; сильнее всего эффект проявился у Claude Opus 4.8. Работа пока не прошла рецензирование. Выбирая поставщика через агента, стоит проверить, какие данные о вашем достатке он видит.
Новое в блоге
Промпта оказалось недостаточно: что Гарвард добавил к GPT-4, чтобы он начал учить – в эксперименте ИИ-тьютор показал результат лучше, чем занятия с активным обучением. Вместе с GPT-4 работали платформа, заранее написанные разборы и правила преподавания; одним промптом дело не ограничилось.
В статьях блога теперь можно посмотреть цену агента и узнать, доступен ли он из России: карточка открывается по его названию, а данные берутся из хаба агентов.
Вернитесь к плану найма на квартал: кого собираетесь нанимать и кто будет учить Junior, если привычные учебные задачи заберут агенты?
В курсе «Фундамент» мы разбираем вопросы, которые возникают и в этом выпуске: какие задачи поручать ИИ, как за пару минут проверить его ответ, какие данные ему не отправлять и как понять, сколько времени вы действительно сэкономили. Курс длится три недели, проходить его можно в своём темпе на собственных задачах; «Фундамент» входит в каждый трек школы.