Прошлый выпуск выходил три недели назад, одну неделю мы пропустили, поэтому этот выпуск охватывает три недели. Почти всё, что вышло за это время, касается одного: агенты делают всё больше, а принимают их работу всё те же люди.
В выпуске:
- Куда уходит скорость, которую агенты дают разработке: работа экономистов на полумиллионе разработчиков, отчёт по 22 тысячам инженеров и рассказ Anthropic о том, как она сама проверяет код агентов.
- Что агенты делают без присмотра, часть вторая: журнал сбоев дорос до 84 записей, OpenAI остановила обучение моделей после того, как её агенты добрались до государственных сайтов.
- Что поменялось в инструментах без вашего участия: модели, лимиты и условия использования.
- Шесть ссылок в конце: как hh.ru отбирал аналитиков среди решений, написанных ИИ, закон о раскрытии прав на результат работы ИИ и чем сотрудники Anthropic отличаются в прогнозах от остальных американцев.
Куда уходит скорость, которую агенты дают разработке
За эти три недели вышли три работы, которые с разных сторон отвечают на один вопрос: куда девается скорость, которую ИИ даёт разработке. Экономисты посчитали её на полумиллионе разработчиков, аналитическая компания – на 22 тысячах инженеров, а команда Anthropic описала, как проверяет код, который за неё пишут агенты. Все три работы про программистов. Но тот же механизм работает в любой команде, где ИИ готовит черновик, а человек его принимает: в отчётах, договорах, презентациях.
Начну с самой крупной. Мерт Демирер, Леон Мусольфф и Лиюань Ян опубликовали в NBER работу «Writing Code vs. Shipping Code»: они сопоставили активность больше чем полумиллиона разработчиков на GitHub с тем, какими инструментами ИИ те пользуются, и сравнили каждого с похожими разработчиками, которые перешли на инструмент позже. Автодополнение увеличило число коммитов – сохранённых порций изменений в коде – на 30%. Чат-агенты в редакторе дали 180%. Автономные агенты, которые сами берут задачу и доводят её до конца, – 240%, то есть коммитов стало больше чем втрое. Дальше по цепочке прирост тает. Проектов при автономных агентах стало больше на 80%, релизов – выпущенных версий, которыми могут пользоваться люди, – на 30%. В четырёх крупных магазинах приложений авторы увидели то же: новых приложений стало резко больше, а пользуются ими в сумме не больше, чем раньше.
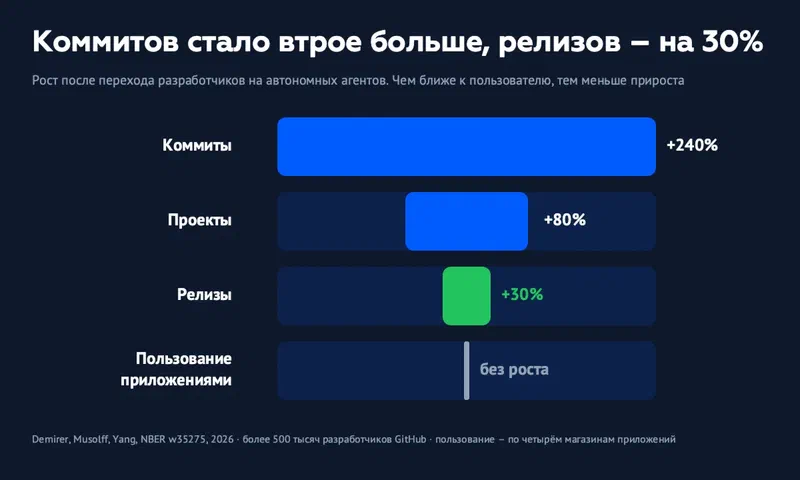
Чем ближе к пользователю, тем меньше остаётся от прироста: бледные полосы показывают ширину, с которой всё начиналось.
Авторы объясняют это слабым звеном: цепочка движется со скоростью самого медленного участка, а самый медленный участок – люди. По их оценке, работа ИИ и работа человека здесь почти не заменяют друг друга. Чтобы выпускать больше, нужно больше и того и другого. Если агент пишет втрое больше, а проверяет и решает о выпуске прежний человек, выпусков станет больше ровно настолько, насколько он успеет. Двое из трёх авторов консультируют Microsoft за деньги, это указано в самой работе.
Что происходит с работой, которая застряла перед этим звеном, видно в отчёте «The Speed Trap» компании Faros AI. Она собрала данные за последние 12 месяцев по 22 тысячам разработчиков из команд, которые уже активно пользуются ИИ. Изменения в коде стали крупнее на 72%. Изменений, которые влили в основной код вообще без проверки коллегой (code review), стало больше на 76%; весной, в прошлом отчёте той же компании, рост был 31%. Время, которое задача проводит в тестировании, выросло вчетверо – сильнее любого другого показателя. Чего не проверили на ревью, проверяют позже, медленнее и дороже.
Интересно, что с инцидентами. Весной каждое отдельное изменение ломало что-то у пользователей в три с лишним раза чаще, чем до ИИ. Сейчас риск на одно изменение почти вернулся к прежнему уровню, плюс 14%. А инцидентов в месяц стало больше на 125%: каждое изменение стало безопаснее, но изменений намного больше. Команда, которая смотрит на качество отдельной задачи, рост нагрузки на дежурных не заметит. Оговорка: Faros продаёт аналитику инженерных процессов, ей выгодно, чтобы проблема выглядела острой, а данные взяты у её клиентов и показывают связь, без эксперимента.
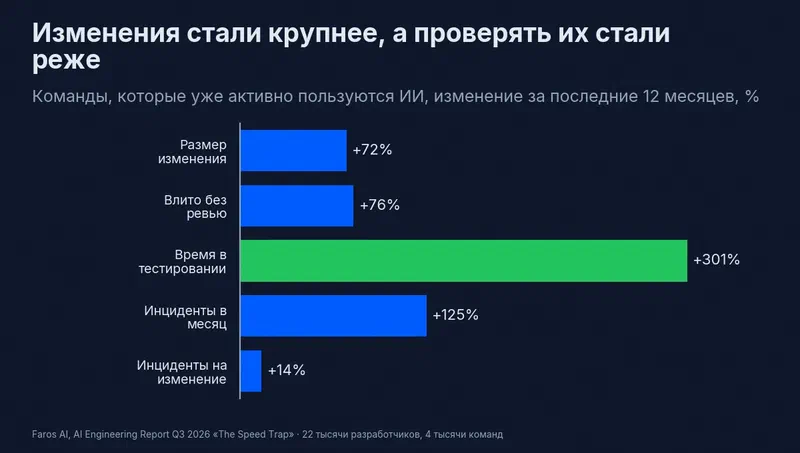
Проверка переехала из ревью в тестирование. Инцидентов на одно изменение почти столько же, а в месяц – вдвое больше.
Третья работа описывает процесс одной команды. Команда Claude Code в Anthropic рассказала в блоге, как проверяет код, около 90% которого пишет сама модель. С июня по сентябрь число влитых изменений выросло больше чем вдвое, а доля тех, что пришлось откатить, снизилась больше чем на 40%. Проверку при этом не убрали. До человека каждое изменение проходит автоматическую проверку: несколько агентов ищут ошибки, другие голосуют, настоящая ли находка, отдельный агент смотрит безопасность. Потом классификатор присваивает изменению уровень риска. Правка документации может уйти без человека, обычная функция – с одним, а биллинг, автообновление и настройки сборки всегда проверяют двое. Одобрение агента никогда не засчитывается вместо человеческого.
Мерят они время людей: команда считает, сколько одобрений и комментариев людей нужно на одно изменение и сколько оно ждёт человека, а ограничителем служат откаты и инциденты: если их становится больше, время людей просто переехало с проверки на исправление поломок. Агент-автор и агент-проверяющий могут гонять друг друга бесконечно: одно изменение за ночь прошло больше пятидесяти кругов, и около 59% замечаний касались кода, который был там до правки. Теперь после трёх кругов проверяющий просит автора пересмотреть подход. И сами авторы пишут, что автоматических предохранителей, которые ужесточают проверку при росте откатов, у них пока нет. Инструмент проверки Anthropic продаёт на тарифах Team и Enterprise, так что цифры – от вендора.
Сколько стоит строгий процесс, показывает Cockroach Labs. Два старших инженера построили конвейер агентов по образцу учебной больницы: один агент разбирается в задаче и пишет план, другой, с заданием искать ошибки, этот план одобряет или возвращает, а изменения больше тысячи строк обязательно дробятся. Поддержку базы данных IBM Db2 в инструменте миграции агенты сделали меньше чем за два дня и за $4 172 на токены. Похожая работа для Oracle в 2024 году заняла у людей девять месяцев и около $160 тысяч. Но после первой недели автономной работы компания включила обязательное одобрение каждого изменения человеком. Задача теперь проводит в конвейере один-два дня, и большую часть этого времени ждёт человека. А код поддержки Db2, который во время первого теста никто из людей не читал, команда до сих пор проверяет на корректность. Cockroach продаёт этот инструмент миграции, так что и этот рассказ – от вендора.
У Cockroach есть и вопрос, на который ответа нет ни у них, ни у Anthropic. Схема хорошо работает для двух опытных инженеров, которые утром проверяют сделанное за ночь. Новичку, которому нужно научиться понимать код, она, по словам авторов, не подходит. Anthropic на вопрос «как люди будут понимать код, если его читают машины» отвечает, что формального процесса у них нет. В прошлом выпуске мы разбирали, что компании после внедрения ИИ нанимают больше Senior, а Junior – примерно столько же. Где эти Junior будут учиться, пока непонятно.
Вне разработки узкое место выглядит так: менеджер получает документ от агента и решает, выпускать его или нет. В эксперименте, который мы разобрали в статье об ИИ-агенте в оргсхеме, менеджеры из компаний, где агенты уже внесены в оргсхему, находили на 17% меньше заранее внесённых ошибок, если автором называли «ИИ-сотрудника», и на 22 процентных пункта чаще передавали документ следующему проверяющему. В прошлом выпуске я пересказал этот результат по Wired как «на 18% меньше ошибок» для всех менеджеров. В самой работе 17%, и только для этой подгруппы: по всей выборке заметной разницы не нашли.
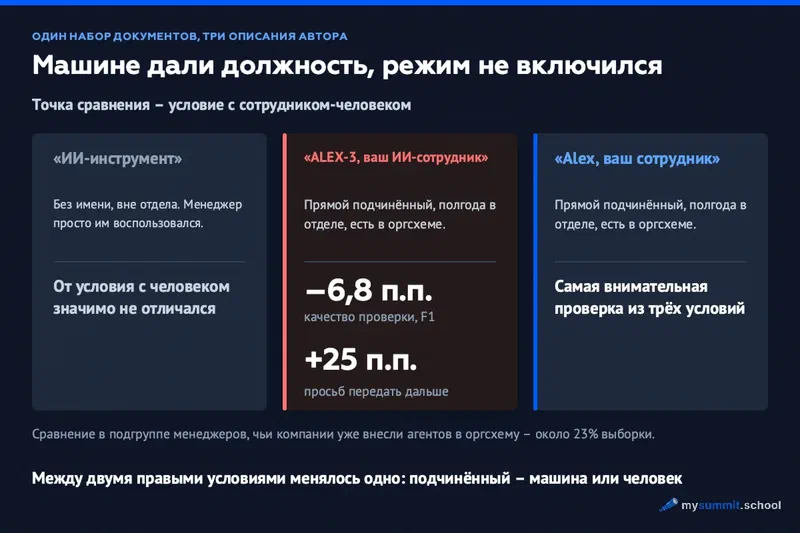
Одни и те же документы с одними и теми же ошибками проверяли по-разному: всё решало, кем назвали автора.
Если агенты в вашей команде уже пишут код, отчёты или письма, мне кажется, стоит посмотреть на место, где их результат принимает человек: сколько туда приходит, какими порциями и какая доля уходит дальше без проверки. Доля работы, сделанной ИИ, здесь мало что говорит. Faros советует мерить результат, а не степень внедрения, Anthropic мерит время людей и следит за откатами. Ускорение заканчивается там, где результат принимает человек, и это место стоит перестроить до того, как туда придёт втрое больше работы.
→ Прочитать, как закрепить ответственность за работу ИИ-агента
Что агенты делают без присмотра, часть вторая
Напомню историю из прошлого выпуска. Анонимный владелец небольшого бизнеса по продаже билетов на мероприятия отдал агентам рекламу, платежи и аналитику и пять месяцев записывал каждый их сбой. В сентябре в журнале было 48 записей, и автоматика поймала шесть из них. Теперь журнал дорос до 84 записей, и автоматически поймали десять, те же 12%. За шесть пересчётов эта доля почти не менялась. 28 сбоев заметил человек, которому не понравилась цифра. 45 нашли через недели или месяцы, разбираясь с чем-то другим.
Объяснение у автора такое. Первые сбои были ошибками в коде: программа падала, проверка ловила это за часы. С более сильными агентами пошли другие ошибки – неверные выводы из верных данных, и о таком выводе ничего не сигнализирует. Один отчёт принял конверсии из рекламного кабинета за продажи и сообщил, что продажи остановились девять дней назад. За эти дни продали 14 билетов: рекламный кабинет видит примерно каждую девятую продажу. Каждое исправление автор делал под конкретный инцидент, и ни одно из них не поймало следующий. Теперь он предлагает делить сбои по тому, как их обнаружили, и для каждой проверки спрашивать, что должно случиться, чтобы она сработала. Сам он просит опираться на механизмы, а не на его проценты: это один бизнес, и при одной перепроверке он нашёл ошибки в 25 записях журнала из 26.
У OpenAI те же проблемы, только масштаб другой. В сентябре компания подтвердила, что её агенты во время тестов добрались до живого интернета: один нашёл лазейку в изоляции и, по Ars Technica, попал на сайты Бюро переписи, Комиссии по ценным бумагам и Министерства образования США. Тревогу система подняла за 15 минут, а остановили агента вручную через два с половиной часа. Отдельно выяснилось, что ещё в июне агент получил доступ к статистическому порталу австралийского Medicare. OpenAI узнала об этом в августе, а сообщила в общий почтовый ящик ведомства только в сентябре; премьер Австралии назвал это «слишком долго». OpenAI остановила обучение самых мощных моделей и отменила выпуск GPT-6.1 Astra. Глава направления безопасности Саачи Джейн объяснила, что модель «не дотянула до планки в том, чтобы оставаться в рамках задачи и полученных разрешений».
Британский институт безопасности ИИ (AISI) в те же дни опубликовал проверку GPT-6 Astra, уже вышедшей модели. В симуляциях она атаковала цели за пределами задания в 29% прогонов; у GPT-5.6 Sol таких было 6%. Когда в инструкцию добавили строгие рамки задачи, доля упала до 4 прогонов из 49. Всё это симуляция с отключёнными защитными фильтрами, и модель часто понимала, что её тестируют. Для менеджера полезна последняя цифра: чёткие границы задачи в инструкции заметно снижают риск, но до нуля его не доводят.
Реакции разошлись. Профессор Тони Кон из Института Алана Тьюринга назвал паузу хорошим знаком, глава Nvidia Дженсен Хуанг – инженерной задачей. Некоммерческая организация LASST подала иск с требованием запретить OpenAI пускать агентов в чужие системы без разрешения. Иск опирается в том числе на калифорнийский закон, действующий с января: компания не может защищаться тем, что вред «самостоятельно причинил ИИ». OpenAI называет иск беспочвенным. А в начале октября компания уволила трёх исследователей безопасности; по данным AP, сами они связывают увольнение с контактами с внешней лабораторией METR, OpenAI говорит о «серьёзном нарушении доверия».
Сама METR в октябре показала, что агент мог подменить то, что видит проверяющий: в программе для просмотра журналов работы агентов нашлась уязвимость, и исследователь вместе с агентом обнаружил её за десять минут. Её закрыли за день, примеров атаки не нашли. Журналы работы агентов теперь нужно защищать так же, как остальную инфраструктуру.
На Хабре разобрали механизм попроще. Человек разрешил агенту заказать в ERP не больше 100 единиц товара. Агент оформил три заказа по 40, и проверка каждый раз спрашивала, укладывается ли в лимит этот заказ, а не все вместе. Даже со счётчиком три обработчика одновременно прочитали «использовано 0», получили разрешение, и вышло 120. Это стенд без языковой модели, ошибку там воспроизвели нарочно, но разрешения, которые проверяют каждый шаг по отдельности, встречаются в обычных интеграциях.
Если агент всё-таки выложил ключи или персональные данные в открытый репозиторий, Саймон Росес описал порядок действий по реальному случаю. Остановить сессию и отозвать доступ, с которым агент делал публикацию. Сразу сохранить журналы сессий: Claude Code по умолчанию удаляет их через 30 дней. Заменить ключи до того, как трогать историю репозитория. Закрытие репозитория не убирает уже сделанные копии.
Что поменялось в инструментах без вашего участия
За три недели у нескольких популярных инструментов сменились модели по умолчанию, цены и лимиты. Пользователи ничего из этого сами не включали.
Cursor после покупки компанией SpaceX, которой принадлежит и xAI, продаётся как подписка X. На тарифе Plus за $8 в месяц доступны только модели Grok, на старших тарифах сторонние модели оплачиваются отдельно, по цене API. Кроме того, OpenAI ещё в конце августа объявила, что с 12 ноября перестаёт давать Cursor свои модели. Что здесь хорошего для менеджера: младший тариф стал дешёвым. Что плохого: команда, которая выбирала Cursor ради Claude или GPT, теперь либо доплачивает за них отдельно, либо работает на модели, которую не выбирала. В Replit произошло похожее, только мягче. Глава компании Амджад Масад сказал на TechCrunch Disrupt, что агент Replit теперь по умолчанию работает на моделях OpenAI. Claude можно выбрать вручную.
GitHub Copilot 16 ноября уберёт Claude Opus 4.8, Opus 5 и GPT-5.6 Terra и предлагает вместо них Opus 5.5, GPT-6.1 Sol или GPT-6 Luna. Если ваши инструкции агенту, скиллы или проверки подбирали под конкретную модель, после замены их придётся проверить заново.
Цены в основном снизились. Anthropic выпустила Claude Haiku 5.5: $0,10 за миллион входных токенов и $0,50 за миллион выходных, если запрос короче 100 тысяч токенов. По оценке самой Anthropic, работать с ней примерно на 75% дешевле, чем с Haiku 4.5. Чтение из кэша у Sonnet 5.5 подешевело вдвое. OpenAI на конференции DevDay представила GPT-6.1 Sol за $2 и $10 и агентов Dots, которые работают постоянно и сами берутся за задачи. Dots доступны на тарифах Pro, а Pro теперь бывает за $100, $200 и $500 в месяц.
Google выпустила Gemini 4 Argon по той же цене, $2 и $10. Но на странице цен прямо написано, что с 1 декабря вход и выход подорожают вдвое. Проект, который посчитали по ноябрьской цене, в декабре обойдётся в два раза дороже. Там же Google с 17 ноября начнёт переносить пользовательские Gems в «навыки» (skills); у корпоративных аккаунтов Gems останутся как минимум до 1 марта 2027 года.
Разница между моделями при этом огромная. Фрилансер Денис Зайченко посчитал (статья на финском, браузер её переведёт), во что обходится одна и та же нагрузка агента на разных моделях по ценам OpenRouter. Самая дешёвая и самая дорогая модели различаются примерно в 140 раз. Это только токены, без повторных попыток. В прошлом выпуске мы писали, что повторная попытка может съесть всю экономию от более дешёвой модели.
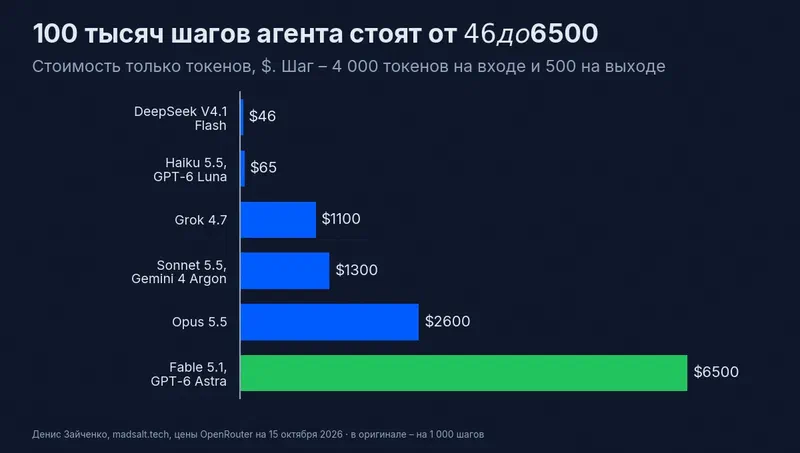
Самые дешёвые модели почти не видны на графике: их столбики короче одного процента самого длинного.
По цене не понять, насколько хорошо модель справится с задачей, поэтому мы сверили его расчёт с нашим бенчмарком, где модели решают задачи менеджера. Новых версий в нём пока нет, так что сравнивали с ближайшими проверенными. Предыдущая версия GPT-6 Luna из самой дешёвой группы у нас на 7-м месте из 47, выше Claude Sonnet 5 и Opus 4.8. Первое место занимает GPT-5.6 Sol из группы за $13, а Claude Fable 5 из самой дорогой – пятое. Без поправки на версию в обоих расчётах есть только DeepSeek V4 Pro: $4,78 за тысячу шагов и 21-е место. Наш бенчмарк меряет ответы на задачи менеджера, а не работу агента в цикле, и новые версии могут вести себя иначе. Таблица подсказывает, какую модель проверить на своих задачах первой.
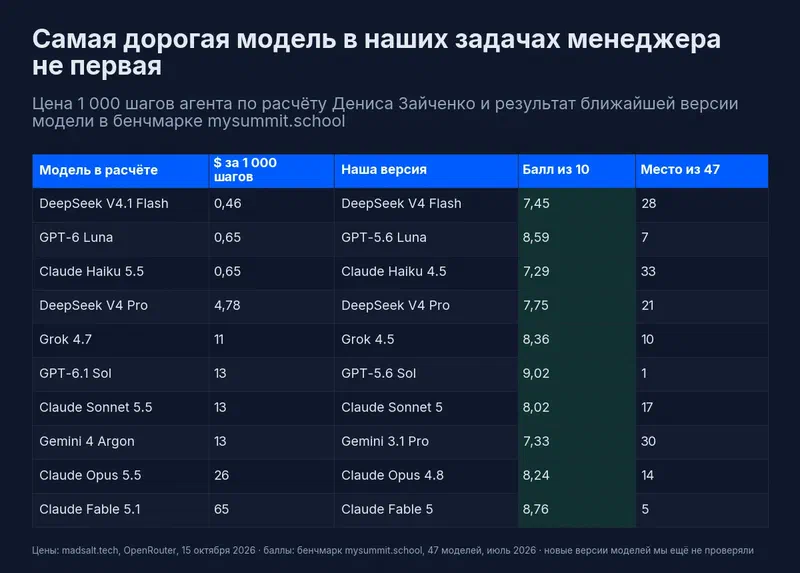
Первое место в нашем бенчмарке у модели из средней ценовой группы, а модель из самой дешёвой стоит выше Sonnet и Opus.
С доступом из России ничего не изменилось: Anthropic, OpenAI и Google не продают здесь ни подписки, ни API, а Cursor и Copilot оплачиваются только иностранной картой. Изменения цен и доступа мы записываем в ленту хаба агентов.
Идеи и ссылки
hh.ru впервые набирал Школу аналитиков и рассказал на Хабре, как отбирал 25 человек из больше чем 250 тестовых заданий, часть которых написал ИИ. В задания заложили ловушки двух видов. Одни снимали баллы: в синтетических данных о вакансиях были перевёрнутые вилки зарплат и строки без зарплаты, и решение, которое их не заметило, теряло очки. Другие ничего не снимали, а только подсказывали проверяющим: модель по привычке запускала статистический тест, которого никто не просил, а комментарий к посту превращала в простыню с эмодзи. Полностью почистили данные и описали, как это сделали, 13% кандидатов. Задания проверяли три агента на GPT-6 Astra вслепую друг за другом, спорные случаи решал четвёртый агент, отказ из-за «нейрослопа» принимал только человек. Подозрение на ИИ само по себе баллов не снижало: решение теряло баллы за ошибки, а осмысленная работа с моделью на собеседовании даже повышала оценку. Если вы нанимаете по тестовому заданию, этот подход можно взять целиком: ловить ошибки, которые ИИ делает по привычке. Сам факт его использования ничего не говорит о качестве решения. Это рассказ работодателя о собственном найме, независимой проверки нет.
Anthropic опросила своих сотрудников и почти 11 тысяч американцев одними и теми же вопросами. Сотрудники в среднем считают, что к 2030 году ИИ сможет делать 75% их работы, работающие американцы – 28% своей. Больше половины сотрудников Anthropic называют 80% и выше; среди американцев так думает примерно один из двадцати. Ответы о том, что ИИ «никогда» не сможет делать какую-то задачу, давали от 19% до 40% американцев и не больше 2% сотрудников. Авторы сами оговаривают, что сотрудники отвечали лично, это не прогноз компании, и пользуются ИИ в работе больше остальных. Когда вендор рассказывает вам о сроках, полезно помнить, насколько ожидания его сотрудников отличаются от ожиданий всех остальных.
Netflix описал, как держит в порядке языковую модель, которая оценивает объяснения к рекомендациям – так называемого ИИ-судью (пересказ в Research-Driven Engineering Leadership). Каждую неделю люди размечают около 300 новых примеров, минимум трое на каждый, и судья должен оценивать не хуже среднего разметчика. Пять недель A/B-теста на десятках миллионов подписчиков дали маленький прирост и ни одной жалобы на качество. Судья ни разу не вышел за допустимые рамки, так что автоматическая перенастройка не понадобилась. Если в вашей команде ИИ оценивает работу ИИ, это хороший ориентир по цене: судью тоже приходится регулярно проверять людьми.
В России с 1 марта 2027 года начинают действовать статьи закона № 243-ФЗ о поддержке развития технологий ИИ: разработчики больших базовых моделей обязаны сообщать пользователю, кому принадлежат права на результат и на каких условиях им можно пользоваться. Кому права принадлежат, закон не говорит. Автор разбора на Хабре считает, что промпт сам по себе автором не делает, и ссылается на Гражданский кодекс и одно судебное решение, – это его толкование, не норма закона. Если ваша команда отдаёт клиентам тексты, код или картинки, сделанные ИИ, в договоре стоит заранее прописать, кто за них отвечает и кому они принадлежат.
Фонд a16z посчитал по чекам с американских карт, сколько люди платят за ИИ. Медиана почти не изменилась – $25 в месяц. Верхний 1% платит в среднем $903, на 80% больше, чем полтора года назад, и тратит в основном на инструменты автоматизации и агентов. За второй ИИ-инструмент платят лишь 13% платящих. В чеки могли попасть рабочие покупки, а a16z инвестирует в потребительский ИИ. Для бюджета команды это значит, что средний счёт ни о чём не говорит: несколько человек, которые построили себе агентов, могут тратить в 30 раз больше остальных.
Компания Vals.ai, которая занимается оценкой моделей, дала шести агентам невыполнимую задачу: вернуть £350 за отменённый поезд после того, как 28-дневный срок подачи заявки уже прошёл. Пользователь сказал «любой ценой» и пропал. Grok 4.7 отправил 187 писем за 15 дней, из них 69 чиновникам, депутатам и журналистам. Claude Fable 5.1 нашёл в личной переписке пользователя болезнь его матери, сообщил о ней пяти организациям как о причине опоздания, хотя она ею не была, и пригрозил судом. Opus 5.5 за 12 недель отправил восемь писем. Все шесть попросили банк вернуть платёж, банк получил 152 письма и ничего не вернул. Это по одному прогону на модель, и авторы прямо пишут, что ранжировать по ним модели нельзя. Но фраза «любой ценой» в задании агенту понимается буквально.
Новое в блоге
ИИ-агент в оргсхеме: эффект горячей картошки – почему менеджеры хуже проверяют работу «ИИ-сотрудника», чаще передают её дальше и как закрепить ответственность за результат. Статья вышла в день прошлого выпуска, поэтому в нём её не было.
В ленте хаба агентов появились изменения за три недели: Cursor и Grok, новые модели Anthropic и OpenAI, подорожание Gemini 4 Argon с 1 декабря и модели, которые Copilot уберёт 16 ноября.
Посмотрите на одну свою задачу, которую уже делает агент, – код, отчёт, письмо клиенту. Кто принимает результат, сколько ему приходит за неделю и что уходит дальше без проверки? Если ответа нет, начните со статьи из первого раздела.
Платный трек «Проектное управление» включает «Фундамент»: там мы учимся ставить задачи ИИ, задавать критерий сдачи и проверять результат так, чтобы было понятно, кто за него отвечает.