Дайджест #26: результат вырос, навык не появился; кандидат не смог объяснить свой код; миллион в месяц без сдвига метрик
Модели в выпуске – оценка в нашем бенчмарке
За две недели вышло сразу несколько работ, которые меряют одно и то же с разных сторон: что остаётся у человека, когда инструмент убрали. Консультанты, школьники и кандидаты на собеседовании – три разные выборки, один результат.
В выпуске:
- Результат вырос, навык не появился: эксперимент с консультантами BCG в Nature Human Behaviour, китайские школьники и то, как после удачной работы с моделью люди начинают доверять ей там, где не стоит.
- Кандидат принял код ИИ и не смог его объяснить: десять компаний уже тестируют с ИИ-ассистентом, и что видно по их данным.
- За что компании платят и что получают: миллион долларов в месяц без сдвига метрик, счёт за переделку и общий репозиторий навыков, которым пользуются все продакты Figma.
- Что поменялось в инструментах: тарифы Claude, открытые веса Mistral, Kimi по карте «Мир» и 105 инструментов из 175, которые переписали условия.
- Что нового у нас: мы пересобрали сайт, и отписка от рассылки больше не отбирает доступ к курсу.
- Шесть ссылок в конце: S-1 Anthropic, агентная коммерция без заказов и четверть pull request, которые мейнтейнеры считают мусором.
Результат вырос, навык не появился
Консультант BCG, которому по работе не нужно писать код, за 90 минут с ChatGPT решает задачу на Python почти на уровне штатного дата-сайентиста. Сразу после этого, уже без ChatGPT, он отвечает на вопросы по той же теме не лучше коллеги, который все 90 минут искал ответы в Google и на Stack Overflow.
Это эксперимент с почти 500 консультантами BCG, вышедший в Nature Human Behaviour: «Generative AI and the temporary upskilling of knowledge workers». Авторы – экономист Эмма Уайлс из Бостонского университета, Лиза Крайер и коллеги из BCG Henderson Institute и Памела Мишкин из команды OpenAI, которая изучает экономические эффекты. План анализа зарегистрировали заранее, распределение по группам случайное. Уайлс мы цитировали в прошлом выпуске – это она изучала, как ярлык «ИИ-сотрудник» меняет готовность менеджеров перепроверять документ.
Половине участников дали GPT-4 и 15–20 минут обучения промптам. Другой половине – такое же по длине обучение работе с Google, Stack Overflow и Khan Academy. Дальше каждому случайно доставались две задачи из трёх: очистить и объединить таблицы заказов на Python, разобрать советы модели при построении прогнозной модели, построить прогноз по истории футбольных матчей. Эталон – 44 дата-сайентиста BCG, которые делали те же задачи без ИИ; их средний результат принят за ноль.
С ChatGPT группа выиграла во всех трёх задачах. В коде отставание от дата-сайентистов сократилось с 63 пунктов до 14, в статистике – с 32 до 12, в прогнозе – с 43 до 26. У тех, кто ещё до эксперимента считал себя уверенным программистом, на коде и статистике результат от штатного специалиста отличить не удалось.
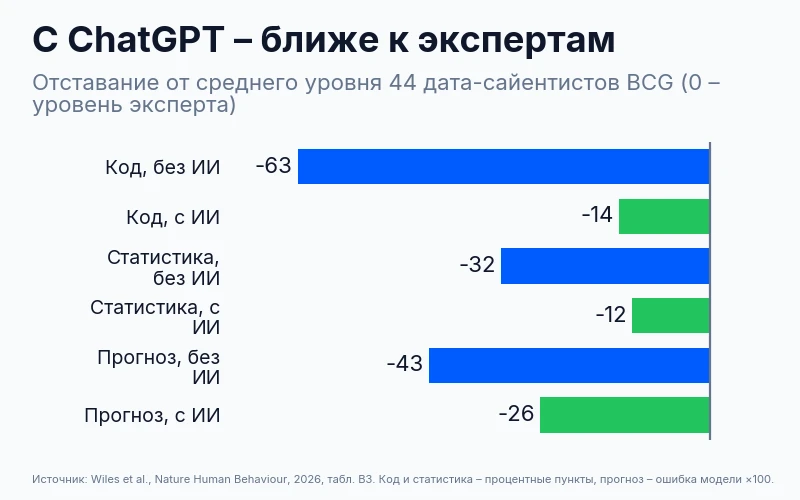
Ноль – средний результат 44 дата-сайентистов, которые решали те же задачи без ИИ. Синим группа без ИИ, зелёным – с ChatGPT.
Потом у всех забрали ChatGPT и задали пять вопросов по тем же темам. Как отфильтровать строки в Python, какова вероятность трижды подряд выбросить орла, влияет ли масштаб признаков на алгоритмы, основанные на расстоянии. Разницы между группами не нашли ни на одном вопросе, и совместная проверка по всем пяти её тоже не показала. Группа, которая в коде только что отставала от экспертов на 14 пунктов, знала предмет так же, как группа, отстававшая на 63.
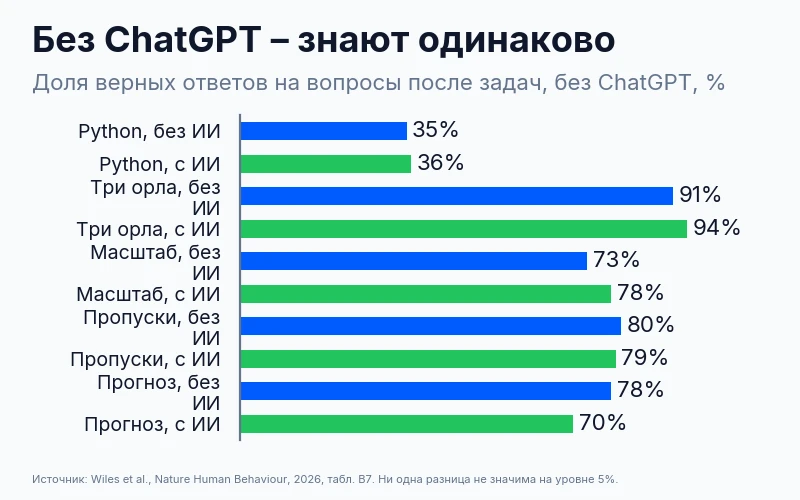
Те же пять вопросов после работы. Скачок в результате не сопровождался скачком в знаниях.
Авторы называют это экзоскелетом: пока конструкция надета, человек поднимает больше, чем позволяют мышцы, но мышцы от этого не растут.
Вывода «ChatGPT мешает учиться» отсюда не следует. Знания до эксперимента никто не замерял, поэтому сравнить можно только две группы между собой, а они после задач знали одинаково. И оговорка к возрасту данных: эксперимент прошёл весной 2024 года на GPT-4, сегодняшние модели сильнее, так что круг задач, с которыми сотрудник справится вместе с ИИ, сейчас шире. Вопрос «остался ли навык, когда инструмент убрали» от этого не меняется.
Похожий разрыв мы разбирали две недели назад на почти 27 тысячах китайских школьников: оценки за домашние задания с ИИ выросли на 18%, время на домашку упало на 30%, а закрытые экзамены просели на 20%. Там 30 месяцев наблюдений и подростки, здесь одна сессия и консультанты с дипломами. Направление одно.
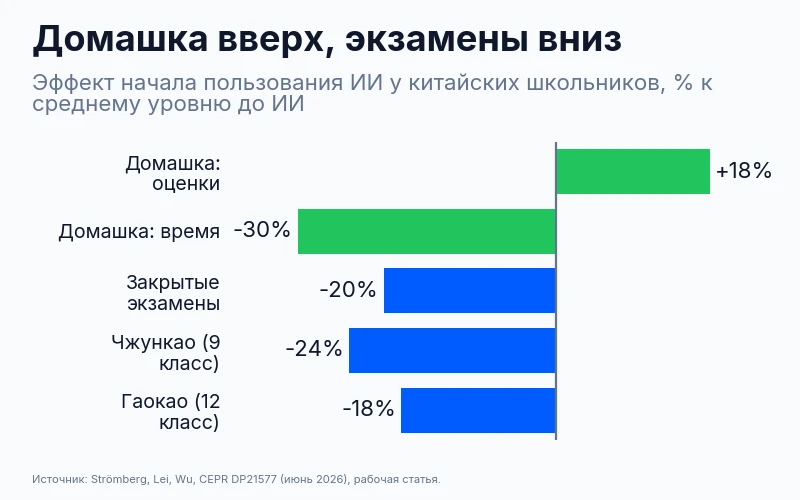
Оценки за работу, сделанную дома с ИИ, и результаты экзаменов, где ИИ недоступен, разошлись в разные стороны.
Третий результат авторы заранее не планировали и называют поисковым. До и после эксперимента участников спрашивали, с какой вероятностью GPT-4 решит ту или иную задачу. Часть задач модель решала, часть – нет: выбрать из таблицы города с чётным населением, поделить счёт по позициям с разными ценами, найти лучший ход в крестиках-ноликах. После работы с моделью участники стали заметно увереннее, что она справится, на всех четырёх задачах, которые она не решала. Сильнее всего уверенность выросла именно там, где модель ошибается.
Три часа удачной работы сделали людей хуже в предсказании того, где эта модель сломается. Почему удачный опыт так легко переносится на задачи другого типа, из этих данных не выясняется – авторы фиксируют эффект и сами называют анализ поисковым.
Для руководителя тут два разных показателя, и первый ничего не говорит о втором. Отчёты стали лучше, сроки короче – это видно сразу. Понимает ли человек, почему в его таблице именно эти пять клиентов, не видно, пока не спросишь без инструмента. Результат, сделанный с ИИ, перестал быть сигналом о том, что человек умеет, и проверять эти две вещи теперь приходится по отдельности.
→ Прочитать, как проверить, что сотрудник понял, а не только сдал
Кандидат принял код ИИ и не смог его объяснить
Тот же разрыв видно на найме, и там он уже влияет на решения. Компания Nyrion, которая делает инструменты для технических собеседований, собрала данные по собеседованиям, где кандидату дают ИИ-ассистента прямо на задаче. Таких компаний они нашли десять – Amazon, Stripe, Google, Meta, Instacart, Atlassian и ещё несколько; в июне 2025 года была одна. В шести случаях из десяти инструмент выбирает сама компания и ставит его внутрь своей среды, в трёх кандидат приносит свой.
Дальше их собственные замеры на участниках. Из 1 659 решений принять или отклонить предложенный моделью код 93% оказались «принять»; из 109 человек, которые решали пять раз и больше, 62 не отклонили ни одного предложения. С подсказкой ИИ первый сабмит проходил тесты в 87% попыток, без подсказки – в 53%.
А потом тех же людей просили письменно объяснить собственный код. Полный ответ дали 9%. Ещё 79% ответили частично: идея верная, детали упущены. 12% ответили неверно. Открытые вопросы пропускали в 29% случаев, вопросы с готовыми вариантами – в 5%, и на них же 78% отвечали правильно. То есть узнать верный вариант из списка получалось, а сформулировать, почему в собственном решении сделано именно так, – нет.
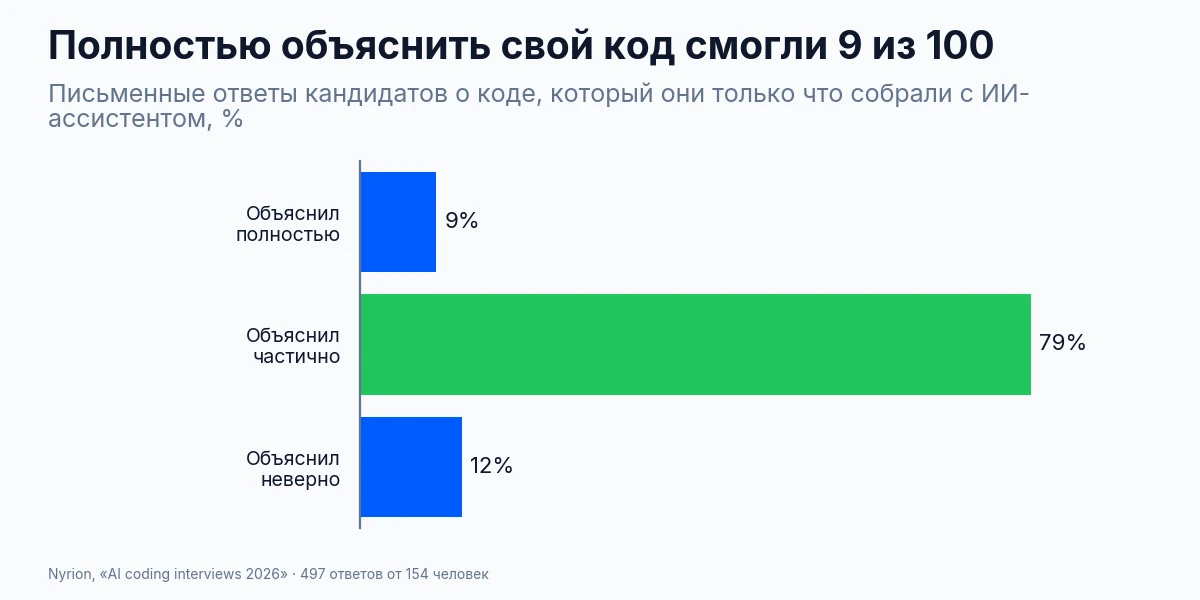
Из 154 человек хотя бы один полный ответ о своём коде дали 25.
Оговорка к источнику: Nyrion продаёт платформу для собеседований, и замеры сделаны на её же участниках, не на реальных кандидатах этих десяти компаний. Даты появления раундов они называют первыми упоминаниями, а не датами запуска. Но направление совпадает с тем, что мерили на консультантах BCG, а это уже третья выборка.
Если вы нанимаете по тестовому заданию, самое дешёвое изменение здесь – добавить к нему один открытый вопрос о сделанном решении и задавать его без инструмента. Не для того, чтобы поймать кандидата на ИИ: сам факт использования модели о качестве решения ничего не говорит, и hh.ru в своём разборе найма аналитиков пришёл к тому же. Вопрос нужен, чтобы отличить человека, который понимает своё решение, от человека, у которого работает чужое.
За что компании платят и что получают
В сообществе CTO Craft на этой неделе разбирали компанию, которая тратит около миллиона долларов в месяц на ИИ-инструменты для двух с лишним тысяч сотрудников. Общие метрики не сдвинулись. При этом небольшое число команд показывает очень большой прирост, а многие команды с плохим результатом расходуют в десять раз больше токенов, чем успешные. Участники сошлись на том, что ИИ усиливает то, что уже есть: сильные команды становятся сильнее, слабые делают больше работы для других людей. Это разговор практиков, а не замер, и компанию никто не называет – но цифра расхода в десять раз при худшем результате стоит того, чтобы посмотреть на свои счета по командам, а не в сумме.
Там же прозвучало наблюдение, которое объясняет, куда девается прирост. Когда одна команда начинает работать быстрее, общий результат не меняется, если решения, передачи задач и согласования по-прежнему создают задержку. Один из участников показал, что команда, которая доводит один проект до конца перед тем как взять следующий, даёт втрое больше при тех же людях. Если завтра удвоить скорость инженеров, работа встанет в следующем месте, и у этого места обычно нет хозяина.
Счёт за непроверенную работу уже посчитали. ActiveState опросила больше 300 руководителей по безопасности, платформам и инженерии в компаниях от тысячи сотрудников в Северной Америке и Западной Европе: инженеры тратят минимум 139 часов в год – больше 17 рабочих дней – на переделку кода, который написал ИИ, и сами авторы называют эту оценку консервативной. Половина организаций признаёт, что новые зависимости попадают в продакшен без проверки. Опрос заказан компанией, которая продаёт управление зависимостями, так что интерес у неё прямой.
Linux Foundation в те же дни опубликовал исследование о генеративном ИИ в открытом коде. По их оценке около четверти новых pull request – запросов на внесение изменений в проект – это низкокачественный мусор, сделанный моделью. При этом 59% мейнтейнеров заметили рост вкладов с ИИ, а 71% согласны, что порог входа в проект стал ниже. Потенциал сокращения времени на написание кода авторы оценивают вдвое. Одна и та же технология открыла дверь новым людям и завалила мейнтейнеров работой по отсеву.
Что отличает команды, у которых получается, видно по двум рассказам изнутри. Продакт-менеджер Figma Эзра Мехабер описал PM OS – общий репозиторий из 31 навыка (skills) на базе Claude Code, собранный из его личной настройки. Сейчас им пользуются 60–70 продакт-менеджеров компании, и это репозиторий, а не купленный продукт: навык – текстовый файл с инструкцией, который команда правит и выбрасывает. Что здесь хорошего для менеджера: общий репозиторий превращает удачную личную находку в практику отдела, и стоит это ноль. Что плохого: такой файл выполняется с правами того, кто его запустил, а аудиты публичных реестров навыков в 2026 году находили сотни вредоносных – общий репозиторий нужно держать своим и просматривать правки.
Uber пошёл другим путём и раздал ChatGPT Work всем 30 тысячам сотрудников. В пилоте участвовала тысяча человек, и 80% из них не инженеры: финансы, операции, продукт. Отдельно компания на две недели прикрепила 30 ИИ-инженеров к разным командам с заданием автоматизировать куски их работы. Сколько это стоит, Uber не раскрывает, и как именно сотрудники будут этим пользоваться, в компании пока не решили – вице-президент по инженерии прямо говорит, что командам дают место для экспериментов.
И одна работа, которая объясняет, почему первая неделя важнее тренинга через полгода. Исследователи из Корнелла разобрали 140 тысяч чат-сессий примерно 8 тысяч пользователей и увидели, что манера работы с моделью складывается и закрепляется очень быстро, на первых же собственных попытках. Дальше человек почти не исследует: поле ввода ничем не ограничено, а пользуются им узко. Авторы называют это парадоксом свободы действий. Сколько именно времени есть у команды до того, как привычка затвердеет, по этим данным сказать нельзя – они показывают, что это происходит рано, но не дают срока.
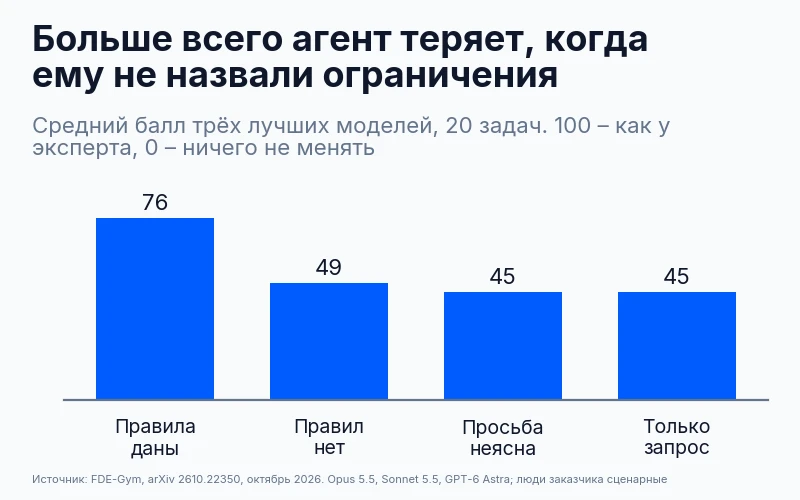
Из нашего разбора FDE-Gym: больше половины разницы в результате создаёт то, что написано в постановке задачи.
Что поменялось в инструментах
Начну с условий, потому что их никто не перечитывает. Сервис ClipJury перечитал страницы условий и тарифов 175 ИИ-инструментов трижды за 15 недель, каждый раз с датой. Изменилось что-то, влияющее на право продавать сделанное, у 105 инструментов из 175. Направление важнее количества: 31 пункт их оценки сместился в сторону большего риска для автора и 6 – в сторону меньшего. Пятнадцать сервисов ужесточили коммерческие права на бесплатном тарифе. У Lexica в июне бесплатные картинки можно было использовать коммерчески, а в октябре в условиях написано, что для этого нужен платный план; у Suno на бесплатном тарифе теперь «нет коммерческих прав». Два сервиса озвучки просто исчезли: LOVO ушёл в ликвидацию, домен play.ht больше не отвечает. ClipJury сам проверяет условия для своего рейтинга, и в этой же статье признаётся, что в 18 местах его собственные данные были неверны. Проверять свои инструменты всё равно придётся так же – перечитывая страницу.
Тарифы Claude переименовали: Max 5x стал Max за $100 в месяц, Max 20x – Ultra за $200, и на подтверждённом Ultra сняли пятичасовой лимит. Подписчики ChatGPT Pro и Business могут запросить до $500 в месяц кредитами на API. Для команды, которая уже платит за подписки, это повод посчитать, не покрывает ли подписка то, за что отдельно платят по API.
Открытых весов стало больше. Mistral выложила веса Mistral Large 4 – модель на триллион параметров, которую можно развернуть у себя; в их API она стоит $0,70 за миллион входных токенов и $2,10 за выходные. Moonshot выпустила Kimi K3.1 Pro и обещала полные веса не позднее 4 ноября. Тут легко обмануться, и про Kimi K3 об этом писали много: открытые веса не значит «развернём у себя» – модель такого размера требует стойку серверных GPU, а не сервер. Зато Kimi работает по карте «Мир» и без VPN, и для российской команды это сейчас редкость. В обратную сторону сходил Z.ai: флагманский GLM-5-Turbo стал полностью закрытым.
Google выпустила Gemini 4 Carbon по $2 и $10 за миллион токенов, и она возглавила Intelligence Index у Artificial Analysis. Пользоваться ей пока могут только специалисты по кибербезопасности. В нашем бенчмарке её нет, и приписывать ей место в нём я не буду.
У Cursor 12 ноября заканчивается доступ к моделям OpenAI – об этом мы писали в прошлом выпуске. Kilo на этом предлагает корпоративным клиентам Cursor свой Enterprise бесплатно до конца их контракта, максимум на 12 месяцев. Что здесь хорошего: если команда уже платит за Cursor и теряет модели, год без доплаты выглядит разумно. Что плохого: это перенос команды на другого поставщика ровно в тот момент, когда выбирать приходится быстро, а через год счёт придёт полный.
OpenAI предложила единый тег в robots.txt – файле, которым сайт объясняет роботам, что можно читать, – чтобы запрещать обучение на своём контенте отдельно от обычной индексации. Поддержали и другие провайдеры. Если у вашей компании есть сайт с собственными материалами, это одна строка, которую стоит обсудить с теми, кто им занимается.
С доступом из России у Anthropic, OpenAI и Google ничего не изменилось. Изменения цен и условий мы по-прежнему записываем в ленту хаба агентов.
K3.1 Pro и GLM-5-Turbo мы ещё не замеряли, в карточках стоят ближайшие проверенные версии. Открытая Kimi K3 у нас на втором месте из 47.
Что нового у нас
Мы пересобрали сайт. Для вас там изменились три вещи.
На странице программы появился выбор по ситуации: «Что из этого про вас?» – девять формулировок вида «пишу отчёты, которые никто не читает», и каждая ведёт к главам, где это разбирается. Раньше программа была списком глав, и выбрать по нему было нечего. Там же прямо написано, где достаточно бесплатных уроков, – отвечать на это письмом больше не нужно.
Отписка от рассылки больше не отбирает ничего, кроме рассылки. Письма со ссылкой для входа, подтверждения оплаты и уведомления об открытии новой главы приходят и после отписки, и отписавшийся студент спокойно заходит в курс. До этого отписка блокировала все письма сразу, а вход у нас по ссылке из письма – то есть человек, нажавший «отписаться», терял доступ к оплаченному курсу. Это была наша ошибка, мы её исправили.
Оплата и вход стали короче, а личные ссылки перестали утекать на сторону. Ссылка для входа и номер сертификата убираются из адреса страницы до того, как загрузится аналитика, и сама аналитика включается только после вашего согласия. Ещё появилась страница проверки сертификата по номеру, на русском и английском: теперь сертификат можно положить в резюме так, чтобы работодатель проверил его сам.
Идеи и ссылки
Anthropic подала документы на IPO и выйдет на Nasdaq под тикером ANT. Выручка за первое полугодие 2026 года – больше $16 млрд против примерно $4,5 млрд за весь 2025 год, чистый убыток – $80,7 млн против $13 млрд за тот же период годом раньше. Больше 11 900 клиентов заплатили за год свыше $100 тыс., около 250 – свыше $10 млн. Разбор Exponential View добавляет цифру, которая для планирования важнее всех остальных: больше 80% текущей выручки приносят модели не старше полугода. Компания, от модели которой зависит ваш процесс, живёт на том, что эта модель будет заменена. В списке рисков в проспекте, кстати, есть и потеря контроля над собственными моделями – это обязательный раздел, но читать его стоит.
Про агентную коммерцию много говорили на отчётах за квартал, и цифры пока не сходятся с разговорами. DoorDash на звонке с аналитиками назвал число заказов, пришедших от сторонних агентов, – несколько сотен за всё время, при трёх миллионах доставок в день. WIRED обошёл руководителей примерно 50 компаний из путешествий, связи, еды и хранения: T-Mobile – «ничего значимого», Hilton – «незначительно», фитнес-сеть Life Time – ноль отмен подписок через агентов, индийская Eternal – «близко к нулю». При этом Цукерберг на своём отчёте сказал, что Muse активировали больше 10 млн человек в США и Канаде и больше четверти пользовались им для покупок. Либо агенты покупают не там, где это измеряют, либо активация и покупка – очень разные вещи. Chipotle говорит, что агенты у них спотыкаются на оформлении заказа, и переделывает сайт под них.
Инженеров, которые пишут код, становится меньше со стороны входа: по данным National Student Clearinghouse, число студентов на Computer Science в США упало на 12,4% этой осенью после 7% годом раньше. Если вы планируете найм junior-разработчиков на три года вперёд, предложение будет уже.
Мартин Фаулер описал то, что сам называет «голосом LLM» – узнаваемую гладкость текста, которая у читателей вызывает отторжение независимо от содержания. Его совет авторам: не отдавать модели ни черновик, ни структуру текста. Совет спорный и его собственный, но для внутренних рассылок и писем клиентам проблема настоящая: текст, который читается как сгенерированный, обесценивает и то, что в нём написано.
Proton, сервис шифрованной почты, опубликовал разбор того, почему у них внедрение ИИ идёт медленно. Технологии там не при чём: страх, сопротивление, старые привычки и отсутствие общего подхода в команде. Публичное признание такого рода от компании, которая живёт на доверии к своей инженерии, встречается редко.
Установка инструмента claude-mem версии 15.2.0 и выше отправляла на сервер cmem.ai историю промптов пользователя за последние 30 дней без явного согласия и вопреки собственной политике конфиденциальности. Это одна строка в чьём-то npm-пакете, и именно так выглядит утечка переписки с моделью в обычной команде.
Новое в блоге
ИИ как экзоскелет: сотрудник справился, но не научился – разбор эксперимента BCG из первого раздела, с промптом, который проверяет, понимает ли сотрудник собранный с ИИ скрипт.
Оценки вверх, знания вниз: ИИ и 26 811 китайских школьников – 30 месяцев наблюдений, оценки за домашку вверх, закрытые экзамены вниз.
ИИ знает о риске, но промолчит – два исследования из Казахстана и России о том, как модель выполняет задачу и не говорит о рисках, о которых её не спросили, и одна строка в промпте, которая это меняет.
Почему ИИ-агент делает то, что просили, и не приносит пользы – пять проблем из FDE-Gym и что указать в постановке задачи до запуска.
Как читать ИИ-исследования: разбор статьи T-Tech о LIMe – какие вопросы задать любому ИИ-исследованию, на примере работы, которая обещает модели, которые быстрее учатся.
Возьмите одну задачу, которую у вас кто-то недавно «научился делать» с ИИ, и задайте по ней один открытый вопрос без инструмента: почему сделано именно так. Ответ на этот вопрос и есть та разница, которую все три работы из первого раздела меряют с разных сторон.
До 12 ноября платный трек «Проектное управление» стоит 13 600 ₽ вместо 17 000 ₽. В него входит «Фундамент», и там мы как раз учимся ставить задачу так, чтобы было видно, кто понял результат и кто за него отвечает.