Дайджест #27: как проверять работу, которую сделал не человек
Модели в выпуске – оценка в нашем бенчмарке
Эти две недели я готовил и читал доклад о том, как проверять работу, которую сделал не человек. Остальное в выпуске рядом: компании считают деньги на ИИ и учат сотрудников оценивать ситуацию и принимать решения, а экономисты спорят, почему молодым стало труднее находить работу.
В выпуске:
- Мой доклад на pmclub: статус проекта с заложенными ошибками, промпт из четырёх строк для проверки и почему модель лучше не переспрашивать «ты уверен?».
- Агенты работают всё больше, но большую часть сессии ждут ответа человека; PwC учит больше чем 85 000 сотрудников оценивать ситуацию и принимать решения.
- Счёт за ИИ: Anthropic раскрывает финансы перед IPO, токены дешевеют на 21% за месяц, Amazon – против токенных метрик.
- Молодые выпускники: кто дольше ищет работу и при чём тут удалёнка.
- Агентство вдвое срезало часы на типовую функцию, украденные ключи к моделям, Claude в таблицах и на встречах, агенты ставят уязвимые модули.
- В блоге – разбор доклада: что даёт каждая строка промпта и где потренироваться.
Уверенный, правдоподобный, неправильный
Так назывался доклад, с которым я 11 ноября выступил на онлайн-конференции pmclub upskill week – она шла 9–13 ноября и была про навыки менеджера на 2027 год. Речь про то, как проверять работу, которую сделал не человек. Запись – около 45 минут, с практикумом и вопросами.
{{< youtube id=“K51pR3r0yEk” >}}
Запись доклада на pmclub upskill week, 11 ноября.
Представьте вечер перед управляющим комитетом. Утром показывать статус проекта, а у вас открыты трекер, письма подрядчика и тестировщиков, таблица бюджета и результаты опроса пилотных пользователей. Вы отдаёте всё это ИИ – или руководитель проекта сделал это за вас – и через минуту на столе аккуратная презентация: ровные формулировки, проценты, уверенный тон. По ней комитет решит, запускать ли проект в срок. Остаётся один вопрос: можно ли её показывать как есть.
Под доклад я собрал такую ситуацию целиком. Проект вымышленный, «Pay 2.0» – подключение к платёжной системе банка, запуск 15 декабря, идёт спринт 14 из 16. Исходные данные написаны так, как они выглядят в живом проекте, а в презентацию, которую «сделал ИИ», мы заложили пять ошибок. Каждая звучит правдоподобно, и поймать её можно только сверкой с исходными данными:
- бюджет «освоен на 62%», хотя в октябре его увеличили до 12 млн и 6,2 из 12 – это 52%;
- «после интеграции остаётся запас», хотя интеграцию сдают 4 декабря, а QA просит на регрессию 10 рабочих дней;
- «пользователи пилота довольны» – по 9 анкетам из 120 разосланных;
- «остальные работы идут с опережением», хотя подрядчик писал «остальное по плану», а опережение модель добавила сама;
- в презентации нет четырёх открытых критичных багов – есть только три закрытых.
Пятая ошибка – самая опасная, и строки про неё в тексте нет вовсе: модель пропустила то, что должно было попасть в статус.
Проверку мы прогнали на 12 моделях, промпт рос по одной строке:
- «Проверь эту презентацию» – все пять ошибок нашли 57% ответов;
- плюс «сверь каждое утверждение с исходными данными» – 64%;
- плюс «отдельно перечисли, что важного не попало» – 73%;
- плюс «завтра комитет решает, запускать ли проект 15 декабря» – 88%.
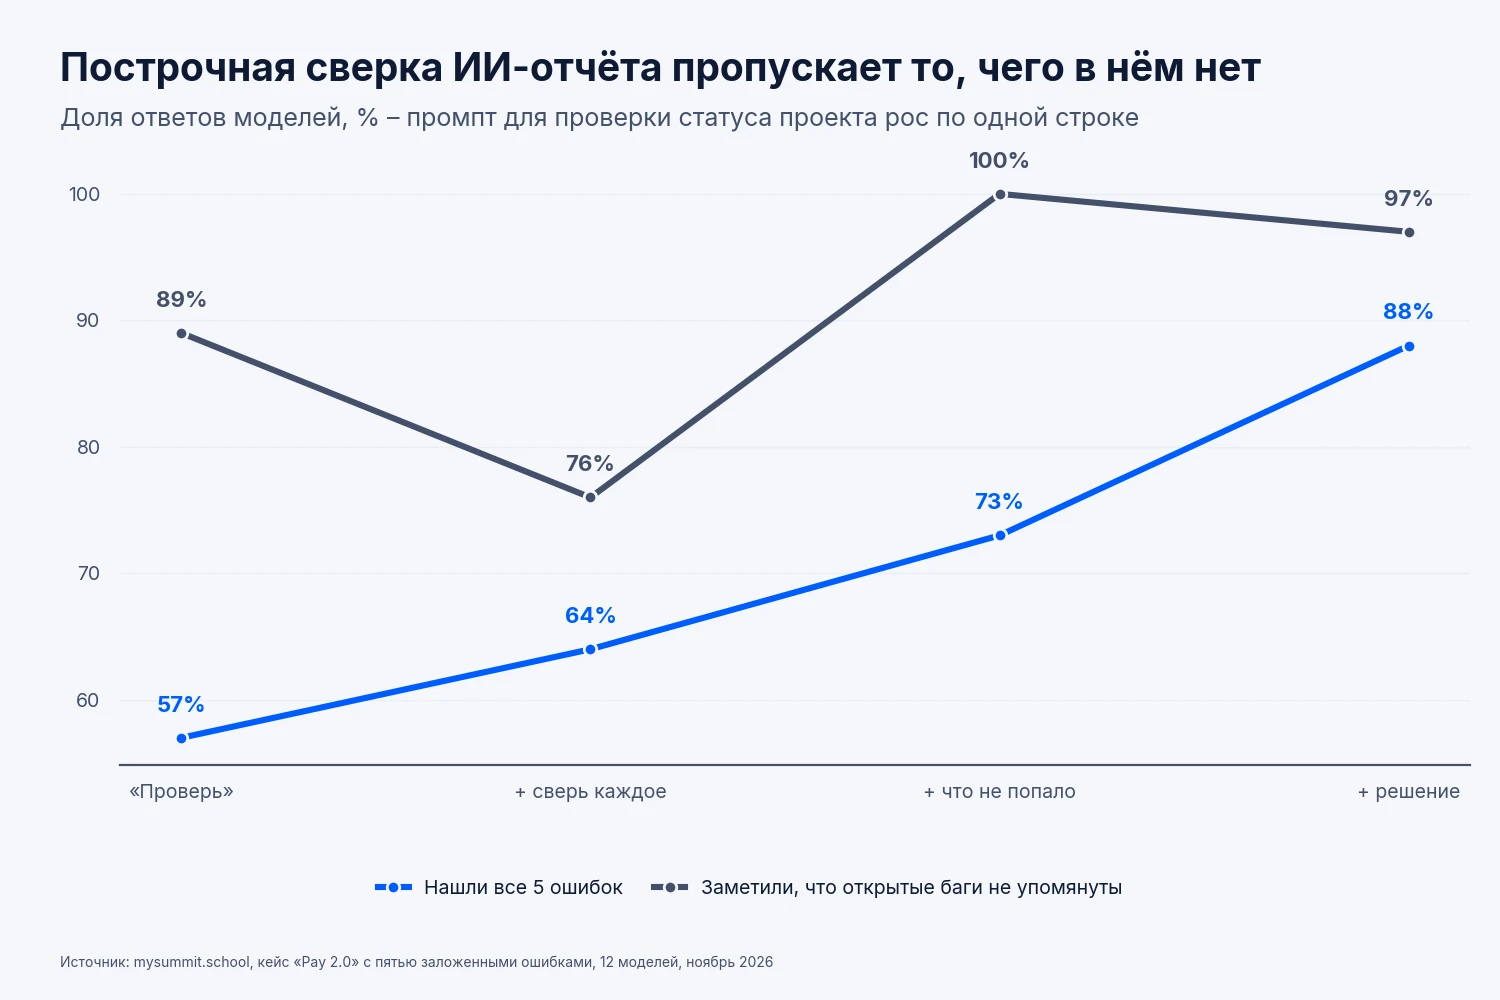
Каждая точка – промпт на одну строку длиннее предыдущего. Провал – на второй строке: модели старательнее сверяли текст и чаще пропускали баги.
Вторая строка выглядит самой правильной: сверь каждое утверждение с источником. Только пропуск багов модели после неё замечали реже, чем после простого «проверь», – 76% вместо 89%. Механизм прямой: модель сверяет то, что написано, а строки про открытые баги в презентации нет, сравнивать не с чем. А отдельная просьба «перечисли, чего не хватает» заставляла модели замечать пропуск в 100% ответов.
Сильнее всего сработала последняя строка. Когда модель знает, какое решение примут по документу, она сама понимает, что для этого решения важно, – и «запас после интеграции» перестаёт выглядеть правдой.
Модели очень разные. Claude Opus 5.5 и Claude Sonnet 5 находят все пять ошибок почти с любым промптом. Алиса – от одной до четырёх, GigaChat 3.5 – три-четыре. И слабым моделям та же построчная сверка вредит сильнее всего: Алиса с ней находила в среднем одну ошибку из пяти.
На сцене, кстати, получился живой демо-эффект – не тот, что я планировал. Я запустил собранный большой промпт вживую, и самая маленькая GPT-5.4 nano и Алиса с ним не справились, хотя накануне он работал почти везде. Один живой прогон – одна попытка из многих, разброс у слабых моделей большой; как это выглядело на сцене, видно в записи.
Тот же кейс открыт как практикум на 10 минут: отметить строки, которые нельзя показывать комитету как есть, а затем запустить свой или готовый промпт на моделях.
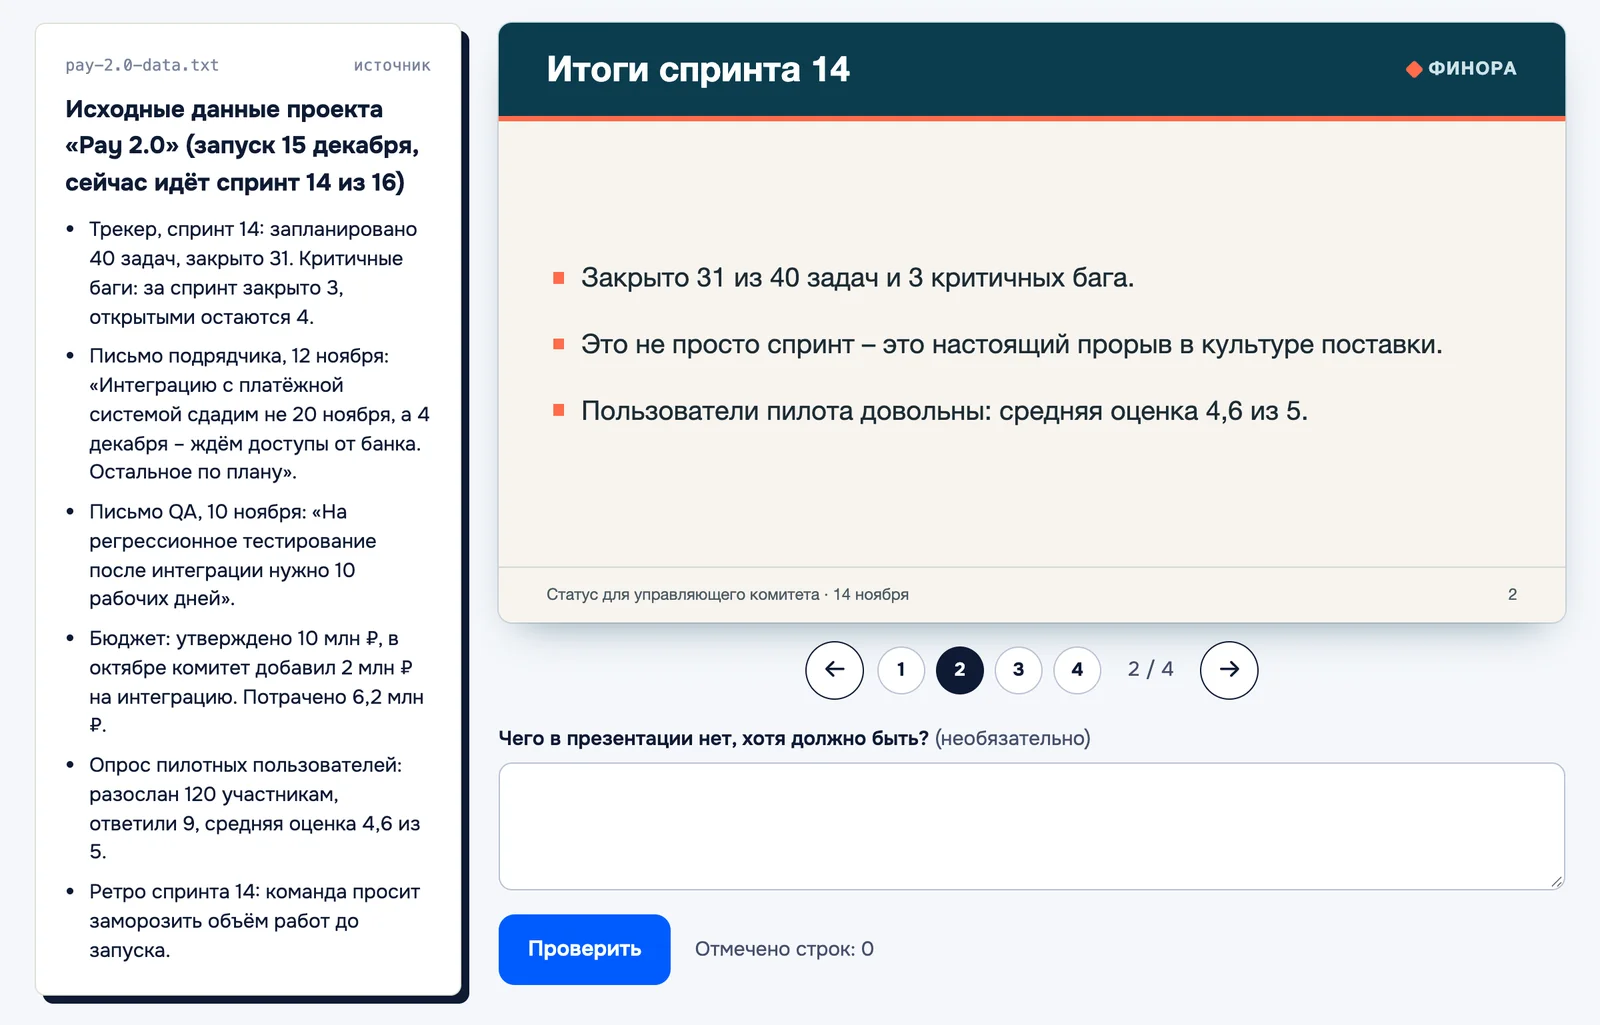
Слева – то, что знает руководитель проекта, справа – слайд, который собрал ИИ. Закрытые баги на месте, открытых нет.
В зале практикум прошли 18 человек. Все четыре ошибки, которые видны в тексте, нашли четверо, всех пяти – никто. Труднее всего оказался пропуск: строки про открытые баги на слайдах нет, кликнуть нечего, и написать о нём в отдельном поле догадались трое.
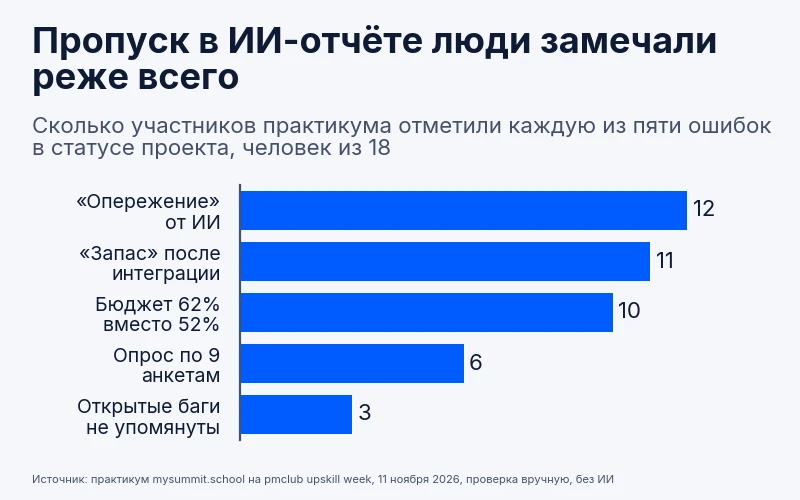
Проверка вручную, без ИИ. Четыре ошибки можно было отметить кликом, пропуск – только описать словами.
Отдельно – про самый популярный способ проверки: переспросить. Так лучше не делать. В нашем исследовании на 18 моделях «ты уверен?» без новых фактов в среднем в 8% прогонов заставляло модель поменять верный ответ на неверный; у самой уступчивой модели таких прогонов было 36%. Этот фрагмент можно посмотреть отдельно.
Если времени на всю запись нет, начните с части о том, как проверять и не тратить на это весь день. Полный разбор доклада с шаблоном промпта и цифрами по каждой строке – в статье в блоге.
Самая опасная ошибка в этом кейсе была отсутствием строки. Надёжнее всего её находила одна просьба: «перечисли, чего здесь не хватает». Этот вопрос стоит задавать любому слишком гладкому документу – кто бы его ни написал.
→ Посмотреть доклад: как проверять работу, которую сделал не человек
Конференцию проводили наши друзья из pmclub. Дмитрий и Валерия Ильенковы с 2015 года помогают менеджерам развивать навыки управления проектами и продуктом: от бесплатного «Проджект менеджмент 101» до курса с международным сертификатом P3.express. Для читателей рассылки они поделились промокодом: BELYAEV даёт скидку 20% на все курсы pmclub.
Агенты ждут человека
В докладе я разбирал проверку работы ИИ. В Anthropic описали другую трудность: агенты большую часть интерактивной сессии ждут ответа человека. 16 октября экономисты компании выпустили отчёт How employment is changing at Anthropic – внутренние данные по найму, телеметрия агентов, опросы и календари плюс 17 интервью с сотрудниками.
Уже в марте часы работы агентов впервые превысили часы людей. К августу разрыв вырос: в интерактивных сессиях – там, где человек ставит задачи агенту и ждёт результата, – агенты отработали в 6 раз больше часов, чем направлявшие их сотрудники.
В отчёте есть повторяющаяся фраза: «внимание человека – постоянное узкое место». Около 80% времени интерактивной сессии агент простаивает – ждёт ответа человека. Один из инженеров сформулировал ещё прямее: люди «тормозят агентов».
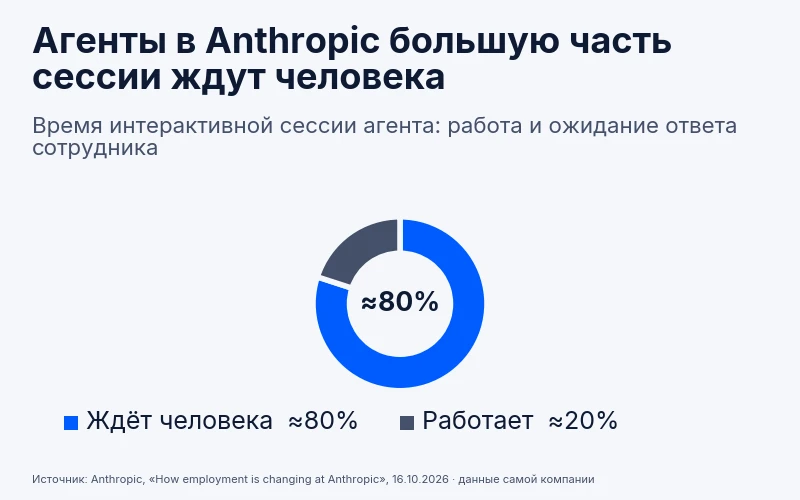
Телеметрия самой Anthropic: на сессии с человеком агент по большей части ждёт ответа.
Просто прочитать весь вывод агентов из интерактивных сессий заняло бы половину рабочей недели даже у нетехнического сотрудника. Меня здесь интересует, как сотрудники успевают проверять такой объём результатов.
Оговорки встроены в сами цифры. Часы агента – время работы программы, а не результат. Часы людей считали как штат × 40 часов, так что сравнение не один к одному. И Anthropic продаёт тех самых агентов, которых меряет, – об этом стоит помнить с любым числом из отчёта.
PwC объявила программу сертификации «Critical Thinking & Judgment» для более чем 85 000 сотрудников – будет развивать критическое мышление и навыки принятия решений: старт в декабре, около шести месяцев занятий, завершение к концу финансового года, в июне 2027-го. Сначала у сотрудника оценят стиль мышления, затем занятия с профессорами и опытными коллегами и симуляции, а в конце – персональный ИИ-коуч. Уровень оценят в годовом ревью, экзамена «сдал/не сдал» нет.
Повод называют прямо: рутинные задачи, на которых начинающие сотрудники раньше учились принимать решения, теперь выполняет ИИ. Детали Business Insider узнал у chief people officer PwC US – руководителя HR американского подразделения. Пока это только объявление: программа не началась, и результатов нет.
Счёт за ИИ
Anthropic готовится к IPO – в прошлом выпуске мы разбирали её первый проспект, а в обновлённой версии S-1/A от 10 ноября появился III квартал. Выручка – почти 17 млрд долларов: во II квартале было 11,6 млрд, а год назад – 1,4 млрд.
Во II квартале – около 1 млрд долларов операционной прибыли, в III – операционный убыток 567 млн. Компания объясняет его двумя строками: 5 млрд долларов расходов на вычисления по краткосрочным контрактам и 2 млрд неденежных расходов на программу пожертвований. Вычисления съедают всё большую долю выручки: 48% во II квартале, 58% в III. Из-за снижения цен в новых версиях моделей и скидок по контрактам Anthropic недополучила за квартал ещё около 600 млн долларов выручки.
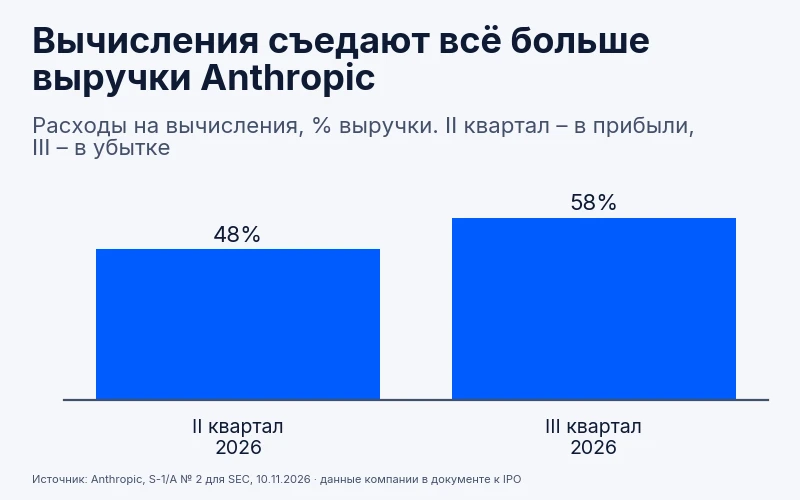
Вычисления – больше половины выручки: за один квартал Anthropic прошла путь от прибыли до убытка.
В документе есть и деталь про собственные траты Anthropic. Если оценивать внутреннее использование Claude по прейскуранту, его стоимость с января по сентябрь 2026 года выросла более чем в 250 раз. В апреле месячная стоимость впервые превысила месячные расходы на персонал – без учёта опционов. Это оценка по списочным ценам, а не деньги, которые компания реально потратила.
Оговорка у всех этих цифр общая: они из документа, чья задача – продать акции, и прошёл ли квартал аудит, я не проверял. Сколько в объяснении убытка бухгалтерии, а сколько экономики, станет понятно только позже.
Токены дешевеют. За корпоративными тратами со стороны следит Ramp – сервис корпоративных карт и счетов, чей экономист Ара Харазян выпускает AI Index. Октябрьский выпуск зафиксировал два месяца подряд – август и сентябрь, – когда траты на токены почти не росли, хотя объём токенов рос. Ноябрьский добавляет: в октябре траты выросли на 1,65%, а цена за миллион токенов за месяц упала на 21%.
Разброс трат огромный: медианная компания платит 16,32 доллара на сотрудника в месяц, верхние 10% – 801 доллар, верхний 1% – около 10 тысяч. Только выборка кривая: компании сами подключают продукт Ramp для учёта расходов, а оценку верхнего 1% сам Ramp называет неустойчивой.
Amazon высказался про метрики: в открытом письме инженерного руководства от 27 октября (автор – Терк Терковиц) потраченные токены и доля использования ИИ-инструментов названы «глубоко ущербными» и «оторванными от того, что важно»: когда из них делают цель, расходы растут. Погоня за объёмом токенов – письмо называет её «токенмаксингом» – «противоречит бережливости». Совет – мерить долгосрочный результат и смотреть на два края: на 10-й процентиль, где ИИ не прижился, и на 90-й, самый активный, – стали ли эти сотрудники выполнять больше полезной работы. Если ИИ не помогает в работе, «это находка, а не провал». Важная тонкость: письмо признаёт, что такие метрики хорошо коррелируют с результатом, и предостерегает ровно от одного – делать их целью.
Снизить расходы можно и за счёт настройки глубины размышления (reasoning effort), которая задаёт, как долго модель думает перед ответом. Vals AI измерила, как при этом меняется результат. На минимальной глубине семь моделей сохраняли от 77% до 99% результата, полученного на максимальной. Затраты составляли от 16% до 84% стоимости работы на максимальной глубине.
Четыре из семи моделей сохраняли не меньше 80% результата при затратах как минимум вдвое ниже. Claude Opus 5.5 сохранял 80% результата при 16% стоимости. У Grok 4.7 – 86% результата при тех же 16% стоимости. Оговорка: мерили на половине задач и по прейскуранту.
На мой взгляд, по расходам на токены нельзя судить о пользе ИИ для команды. Менеджеру нужно отдельно оценивать, какие задачи команда решила с помощью ИИ.
Кто дольше ищет работу
Молодые специалисты – сквозная история последних выпусков: в #24 – данные Стэнфорда о том, что после внедрения ИИ компании активнее нанимают старших, в прошлом выпуске – набор на computer science продолжает падать. Этой осенью вышли две работы о том, кто именно дольше ищет работу, и смотрят они с разных сторон.
Эрни Тедески, экономист Stripe Economics – исследовательского проекта платёжной компании Stripe, – взял данные по американцам 22–26 лет с дипломом бакалавра. В сентябре 2026 года работали 88% из них – на пункт ниже, чем три года назад. Безработица к концу 2025 года поднялась примерно до 6%; до пандемии держалась около 4%. Типичный безработный выпускник ищет работу 12 недель – на треть дольше, чем несколько лет назад.
Исследователь сравнил, как менялась занятость молодых и людей 30–49 лет в каждой профессии и в каждом из девяти регионов США. Затем сопоставил разницу с долей удалёнки в профессии и с тем, насколько профессия подвержена ИИ.
На первый план вышла удалёнка. Где её доля выше на 10 процентных пунктов, занятость молодых росла на 3,9–6,6 пункта медленнее, чем у людей в середине карьеры. Подверженность ИИ тоже связана с замедлением, только связь слабее и статистически неотличима от нуля. При одновременном учёте обоих факторов статистически значимой оставалась только связь с удалёнкой. А в отраслях, где ИИ внедрили активнее, занятость молодых росла даже чуть быстрее – правда, тоже незначимо.
Тедески подчёркивает: исследование позволяет предположить связь, но не доказывает, что именно удалёнка ухудшила положение выпускников. Удалёнка и подверженность ИИ сильно связаны между собой, ставки и миграцию не проверяли, эффект ИИ может проявиться только в следующую рецессию. А в комментариях к разбору я встретил такое возражение: пик удалёнки пришёлся на 2020–2022 годы, а пик занятости выпускников – на 2023-й. Если ломает найм именно удалёнка, почему слом не случился на её пике – ответа у меня нет.
Goldman Sachs смотрит с другой стороны – со стороны увольнений. Экономист Пьерфранческо Мэй подготовил записку для клиентов; сама записка закрыта, её пересказывает Fortune. Те, кто потерял работу в 2023–2025 годах на позициях, сильно подверженных ИИ, искали новую примерно на месяц дольше и примерно на 10 процентных пунктов чаще оставались без работы через год. Возвращение к полной занятости у работников 35 лет и старше занимало примерно на 5 недель дольше обычного, у более молодых – примерно на 3.
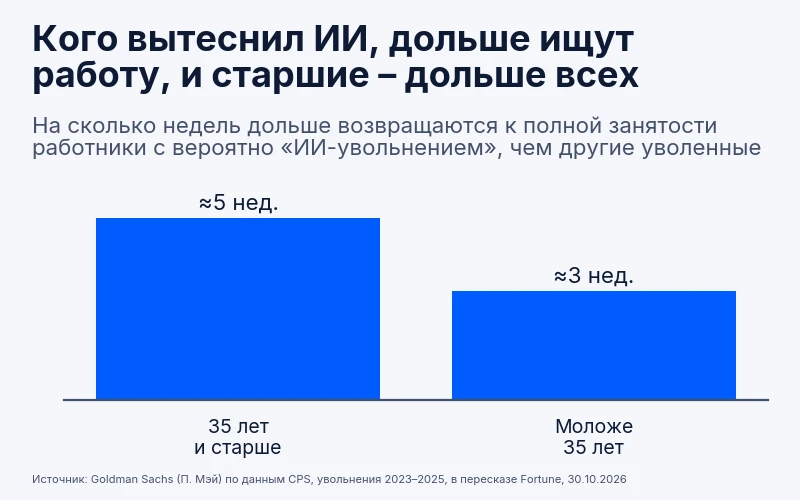
Оценка Goldman Sachs по опросу больше чем 15 тысяч уволенных: при увольнении, вероятно связанном с ИИ, возвращение к полной занятости занимает больше времени – и у старших, и у более молодых.
Прямого вопроса «вас уволили из-за ИИ?» в опросе не было – банк строил оценку по подверженности профессии, внедрению ИИ в отрасли и упразднению должности. Для увольнений до 2023 года разница не проявлялась. Мэй сравнивает масштаб с прошлыми технологическими волнами: вред от них держался долго.
Anthropic в том же отчёте от 16 октября отдельно описывает найм начинающих специалистов внутри компании. В данных Goldman Sachs речь шла о возрасте; здесь сотрудников делят по опыту. Доля начинающих сотрудников среди нанятых в технические отделы упала с 27% до 9% с начала 2025 года, их доля в штате технических отделов – с 21% до 14%. Около трети руководителей направлений машинного обучения и пятая часть руководителей разработки сказали, что из-за ИИ нанимают меньше.
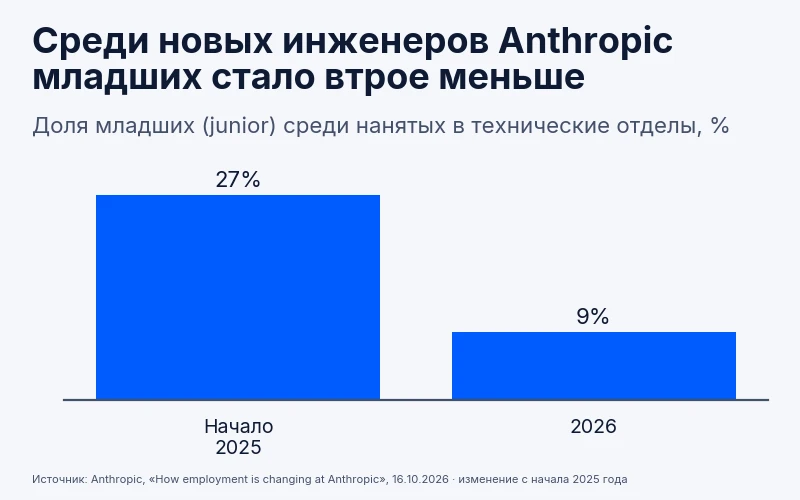
Данные найма самой Anthropic: доля начинающих среди новых технических сотрудников упала с примерно четверти до примерно одной десятой.
По этим данным я не могу сказать, какую роль в трудностях молодых специалистов играют удалёнка и ИИ. Снижение найма начинающих сотрудников в Anthropic само по себе этого вопроса не решает.
Идеи и ссылки
Сколько часов агентство закладывает в смету с ИИ. Руководитель агентства мобильной и веб-разработки Сергей Никоненко разобрал свои сметы и данные Jira и GitLab: медиана оценки типовой функции авторизации – 124 часа в 2025 году (12 смет) и 56 часов в 2026-м (19 смет), примерно в 2,2 раза меньше. Ставки почти не изменились: медиана 3 900 и 3 600 ₽ в час. На два веб-проекта, которые с первого дня делали с ИИ, потратили в 2,5–3 раза меньше, чем предусматривали прежние бюджеты. В ещё одном проекте использование ИИ учли уже в смете, и фактические расходы совпали с планом. Оговорки самого автора: проекты не случайные, считались часы разработки без менеджмента, стоимость поддержки не мерили. Для менеджера: если подрядчик до сих пор ставит прошлогодние часы на типовые задачи, есть о чём спросить.
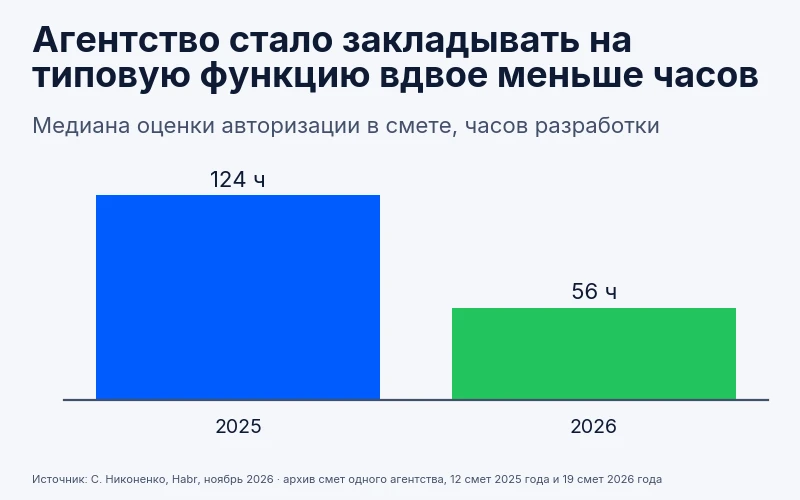
Сметы одного агентства на одну типовую задачу с разницей в год: часов заметно меньше, ставка на месте.
Украденные ключи к ИИ. Mandiant из Google Threat Intelligence 2 ноября описала схему LLMjacking: злоумышленники крадут облачные учётные данные и ключи API – в том числе выложенные в публичных репозиториях, – проверяют ключ крошечным запросом и перепродают доступ через нелегальные шлюзы. У отдельных организаций мошеннические списания превысили 100 тысяч долларов за один день и дошли до 1 млн в сумме – пока доступ не отозвали. Что советуют: лимиты трат и квоты на каждую модель, ключи с узкими правами под модель и окружение, ротация ключей, поиск «теневого» использования ИИ. Лимит расходов на ключ здесь оказывается вопросом бюджета, а не только безопасности.
GitHub Copilot 14 декабря уберёт часть моделей – список в changelog: Claude Fable 5 (замена – Fable 5.2), Claude Haiku 4.5 (замена – Haiku 5.5; у индивидуальных подписчиков с годовым планом Haiku 4.5 останется), Gemini 3.8 Flash и Gemini 4 Argon, Grok 4.6, Kimi K3 (замену пока не назвали). У замены есть тонкость: Fable 5.2 в Copilot по умолчанию требует хранения данных у Anthropic – промпты и ответы сохраняются для фильтров безопасности и не идут на обучение; в Business и Enterprise модель включает администратор, и этим он соглашается с хранением. Если у команды есть правила про хранение данных, переход на замену – вопрос сначала к юристам.
Claude переехал в таблицы и на встречи. 10 ноября Anthropic открыла бету Claude Sheets и Whiteboards, а дашборды вышли из беты под названием Claude Data – на всех платных планах. 12 ноября – бета Claude Meetings для планов Team и Enterprise, пока только Google Meet: модель сохраняет расшифровку, итоги и описание экрана, без аудио, и по умолчанию не заходит на встречи с внешними гостями. Документы и доски, созданные во время встречи, бесплатны до 10 февраля 2027 года. Что плохо: инструменты недоступны организациям с нулевым хранением данных – режимом, при котором вендор вообще не хранит ваши данные, – и встречи есть только на командных планах. Для менеджера: ИИ, который сидит на каждой встрече, стоит согласовать с командой и с клиентами до того, как администратор его включит.
Агенты ставят устаревшие MCP-серверы. Glow Labs посмотрела, как агенты для кодинга – Claude Code, Cursor, Codex CLI и другие, – устанавливают MCP-серверы, подключаемые модули, через которые агент работает с внешним сервисом: когда агент устанавливал устаревший сервер, в 98% случаев он выбирал его на основе обучающих данных модели; пользователь этот сервер не запрашивал. 13 из 20 исходных серверов Anthropic уже в архиве. Четыре серьёзные уязвимости, найденные в них, исправлять не будут. Совет: один утверждённый сервер на каждый сервис и проверка статуса перед утверждением. Оговорка: Glow продаёт продукт для безопасности и не назвала, на скольких сессиях посчитаны 98%.
Новое в блоге
Как проверить ответ нейросети: промпт, который ловит ошибки – разбор доклада: промпт из четырёх строк с цифрами по каждой, тот же практикум и объяснение, почему «ты уверен?» портит верные ответы.
До следующего выпуска – один эксперимент. Возьмите документ, который пришёл слишком гладким: статус, смету, анализ. Дайте его модели вместе с исходными данными и попросите отдельно: перечисли, чего важного здесь не хватает.
В «Фундаменте» есть глава о критическом мышлении и ограничениях ИИ – типы ошибок моделей и быстрая проверка любого ответа: цены и состав.